8.3 性能与成本优化实践
8.3 性能与成本优化实践
本节摘要:性能与成本不是跷跷板,而是同一本账的两个科目。本节给出三件核算工具——冷热分层让存储费用跟着数据价值走、压缩编码让同一份数据付更少的字节税、缓存复用让一次计算被多次消费——外加一套把"快"折算成钱的方法论。读完你应当能在成本评审会上,把每一条优化主张都报出可验证的数字。
读完你应当能够
阅读完本节,你应当能够:
- 按访问热度为一张大表设计分层策略并核算存储费用的降幅;
- 为不同数据形态的列选择编码与压缩组合,平衡压缩比与扫描开销;
- 用缓存命中率与计算成本核算复用收益;
- 建立单位查询成本的月度核算机制,让优化效果对账可见。
一、先建账本:把钱折算成可优化的科目
优化之前先统一度量。数据仓库的月度总成本大致拆成三个科目:存储科目(容量乘以介质单价,副本数是隐藏乘数)、计算科目(CPU 与内存的规格乘以规模)、人力科目(值班与治理的工时,最常被忽略也最贵)。所有优化手段都能映射到科目上:分区归档与副本策略作用于存储科目,参数调优与缓存作用于计算科目,自动化与制度作用于人力科目。没有这个映射,"优化"就退化成"感觉服务器还能再压一压"。
性能侧的对应科目是单位查询成本:月度计算科目总额除以当月有效查询量。它把"快"和"省"焊在同一根标尺上——一条语句既慢又贵(扫全表算小口径),一条语句又快又便宜(命中预聚合),优化的目标就是让高频查询整体向后者迁移。第 5 章的所有调优手段,在财务视角下全是压低单位查询成本的动作。
二、冷热分层:让存储费用跟着价值走
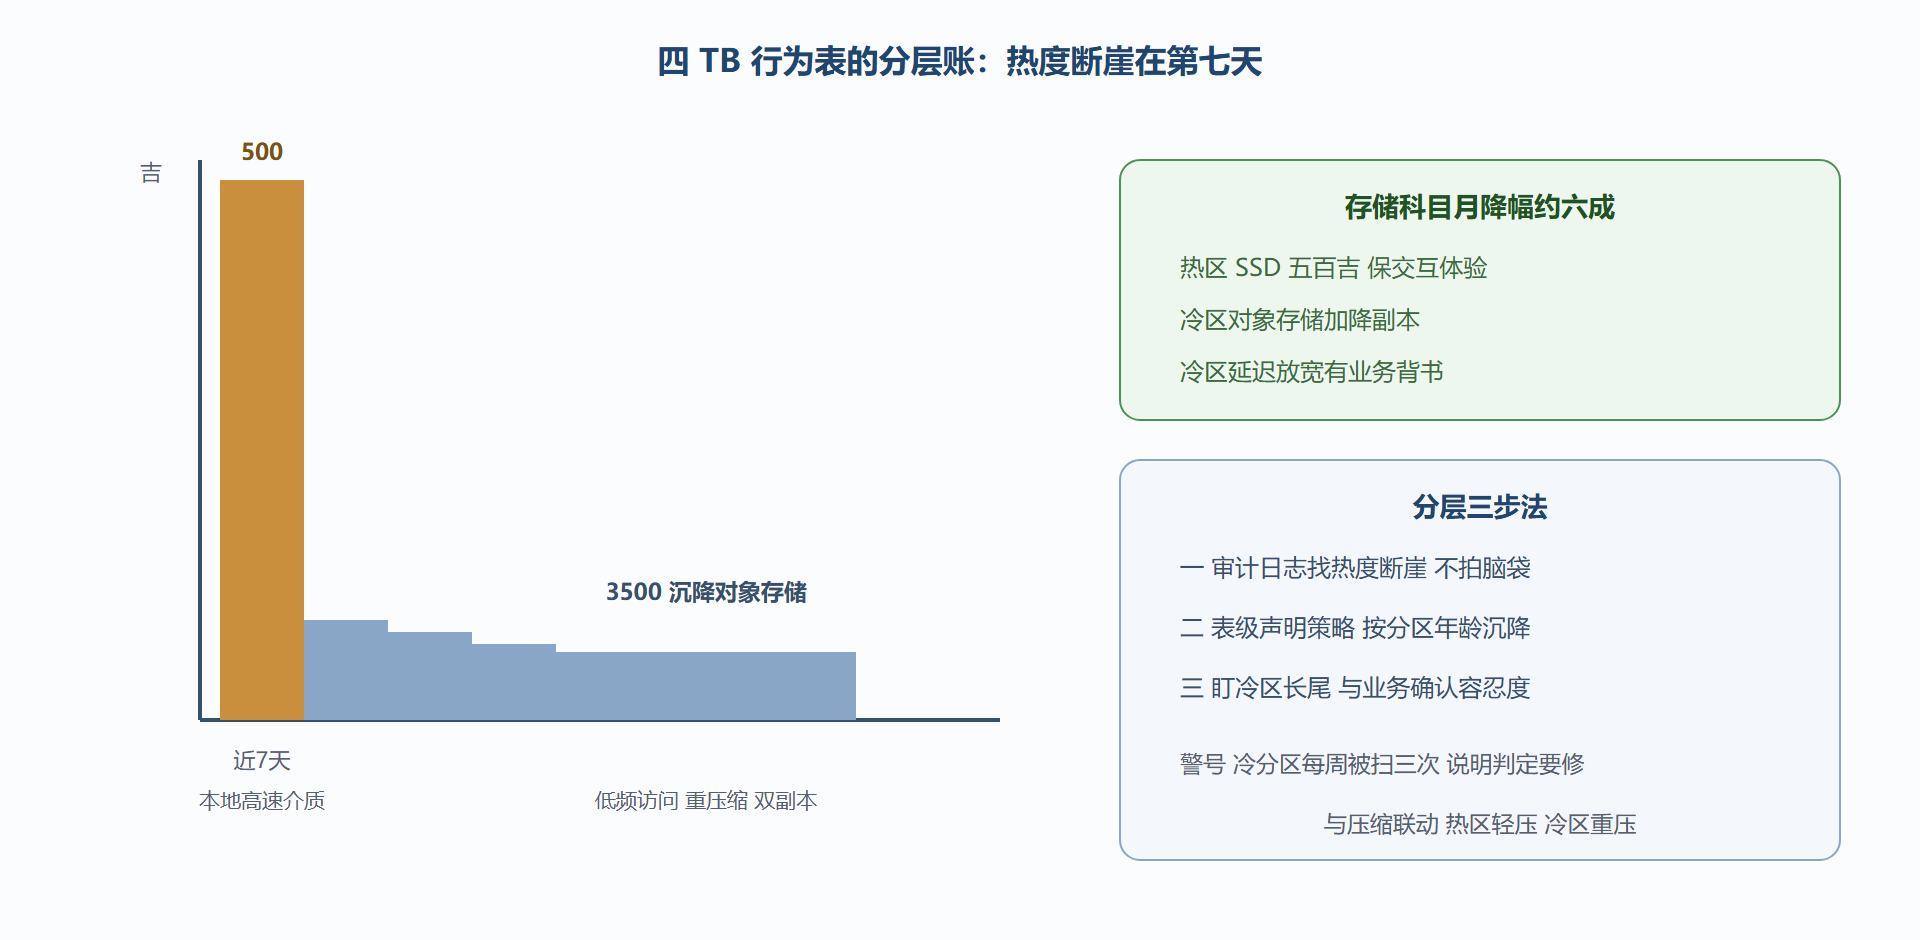
存储科目里最大的浪费是"用热介质的价格存冷数据"。一张行为明细表,最近七天贡献九成查询量,九十天的留存期意味着八成多的数据躺在昂贵介质上一年到头没人看。分层的经济逻辑就是切走这八成:热数据留本地高速介质保交互体验,冷数据沉到对象存储——容量单价常相差数倍,且冷层通常还能省掉副本冗余的乘数。
落地按三步走。第一步定边界:用审计日志统计各分区的真实访问频次,找出热度断崖——数据自己会告诉你分界线在哪天,拍脑袋定的"三十天热"经常与事实差出一倍。第二步配策略:表级声明分层规则,按分区年龄自动沉降,代码层面就是给表挂上存储策略并绑定降温动作;沉降过程对查询透明,SQL 语义不变,只是冷分区的扫描延迟会台阶式上升。第三步验体验:盯住冷区查询的长尾延迟,与业务方确认月度复盘类查询的容忍度——分层的前提是冷查询确实低频,若发现某"冷"分区每周被扫三次,说明热度判定该修正而不是硬扛延迟。
-- 为表绑定分层策略 近期分区本地盘 历史沉降对象存储 CREATE TABLE dwd_user_event ( ... ) ... PROPERTIES ( "storage_policy" = "policy_hot_cold", "partition_live_number" = "90" );
收益核算举一条实测口径:四 TB 有效数据的行为表,七天热区五百吉本地 SSD,其余沉对象存储,副本策略冷区降为双副本——存储科目月降幅约六成,热区查询体验零变化,冷区聚合查询延迟从亚秒放宽到数秒,业务方确认可接受。这份账能立住的关键是"冷区延迟有业务背书",数字再好看,业务方不认就不算数。
三、压缩编码:字节税的精算
计算科目里有一笔隐性支出叫字节税:扫描要读字节、网络要传字节、内存要装字节,压缩是唯一同时给三项打折的手段。列式存储给了压缩天然优势——同列数据类型一致、取值聚集,按列编码的压缩比远超按行压缩。策略层面是"一列一策":时间戳与自增类列用差值编码收益极高(相邻值差异微小);低基数枚举列走字典编码,把字符串换成整型再压;大文本列才动用高压缩比算法,用解压开销换容量。
取舍的标尺是扫描频率:高频扫描的列宁可选解压快的轻压缩——压缩省下的 IO 要与解压多耗的 CPU 放在天平两端,热表上 CPU 往往是更贵的一端;低频访问的归档区则放心用高压缩比,反正解压机会稀少。这套判断与冷热分层天然联动:热区轻压缩、冷区重压缩,两层策略叠加后存储科目的账面还会再降一档。
图 8-3:一张大表的分层沉降与费用曲线
四、缓存复用:一次计算多次消费
计算科目还有一笔可观的浪费是重复劳动:同一条大盘查询每天被执行上千次,每次都从头扫描计算。缓存体系让结果被复用——执行计划缓存省去重复的解析与代价估算,结果缓存让相同参数的查询直接取现成答案,分区级的结果粒度还允许"华东部分复用、华北现算"的拼装命中。收益核算的口径是缓存命中率乘以单次计算成本:命中一次省下的就是一次扫描加聚合的 CPU 与 IO,命中率与单次成本相乘,就是这项配置每月的实际贡献。
失效纪律是缓存的另一面:底表数据变更要能作废相关缓存,否则省下的钱会变成对不上账的报表。导入完成后的缓存清理动作纳入 4.3 的任务编排(前文已有约定),让"新数据进来"与"旧缓存出去"成为同一个事务的两半。物化视图与结果缓存的分工在 6.1 已划过界——固定口径走视图,重叠即席走缓存,两层叠加覆盖大部分重复计算场景。
五、一次成本专项的全过程
背景:某平台数据团队季度账单环比上涨四成,管理层要求一个月内给出可控方案。核算发现三个科目里存储涨两成(业务增长合理部分约占一半)、计算涨六成(异常)、人力持平——主攻方向锁定计算科目。
操作:先做查询画像,把当月计算量按语句形态归组,发现三成计算量来自一条失控的即席查询模板(无分区过滤的全表扫描,业务侧脚本循环调用)——这是第 5 章"免费午餐清单"里第一课的现实版;随后实施三件套:失控模板加分区过滤并限流、两张核心大表按热度断崖分层、高频看板接入结果缓存并绑定失效规则。
结果:两个月后计算科目回落两成八,单位查询成本下降三成五,存储科目滞后一个季度开始受益于分层沉降。全程零硬件采购,业务侧唯一感知是那条失控脚本的响应从"能跑出来"变成"必须带日期范围"。
解读:这个专项的复盘价值在于顺序——先建账本科目,再找异常大户,最后才动架构级手段(分层)。多数团队的反向操作是上来就讨论"要不要换存储介质",把力气花在零头科目上。变式思考:若账本显示人力科目是大头,答案完全不同——该投入的是自动化与治理工具,任何硬件优化都替代不了三个全职人力背后的治理欠账。
交接一句
把这本账留给你:三科目建总账,单位查询成本定标尺,冷热分层动存储,压缩编码省字节,缓存复用降计算——五个动作按此顺序铺开,每季度复盘一轮科目变化。成本优化不是一次性项目,是随业务曲线持续校准的常设机制,账本在,机制就在。
本节要点回顾
- 三个科目建总账:存储、计算、人力,一切优化映射到科目才可对账。
- 单位查询成本焊住快与省:高频查询向又快又便宜的形态迁移。
- 分层跟着热度断崖走:审计数据定边界,冷区延迟要业务背书。
- 压缩按扫描频率取舍:热列轻压冷列重压,字节税与解压税放上天平。
- 专项顺序不可倒:建账、找大户、再动架构,先问人力再看硬件。
至此全册走完。回看第 1 章那个选型评审会上的问题——凭什么选它——你已经拥有了从拍板到兜底的完整答案。