2.1 内存结构
2.1 内存结构
本节摘要:Oracle 把内存分成"大家共享的 SGA"与"各会话私有的 PGA"两个世界:SGA 里共享池管解析、缓冲缓存管数据块、重做缓冲管日志;PGA 管排序、哈希与游标。内存配比失衡与共享池碎片化,是生产环境半数性能事故的源头。本节沿一次 ORA-04031 报错的处置,把两个世界的结构与调法讲透。
一、为什么内存要分家
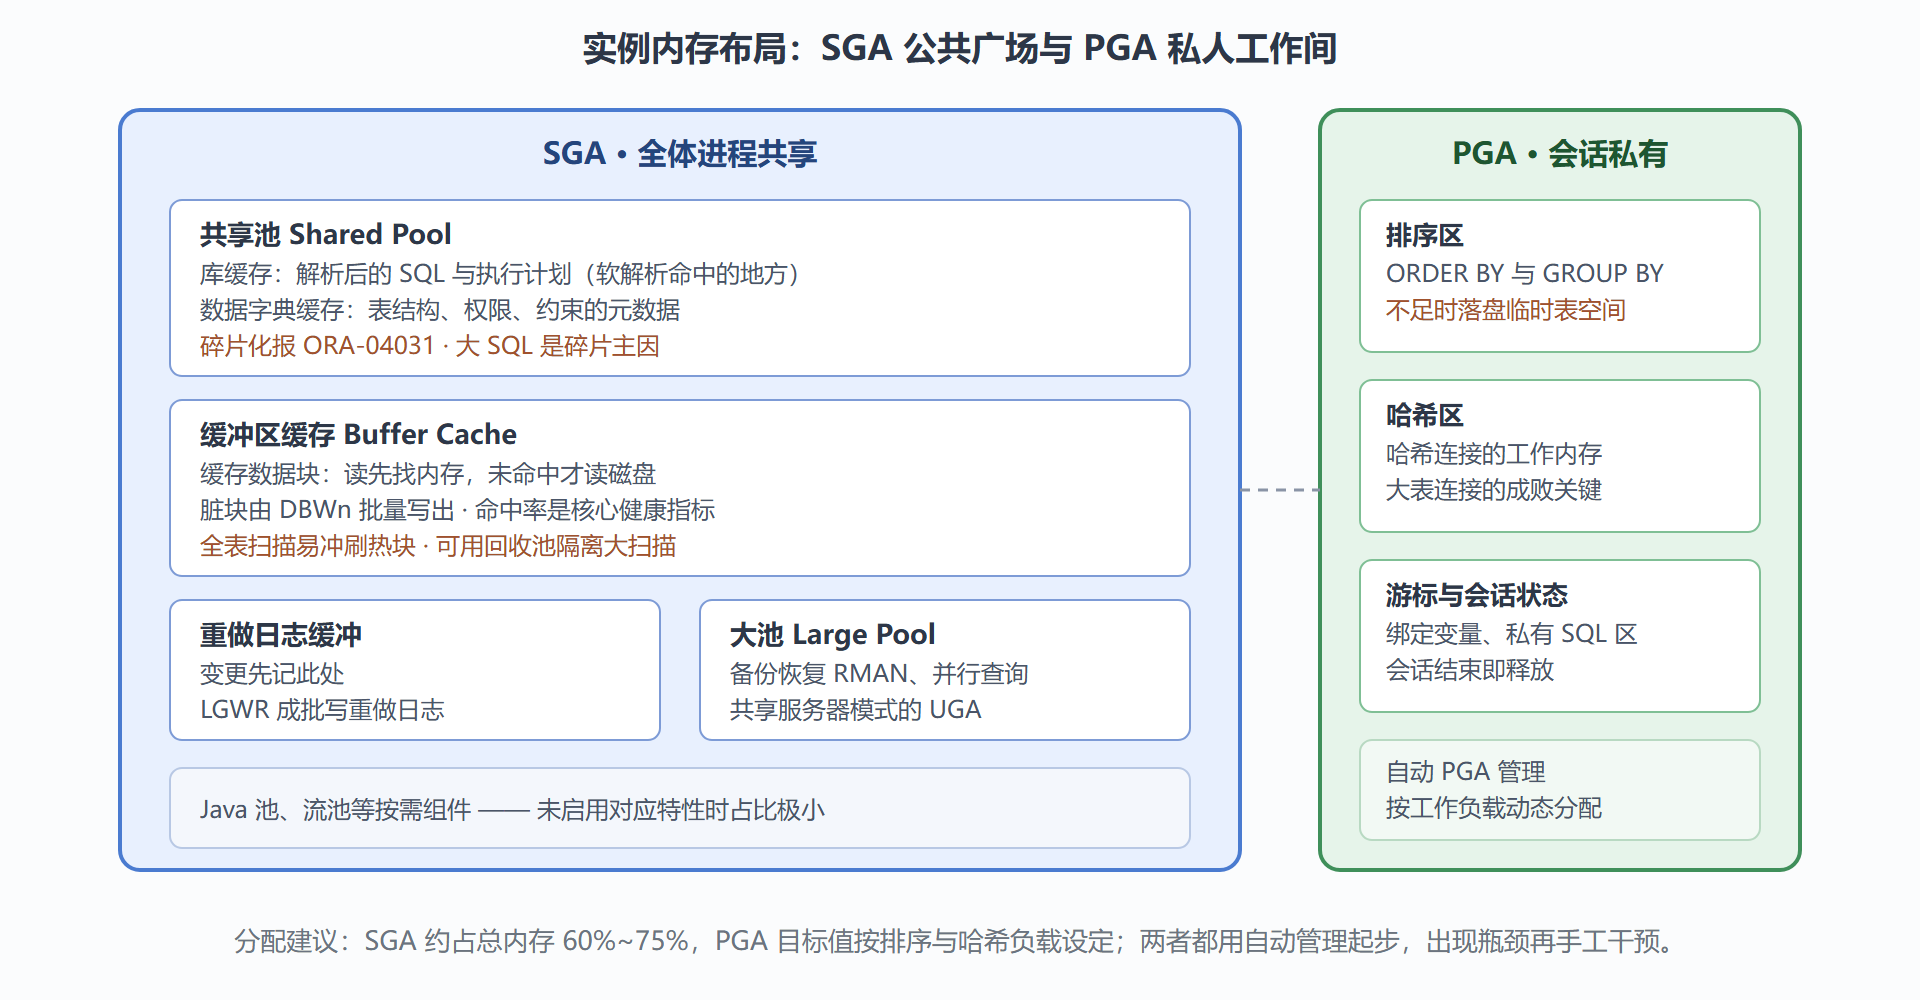
磁盘比内存慢十万倍,数据库的所有性能设计都围绕"让数据尽量待在内存"展开。但为什么不像有些系统那样一块大内存池通用?因为不同数据的共享属性完全不同:解析过的 SQL、缓存的数据块、待写的日志,所有会话都该共享,避免重复劳动;而排序的中间结果、会话变量、私有游标,属于单个会话的生命周期,混进共享区既浪费又危险。于是 Oracle 把内存一刀分成两半:**SGA(System Global Area)**是全体进程共用的公共广场,实例启动时分配、关闭时释放;**PGA(Program Global Area)**是每个服务器进程的私人工作间,会话建立时分配、结束时归还。分家的代价是两套调优逻辑——SGA 看总体命中率,PGA 看单会话工作区是否够用。
图 2-1:SGA 与 PGA 内存布局全景
二、SGA 的三个主力池
**共享池(Shared Pool)**是 SGA 里最讲究的一块,里面最重要的是库缓存(Library Cache):解析过的 SQL 语句连同执行计划存在这里,下一条一模一样的 SQL 到来时直接复用,这叫软解析;找不到就 hard parse——重新做语法、语义、优化全套,还要竞争共享池的闩锁。硬解析是全库级毒药:它消耗 CPU、制造闩锁争用、把共享池切成碎片。绑定变量是解药的核心——WHERE id = :1 一份计划服务千万次调用,而 WHERE id = 123 字面量写法则每次都是新 SQL。
**缓冲区缓存(Buffer Cache)**缓存从数据文件读来的数据块。读一个块先查缓存,命中则省一次磁盘 I/O;修改产生脏块,由后台的 DBWn 批量写回磁盘(下一节细讲)。命中率(逻辑读与物理读之比)是老派但仍有用的体检指标,OLTP 系统健康值通常在 95% 以上——但记住它是统计结果不是目标,靠加大缓存硬刷命中率而真实瓶颈在 SQL 的场景很常见。
**重做日志缓冲(Redo Log Buffer)**是变更的第一落点:任何 DML 先把"怎么重做这条变更"记进这里,LGWR 进程成批写到在线重做日志。它小(默认几十 MB)且不追求大——提交时 LGWR 必须把对应日志刷盘,这是 ACID 持久性的物理保证,缓冲再大也不能跳过。
三、案例:一次 ORA-04031 的完整处置
背景。 早高峰,订单应用的连接池集体报错:ORA-04031 unable to allocate 4160 bytes of shared memory。应用未重启,DBA 介入。
操作。 处置按"确认、定位、止血、根治"四步:
-- 第一步:确认共享池里哪类内存分不到 SELECT pool, name, bytes/1024 AS free_kb FROM v$sgastat WHERE name = 'free memory' AND pool = 'shared pool'; -- 第二步:找出占用库缓存最大的 SQL(字面量 SQL 的典型画像) SELECT hash_value, substr(sql_text,1,60) AS sql_head, sharable_mem FROM v$sqlarea ORDER BY sharable_mem DESC FETCH FIRST 10 ROWS ONLY; -- 第三步:止血——清空库缓存(会引发短暂硬解析风暴,选业务低谷) ALTER SYSTEM FLUSH SHARED_POOL; -- 第四步:根治参数——提高共享池上限并启用自动内存管理 ALTER SYSTEM SET sga_target = 24G SCOPE = BOTH; ALTER SYSTEM SET shared_pool_size = 6G SCOPE = BOTH;
结果。 冲刷后报错消失,但两小时后复发——说明第一步到第三步只是止血。复查发现订单查询全部用字面量拼接,一天产生 47 万条不同的 SQL,共享池被切成了蜂窝煤。解读。 ORA-04031 表面是内存不够,本质常是"内存碎片 + 海量一次性 SQL",加内存只是推迟复发。真正的根治在应用侧改绑定变量——这一单最终推动应用框架全局启用绑定,此后三年零复发。变式。 若第二步发现的是少数几条超大 SQL(比如带一万多个 IN 条件的语句),处置就换方向:让应用拆分语句或改用临时表,因为单条巨型 SQL 请求的连续内存任何配比都给不起。
四、PGA:私有的代价
PGA 的经典问题是排序落盘:ORDER BY、GROUP BY、哈希连接的工作区放不下时,数据溢出到临时表空间,速度掉一到两个数量级。诊断线索是 v$sql_workarea 里 on-disk 的比例,以及临时表空间的异常增长。现代版本默认开自动 PGA 管理,DBA 只需设一个总量目标,内核按会话需求动态分配——但总量要给足:报表系统大批量排序集中爆发时,按"并发会话数乘单会话峰值工作区"估算,别用默认值硬扛。
五、常见问题
⚠️ 常见坑:手工管理时代遗留的 sort_area_size 小值配置被原样搬进新环境,自动管理反而失效。接手老库先查 workarea_policy 是否 AUTO,再谈 PGA 调优。
问题一:memory_target 一步到位还是分池手工管? 起步阶段无条件选自动:内存目标加最大值两级参数,内核在 SGA 与 PGA 之间按负载搬动。手工分池只在两种情形介入:自动管理的换页式调整引发了可观测的抖动,或某些池的需求出现极端偏斜(比如 RMAN 大规模备份期的大池峰值)。介入时也别全手工——保留自动目标,只对个别池设最小值兜底。
问题二:怎么区分"内存不足"和"SQL 太烂"? 两者的表象都是慢,指纹不同:内存不足的特征是物理读持续偏高且与缓存总量负相关(加缓存立即缓解)、排序落盘比例上升;SQL 太烂的特征是单条语句的逻辑读畸高(读缓存也要读几百万次)——缓存再大也追不上烂 SQL 的消费速度。诊断顺序因此是先看单条语句的逻辑读榜,再看缓存命中率,顺序反了容易拿扩容替烂 SQL 买单。
问题三:大页(HugePages)要配吗? 内存超过几十 GB 的库值得配:标准页大小让 SGA 的页表占用可观内存与 CPU(页表遍历),大页能同时省两者。代价是管理复杂度——大页不支持自动内存管理(memory_target),需要回到 sga_target 加 pga 的半自动组合。新版本的新参数方案在两者间做了折中,具体取舍按你的版本能力定,别凭旧文档拍板。
问题四:怎么给内存配置写变更说明? 每次调整记录三样:当时各池的实测使用率、调整的预期效果与验证指标、回退值。内存参数的验证周期以天计(负载有周期性),没有记录的调整会在几周后变成"不知道为什么这么配"的悬案——而悬案正是下次误改的温床。
本节要点回顾
- 两分天下:SGA 共享(解析、缓存、日志缓冲),PGA 私有(排序、哈希、游标)——调优逻辑完全不同。
- 共享池的本质是复用:绑定变量促成软解析,字面量 SQL 制造硬解析风暴与 04031 碎片。
- 04031 处置四步:确认缺口、定位元凶、低谷冲刷止血、应用侧根治——冲刷只是买时间。
- PGA 的红线是落盘:排序哈希溢出到临时表空间就是性能悬崖,自动管理也要给足总量。
内存是舞台,真正干活的是进程。下一节看这支施工队的名册:谁写日志、谁刷脏页、谁收拾残局。