4.2 查询处理流程
4.2 查询处理流程
本节摘要:一条 SQL 从文本到结果集要过四站:解析、优化、执行、获取。绝大多数"突然变慢"的悬案,答案都藏在解析站的软硬之分与执行站的取数方式里。本节沿流水线逐站拆解,并给出每个站的常见故障画像。
跟一条 SQL 走一遍流水线
应用发来 SELECT * FROM orders WHERE cust_id = 88,毫秒级返回;换成字符串拼接的 88 个兄弟语句,库开始喘。同一条逻辑 SQL,命运差别为什么这么大?差别发生在流水线的第一站。要诊断慢查询,先得知道这条语句在库内走过的每一步——否则你只能换着姿势重试,赌运气。
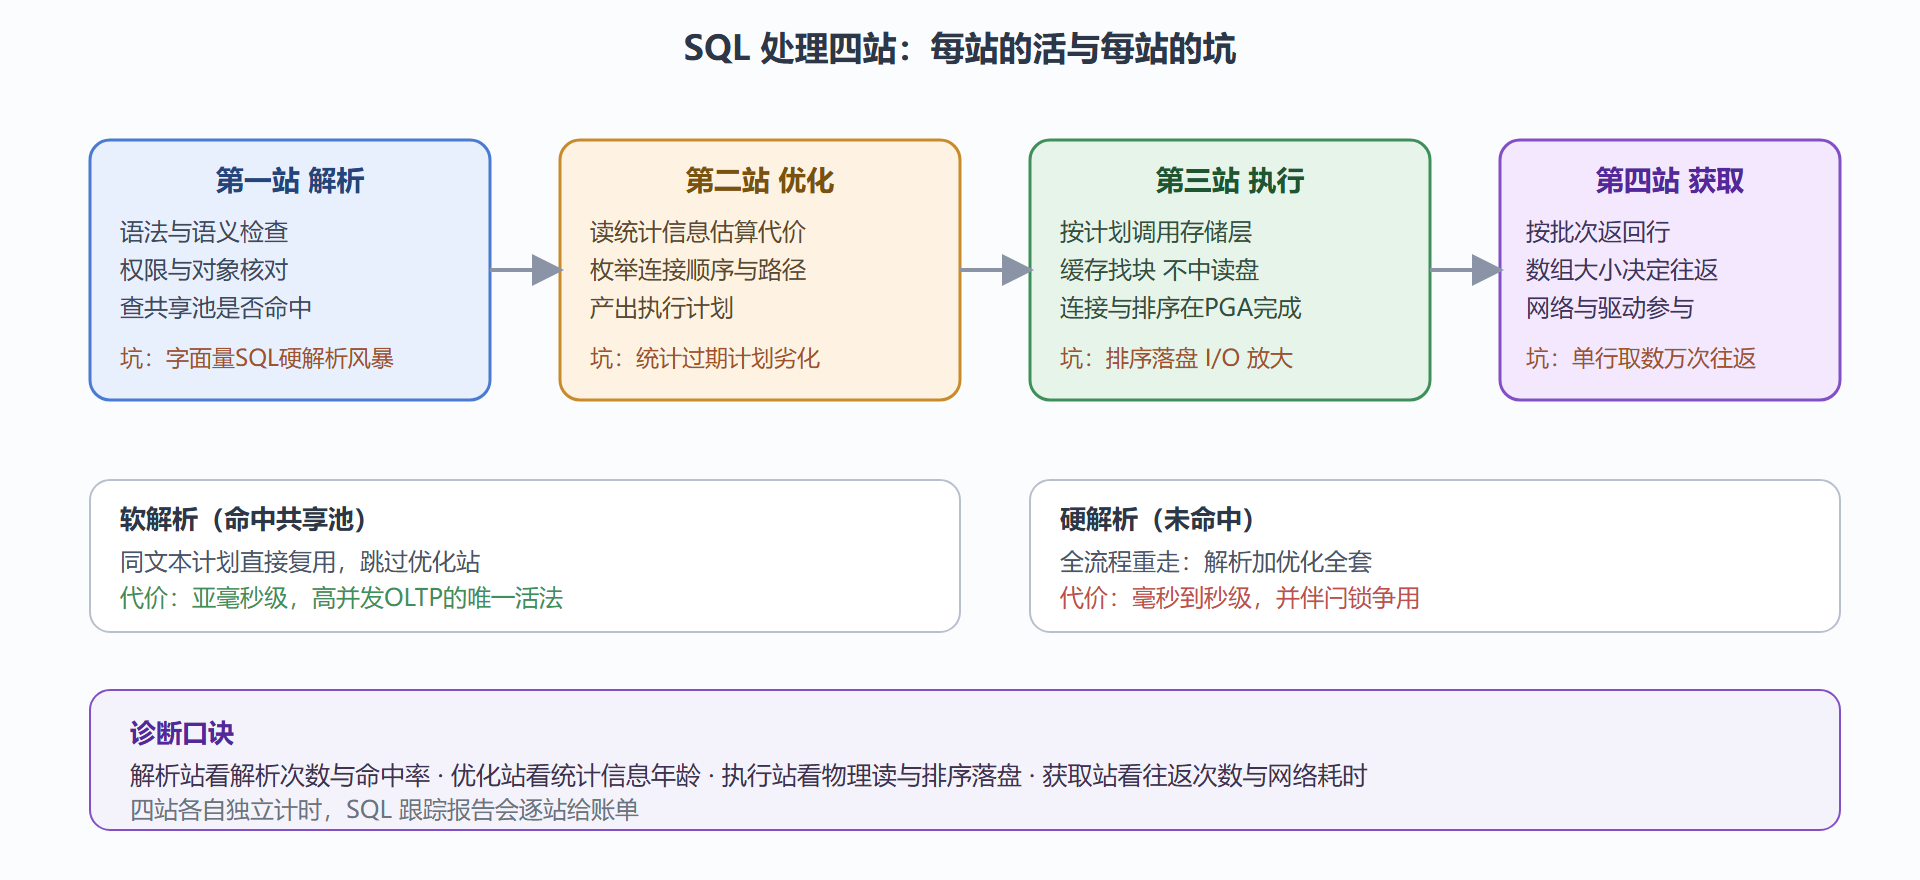
图 4-1:一条 SQL 的四站流水线与耗时盲区
一、解析站:软与硬的分水岭
解析站做三件事:语法语义检查(表在不在、列对不对、权限够不够)、把文本换成内部结构、然后拿去共享池的库缓存里找"同文本同语义"的现成计划。找到就是软解析——直接复用,亚毫秒;找不到就是硬解析——语法树、查询改写、代价估算全套重走,毫秒到秒级,还要争共享池的闩锁。第 2.1 节从内存角度讲过这对概念,这里补上工程视角:判断一个系统的解析健康度,看两个比值——硬解析占总解析的比例(健康值低于 5%)与每秒硬解析数(健康值个位数)。
让软解析成立的条件苛刻得像背诵课文:文本一字不差(空格大小写都算)、涉及对象相同、会话环境相同。所以绑定变量是第一纪律——WHERE cust_id = :1 让百万次调用共享一份计划。两个例外也要记牢:一是列上直方图与数据倾斜严重时,绑定变量会"一份计划服务天差地别的参数",可能引发绑定变量窥视的误判(4.3 展开 remedies);二是 DSS 类低并发分析库,硬解析占比高一点无所谓,别把 OLTP 的纪律机械照搬。
二、优化站与执行站:计划从哪来、活怎么干
优化站是整条流水线的大脑,细节全部留给下一节,这里只交代它在这条流水线上的位置意义:软解析跳过优化站,硬解析重走优化站——这就是为什么字面量 SQL 慢两次:解析贵、且每次都给优化器重新犯错的机会。执行站按计划干活:访问路径(全表扫还是走索引)、连接方式(嵌套循环、哈希、排序合并)、连接顺序逐个展开。这一站的性能账单主要是两类:物理读(缓冲缓存没命中,去磁盘拿块)与临时空间(排序哈希放不下 PGA 溢出落盘)。诊断工具就是 SQL 跟踪与执行统计里的物理读计数与落盘标记。
三、获取站:最被低估的耗时大户
前三站都在库内,第四站连接库与应用。客户端按"数组大小"分批取行:数组 10 行取 10 万行结果就是一万次网络往返;数组调到 500,往返降两百倍。 JDBC 的 fetchSize、SQL Developer 的取数参数,本质都是这个旋钮。"分页查询越翻越慢""导出百万行超时"的一大半案例,病根不在 SQL 而在获取站的往返次数。诊断方法很朴素:同样 SQL 在库内跑 0.2 秒、应用侧跑 20 秒——时间差全在获取站。
-- 三个站的健康体检一次跑完 SELECT name, value FROM v$sysstat WHERE name IN ('parse count (total)', 'parse count (hard)', 'sorts (disk)', 'physical reads', 'consistent gets'); -- 会话级取数与往返计数:获取站耗时的直接证据 SELECT sid, fetches, rows_processed, executions FROM v$session s JOIN v$sesstat USING (sid) WHERE ... -- 单条 SQL 的执行与获取对账:物理读高找执行站,取行慢找获取站 SELECT sql_id, executions, disk_reads, buffer_gets, rows_processed, ROUND(disk_reads / NULLIF(executions,0)) AS reads_per_exec FROM v$sqlarea WHERE sql_id = :sql_id;
四、案例:分页越翻越慢的真凶
背景。 订单中心的分页接口,第一页 80 毫秒,翻到第 50 页飙到 6 秒。开发按直觉归因于"深分页 OFFSET 慢",准备大改 SQL。
操作。 先分段计时定位站点:库内执行计时 60 毫秒且稳定——执行站没问题。查会话取数统计:每页 20 行,往返 140 次,每页耗时里 5.9 秒在获取站。再看驱动配置,数组大小是框架默认 10,且每行携带 40 多个字段含大对象描述。
结果。 数组大小调到 200、裁掉列表页不需要的大字段,第 50 页 6 秒变 210 毫秒。深分页 OFFSET 的优化照做不误(那是执行站的另一笔账),但真正救命的是获取站这个两行配置。解读。 这个案例的通用教训:耗时排查先分段,再归因——四站流水线就是分段框架,每站有独立的计量口径(解析次数、物理读、往返数),顺序错了就会像本案一样差点为错误的诊断动大手术。变式。 若分段发现库内执行本身随机抖动(有时 60 毫秒有时 4 秒),则嫌疑转向执行站的可变计划——绑定变量窥视或统计信息波动,这就衔接到下一节的优化器话题了。
⚠️ 常见坑:把"加个索引试试"当万能第一步。流水线四站里索引只影响执行站,获取站的往返、解析站的硬解析、优化站的过期统计,索引一个都治不了。先分段计时,再决定动哪一站。
五、常见问题
问题一:游标共享参数要不要开? FORCE 模式会把字面量 SQL 强行当绑定变量复用共享的游标,看似解决硬解析,实际引入了更隐蔽的问题:天差地别的参数值共用一份计划,倾斜数据下的执行效率随机抽奖。它是没有时间改应用时的止痛药,不是治疗方案——开了它,慢查询会以一种更难解释的方式出现。正途仍然是应用侧绑定变量。
问题二:怎么判断一个系统的硬解析是不是问题? 两个数加一个相关性:硬解析占比(高于 10% 值得关注)、每秒硬解析数(持续两位数已经偏高)、以及它们与闩锁等待(共享池相关 latch)的同现——三者齐了才定性为问题,单看占比高而系统无等待症状的(比如低并发的报表库),可以不动。
问题三:获取站的数组大小调多大合适? 经验起点是每次往返取 100 到 500 行,再按结果集形态微调:明细导出类大结果集往上限靠,交互式分页按页大小的一半到一倍定。调大的副作用是客户端内存占用与首行延迟——首屏体验敏感的接口,宁可多几次往返也要快出首行,参数跟着业务形态走,没有万用值。
问题四:一条 SQL 有没有必要每个站都计量? 日常不必,四段归因是"案发时"的方法论:常规巡检看全库级的解析比、物理读、排序落盘三个聚合指标即可,异常发生了才对单条 SQL 做逐站取证。把重武器当日常巡逻用,成本会反过来压垮你。
问题五:DDL 也走这条流水线吗? 走,但站点不同:DDL 不走优化与执行的数据流,它在解析后直接进"依赖检查加数据字典变更"的专属通道,这也是为什么 DDL 无法回滚——字典变更本身隐式提交。理解了这一点,"高峰禁 DDL"就不再是一条死规定,而是它的物理原因:字典变更会锁住全表相关的所有并发。
本节要点回顾
- 四站框架:解析、优化、执行、获取——任何慢查询先归站,再归因。
- 软硬解析的分水岭:绑定变量决定命不命中共享池;硬解析占比与每秒硬解析数是两个健康仪表。
- 获取站最被低估:数组大小与字段裁剪,常常是"SQL 快应用慢"的真凶。
- 诊断靠分段计时:库内执行与应用侧耗时之差暴露获取站,执行站内部再拆物理读与落盘排序。
执行站选什么路径、为什么选,是优化器的事。下一节我们把它请到审讯室:让它亲口交代那份执行计划是怎么生成的。