4.3 优化器与执行计划
4.3 优化器与执行计划
本节摘要:基于代价的优化器用统计信息估算每条路径的成本,挑最便宜的一条执行。统计信息过期、数据倾斜、参数窥视是计划劣化的三大病灶。本节给出统计信息的管理节律、执行计划的逐行读法,以及一份"测试快生产慢"的完整破案记录。
先看一份执行计划的判决书
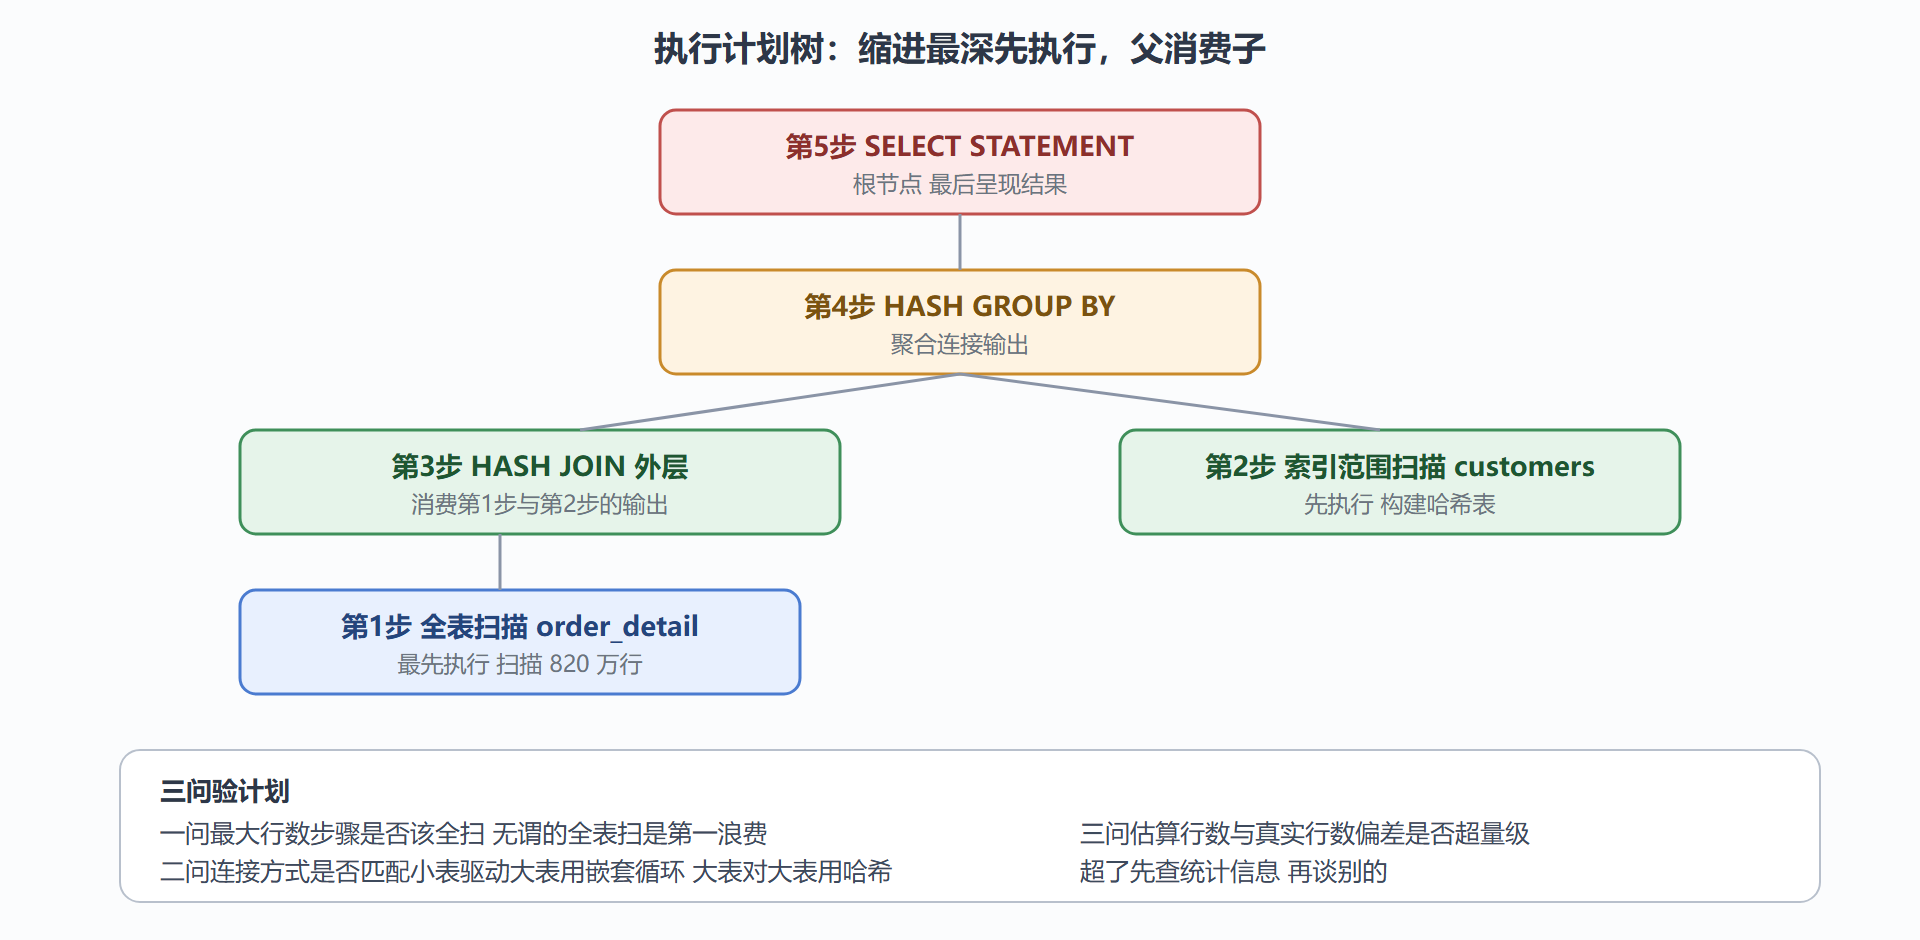
执行计划是优化器的判决书:它认定这条 SQL 该怎么走、每步预计多少行、成本几何。多数人第一次读计划按从上到下的顺序,读出的执行顺序十有八九是错的。正确读法一句话:按缩进深度从最深读起,同级从上到下,父子配对——缩进越深越先执行,父操作消费子操作的输出。这是慢查询诊断的核心技能,值得用一个真实计划练一遍:
-- 拿计划:用解释计划看估算,用真实计划看运行时真相 EXPLAIN PLAN FOR SELECT o.order_no, c.cust_name, sum(d.amt) FROM orders o JOIN customers c ON c.cust_id = o.cust_id JOIN order_detail d ON d.order_id = o.order_id WHERE o.order_date >= DATE '2025-07-01' GROUP BY o.order_no, c.cust_name; SELECT * FROM TABLE(dbms_xplan.display); -- 拿真实运行时数据(估算与实际行数的偏差一目了然) SELECT /*+ gather_plan_statistics */ o.order_no, c.cust_name, sum(d.amt) FROM orders o JOIN customers c ON c.cust_id = o.cust_id JOIN order_detail d ON d.order_id = o.order_id WHERE o.order_date >= DATE '2025-07-01' GROUP BY o.order_no, c.cust_name; SELECT * FROM TABLE(dbms_xplan.display_cursor(NULL, NULL, 'ALLSTATS LAST'));
读的时候抓三类信息:访问路径(TABLE ACCESS FULL 还是 BY INDEX ROWID)、连接方式(NESTED LOOPS、HASH JOIN、MERGE JOIN)、每步的估算行数与真实行数之比(A-Rows 与 E-Rows)。偏差超过一个数量级的步骤,就是估算失真的案发点——顺着它去查统计信息。
一、优化器怎么想:代价模型的三个输入
统计信息是优化器的眼睛:表与索引的行数、块数、列的低值高值与密度、列间相关性,全在 dba_tables、dba_tab_col_statistics 里。基于这些数字,优化器估算每个候选计划要处理多少行、做多少 I/O、比出总代价。眼睛花了(统计过期、采样率太低),判决必然离谱——"昨天还秒回今天慢成狗"的悬案,一大半的开庭理由是夜间自动统计作业没跑成或被关了。
转换与改写是优化器的暗功夫:视图合并、谓词推进、子查询 unnest——你写的一条复杂 SQL,优化器会先改写成等价但更利于执行的形式再估代价。这解释了一个常见困惑:为什么禁掉改写(hint 里加 no_merge)有时反而慢——它剥夺了优化器把你的写法翻译成更好执行形态的机会。
绑定变量窥视是高并发 OLTP 的特有难题:硬解析时优化器会"偷看"第一次传入的绑定值来估代价,之后所有调用共用这份计划。数据倾斜的列(比如状态列 99% 是"已完成")会遭殃——按"已完成"生成的全表扫计划,被"待处理"的查询复用时就是灾难。现代版本的自适应计划与统计反馈能部分自愈,根治手段仍是:倾斜列上避免绑定变量(用字面量)、或对倾斜列收集直方图。
图 4-2:执行计划树与正确的阅读顺序
二、统计信息管理:一张维护节律表
统计信息不是"收集一次管终身",要按对象的变化性格排节律:稳定维表(地区、商品目录)一个月一次足够;持续增长的流水表依赖夜间自动作业(默认窗口周一到周五 22 点到次日 2 点),确认作业窗口没被跑批挤占;当天暴涨的分区表在批量装载后立刻手工收集对应分区;加载即查询的临时加工表用加载语句的在线收集选项顺带完成。判断"统计多旧"的最快查询是 dba_tables 的 last_analyzed 列对着 dba_tab_modifications 的变更行数——后者超过表行数的 10%,就该动手了。
-- 看谁统计过期了 SELECT t.owner, t.table_name, t.last_analyzed, m.inserts + m.updates + m.deletes AS changes, t.num_rows FROM dba_tables t JOIN dba_tab_modifications m ON m.table_owner = t.owner AND m.table_name = t.table_name WHERE t.last_analyzed IS NULL OR (m.inserts + m.updates + m.deletes) > GREATEST(t.num_rows * 0.1, 10000); -- 手工补课:只扫采样量 自动选采样率 EXEC dbms_stats.gather_table_stats('APP', 'ORDERS', cascade => TRUE);
三、案例:测试快生产慢的破案全程
背景。 一条对账 SQL 在测试库 1.8 秒,生产库 40 秒起步。两边"数据量差不多",开发坚持是"生产环境配置问题",要求 DBA 调参。
操作。 按嫌疑顺序排除。嫌疑一:环境参数差异——对比两边优化器相关参数,完全一致,排除。嫌疑二:执行计划不同——两边各抓 display_cursor,计划形状一致,但生产库计划的第三步估算行数 800,实际行数 1900 万,偏差四个数量级,锁定优化站。嫌疑三:统计信息——生产的 last_analyzed 停在四个月前,而这张表是个每天加载数百万行的宽表;测试库是上周刚收集的。
结果。 生产对目标表手工收集统计(cascade 带索引),同一条 SQL 40 秒落到 2.1 秒,未动任何参数、未加任何索引。随后排查自动统计作业,发现跑批把 22 点到 2 点的窗口完全占死,统计作业连续失败四个月——给宽表单独加了凌晨 4 点的定制收集窗口。解读。 "测试快生产慢"的三大嫌疑按"参数、计划、统计"的顺序排查,多数案子终结在统计信息这一环。调参请求先别急着答应——参数是库级的,而案根几乎总是表级的。变式。 若统计新鲜、计划却仍劣化,下一站查直方图:倾斜列没建直方图时,均摊估算会骗过优化器;建直方图(method_opt 加 size auto)让优化器看见倾斜。
⚠️ 常见坑:用 hint 硬改计划而不修统计。hint 是止痛片——这次走对了,下次数据变了照样翻车,而且 hint 焯进代码后没人敢动。先修统计、再看改写、最后才轮到 hint,这是处方顺序。
本节要点回顾
- 读计划的姿势:缩进最深先执行、父子配对消费;三问——全扫该不该、连接配不配、估算准不准。
- 统计信息是眼睛:变更量超行数 10% 或 last_analyzed 过旧就该收集;加载后立即收集新分区。
- 窥视与倾斜:倾斜列上的绑定变量会让一份坏计划服务所有参数;直方图是让优化器看见倾斜的手段。
- 处方顺序:修统计、改写法、最后 hint——倒着来,就是把止痛片当饭吃。
SQL 层的账算完了。下一章换个战场:当"慢"升级为"停",备份、复制、集群这一整套高可用机器就是唯一的答案。