5.3 RAC集群
5.3 RAC集群
本节摘要:RAC 让多台服务器同时打开同一套数据库:节点坏了连接漂移到幸存节点,业务感知以秒计。它的底层魔法是缓存融合——多台机器的内存缓存互相协商块的所有权。本节拆它的架构与代价边界,并用一次节点驱逐演练看清"双活"的真实脾气。
一、为什么需要一台以上的数据库
单实例数据库的一切高可用方案都有一个共同软肋:实例本身是单点。Data Guard 顶得上但切换要分钟级;RAC(Real Application Clusters)的答案是釜底抽薪——让两台、四台、八台服务器同时挂载同一套数据库文件,每台跑自己的实例,共享同一份存储。任何一台宕机,其他台的实例还开着,数据库根本没"停"过。应用看到的 VIP(虚拟 IP)漂到幸存节点,连接重连几秒完成。这就是 9i 以来 Oracle 立足核心市场的招牌能力:节点级故障对业务接近透明。
但要先把 RAC 的能力边界说清,它是三层防线里的"本站点内节点级",不是全部:存储还是共享的,阵列故障 RAC 无能为力(那层归 Data Guard 和异地容灾);应用端的连接池要支持故障转移,否则数据库没停、应用先断了。RAC 解决的是"主机坏了不停服",不是"什么坏了都不停服"。
二、缓存融合:多台机器如何像一台
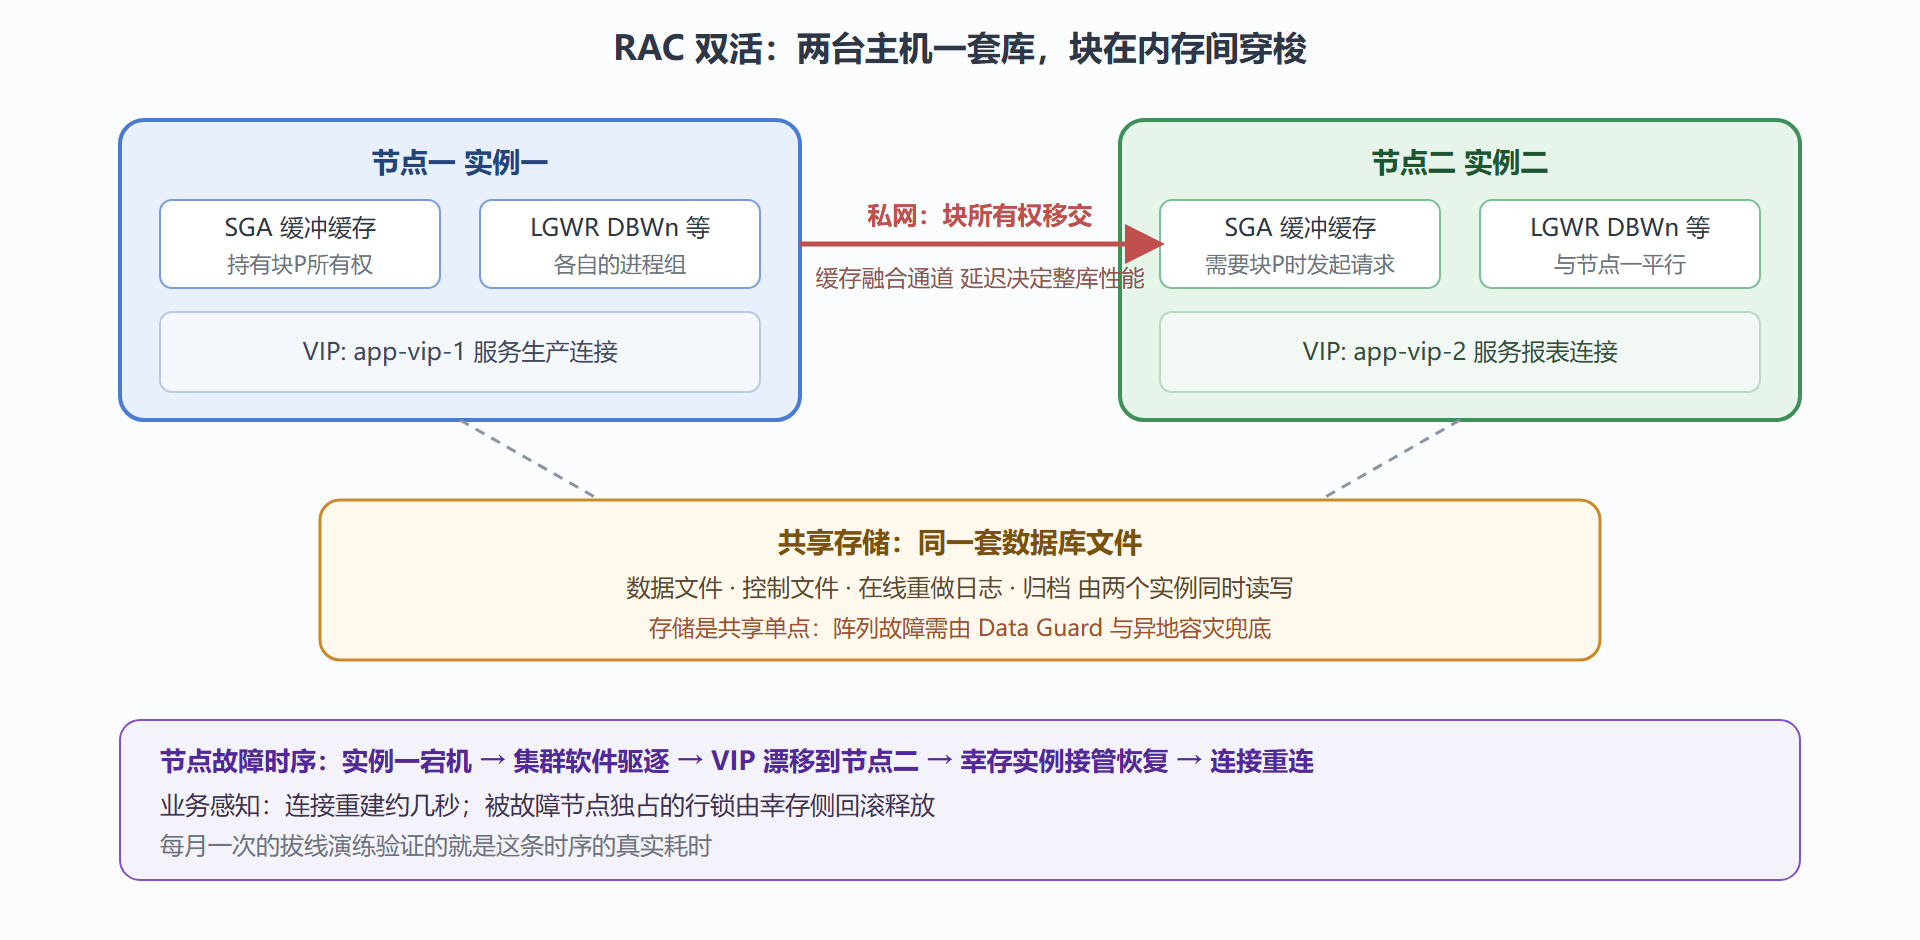
多实例共享数据,冲突点立刻浮现:节点 A 的缓存里改了一个块还没落盘,节点 B 想读这个块怎么办?RAC 的答案是缓存融合(Cache Fusion):块在实例间的内存缓存里直接通过网络传输所有权,而不是先落盘再由对方读盘。节点 B 要读的块若在 A 的缓存里,A 通过私网把块发给 B;要写时则协商转让所有权。全球缓存目录(由集群的分布式锁管理维护)记录每个块在哪个节点、什么模式。
这套机制的工程含义直接决定部署与诊断:私网是 RAC 的命脉。块搬运走的是节点间私网,延迟与带宽直接折算成全库性能——私网抖动,两个实例互相等待,整库吞吐骤降。所以 RAC 私网必须独立网卡、独立交换机、冗余链路;诊断 RAC 性能问题,第一批指标永远是私网延迟与块传输量。
图 5-3:RAC 双活架构与缓存融合路径
三、集群软件与节点驱逐
RAC 之下还有一层集群基座(Grid Infrastructure),管三件事:节点成员关系(心跳)、网络与存储资源管理、以及最重要的——节点驱逐(Node Eviction)。当某节点心跳丢失或关键进程僵死,集群软件投票裁决后把它踢出集群,幸存节点接管它的 VIP 与服务。驱逐是"宁可误杀不可漏杀"的设计:脑裂(两半集群都以为自己是主人)比停服更危险,因为它会写坏共享数据。心跳网络因此也要冗余——私网单点既是性能命脉也是裁决通道,一张坏网卡可能引发整库动荡。
四、案例:一次节点驱逐演练的账本
背景。 某票务平台两节点 RAC,演练目标:验证节点一宕机后业务恢复时间。
操作。 三轮测试。第一轮直接 kill 实例一:VIP 漂移 8 秒,应用连接池重连 6 秒,业务恢复 14 秒。第二轮模拟更粗暴的故障(节点断电):集群裁决加驱逐 25 秒,恢复共 33 秒。第三轮在节点一上制造一个持有热点行锁的长事务再杀实例:恢复时间涨到 90 秒——幸存节点要先重演崩溃恢复并释放该节点持有的锁。
结果与解读。 账本揭示两个常被忽略的事实:其一,"RAC 秒级切换"的秒是理想值,真实恢复时间等于集群裁决加接管加应用重连三段之和,应用连接池的重连参数(重试次数、退避间隔)不调好,数据库 14 秒搞定应用要挂两分钟;其二,跨节点的热点行锁会显著拉长接管时间——RAC 时代的应用设计更要把短事务纪律执行到位,锁的债务不会因为双活就消失。变式。 若演练目标是"扩展性"而非"高可用"——验证加节点是否线性提升吞吐——测的就该是跨节点块传输量:一旦某表被两节点频繁互改(热点块在私网上来回倒手),加节点反而更慢,这就是 RAC 对应用"数据亲和性"的隐性要求。
五、延伸问答:评审会上最常被追问的四个问题
问题一:RAC 各节点是"负载均衡"吗? 不完全是。默认的负载均衡只作用于"新连接落在哪个节点",落定之后的会话不会动态搬家。要做到真正的负载分布,靠服务(Service)划分:把不同业务定义为不同服务、指定首选与可用节点,应用按服务连入。生产上更常见的是"按服务分而不按连接分"——交易服务跑节点一、报表服务跑节点二,互为可用节点。这样做还有个好处:故障转移时按服务整体重定位,应用感知的恢复行为是确定的,而不是随机散落。
问题二:两节点还是多节点? 双节点是性价比与复杂度的平衡点:每节点都是对方的备胎,心跳拓扑简单。四节点以上要开始认真对待序列化点——全局缓存目录的维护、跨节点块的传输距离都会随节点数上升,收益从线性转为次线性。经验规律:多数业务两到四节点封顶,继续加节点不如先把应用的数据亲和性做好。
问题三:RAC 上的备份和单机有什么不同? 原理相同,配置多两处:归档日志放在共享存储(每个实例都有自己的日志线程,恢复时都要用),RMAN 需要配置为"任一节点可见全部归档"——常见做法是归档直接落在 ACFS 或共享文件系统,或开启集群内的归档自动同步。漏配的表现是恢复时报找不到某线程的归档序列,这类坑在演练里第一次暴露还算幸运。
问题四:什么情况下不该上 RAC? 三种情形值得冷静:应用是批处理为主、无在线高可用诉求的,RAC 的复杂度换不来对应收益;数据规模小到单机加 Data Guard 足以覆盖的,省下集群件的学习与维护成本更划算;应用层重度依赖单实例特性(如大量串行化的自治过程)且短期改不动的,双活反而放大锁争用。RAC 是好工具,不是信仰。
问题五:私网延迟多少算有问题? 经验阈值:节点间心跳与块传输的往返延迟稳定在 1 毫秒内属健康,持续高于 5 毫秒就会出现可感知的等待事件,毫秒级抖动(尖刺)比均值更能说明问题——网卡驱动、交换机缓冲、跨机柜布线都是常见抖动源。私网监控要作为 RAC 巡检的固定项,等用户报慢再查私网,通常已经迟了。
⚠️ 常见坑:把 RAC 当存储容灾。共享存储阵列故障时,所有节点一起趴——RAC 从不保护存储层。评审会上听到"上了 RAC 所以数据安全了"就可以中止讨论了,那是 5.1 和 5.2 的辖区。
本节要点回顾
- 能力边界:RAC 解决节点级故障,存储靠共享阵列、站点级靠 Data Guard,三层防线各管一段。
- 缓存融合:块所有权在实例私网上直接移交;私网延迟等于全库性能,独立冗余网卡是底线。
- 驱逐即裁决:心跳丢失宁可误杀,脑裂的代价是不可写坏的共享数据。
- 恢复时间三段账:集群裁决、实例接管、应用重连;连接池参数与跨节点锁纪律决定真实体感。
- 服务化分布:按服务而非按连接划分节点负载,故障转移行为确定可演练;私网毫秒尖刺进巡检清单。
节点级和站点级都练完了,最后一块拼图是把这一切写成一份能救命的文档。下一节做灾难恢复规划。