5.4 灾难恢复规划与演练
5.4 灾难恢复规划与演练
本节摘要:前三节的技术底牌(备份、Data Guard、RAC)要兑换成业务语言,才能变成一份灾难时刻真正管用的文档:两个指标(RTO、RPO)、四类场景、一页角色表、一张演练日历。本节走完从技术能力到正式预案的全流程,并以一场"半夜拉闸"式的真实演练收尾。
先回答一个扎心的问题
如果现在机房断电,公司能承受核心业务停多久?能承受丢多少数据?让 CTO 和 CFO 各写一个数,你会发现两个数字对不上——技术团队觉得"两小时很合理",财务说"停一小时亏一百万"。灾难恢复规划的第一步不是技术选型,是把这两个数字谈拢并写进制度:**RTO(恢复时间目标)**是业务能容忍的最长停服时间,**RPO(恢复点目标)**是能容忍的最大数据丢失量。这两个数是全章所有技术投入的标尺——RPO 为零逼出 Data Guard 同步模式,RTO 十分钟逼出自动切换,两个数都宽松的小系统,一套备份加一台冷备机就够了。先有指标再选技术,顺序反了就是拿预算凑热闹。
一、场景分级:四种事故四种打法
预案的核心是场景分级——不同事故动用的资源、决策链、回退线完全不同。按影响半径从内到外分四级:
| 级别 | 典型场景 | 首选手段 | 决策人 | 典型 RTO |
|---|---|---|---|---|
| L1 实例级 | 进程崩溃、参数错误重启 | 实例重启自愈(SMON) | 值班员 | 15 分钟 |
| L2 节点级 | 主机宕机、存储单点 | RAC 幸存节点接管 | 值班主管 | 30 分钟 |
| L3 数据级 | 误删表、坏块、逻辑污染 | 时间点恢复、闪回 | DBA 负责人 | 2 小时 |
| L4 站点级 | 机房断电、区域灾难 | Data Guard 远端接管 | 总值班加技术总监 | 1 小时 |
级别划分的价值在于授权前置:L1、L2 值班员按手册直接动手,不用请示;L4 涉及"接受数据丢失"的业务决策,必须明确到人名和联系方式。灾难时刻最贵的成本是"等决定",预案里每个级别写死决策人,就消掉了这笔成本。
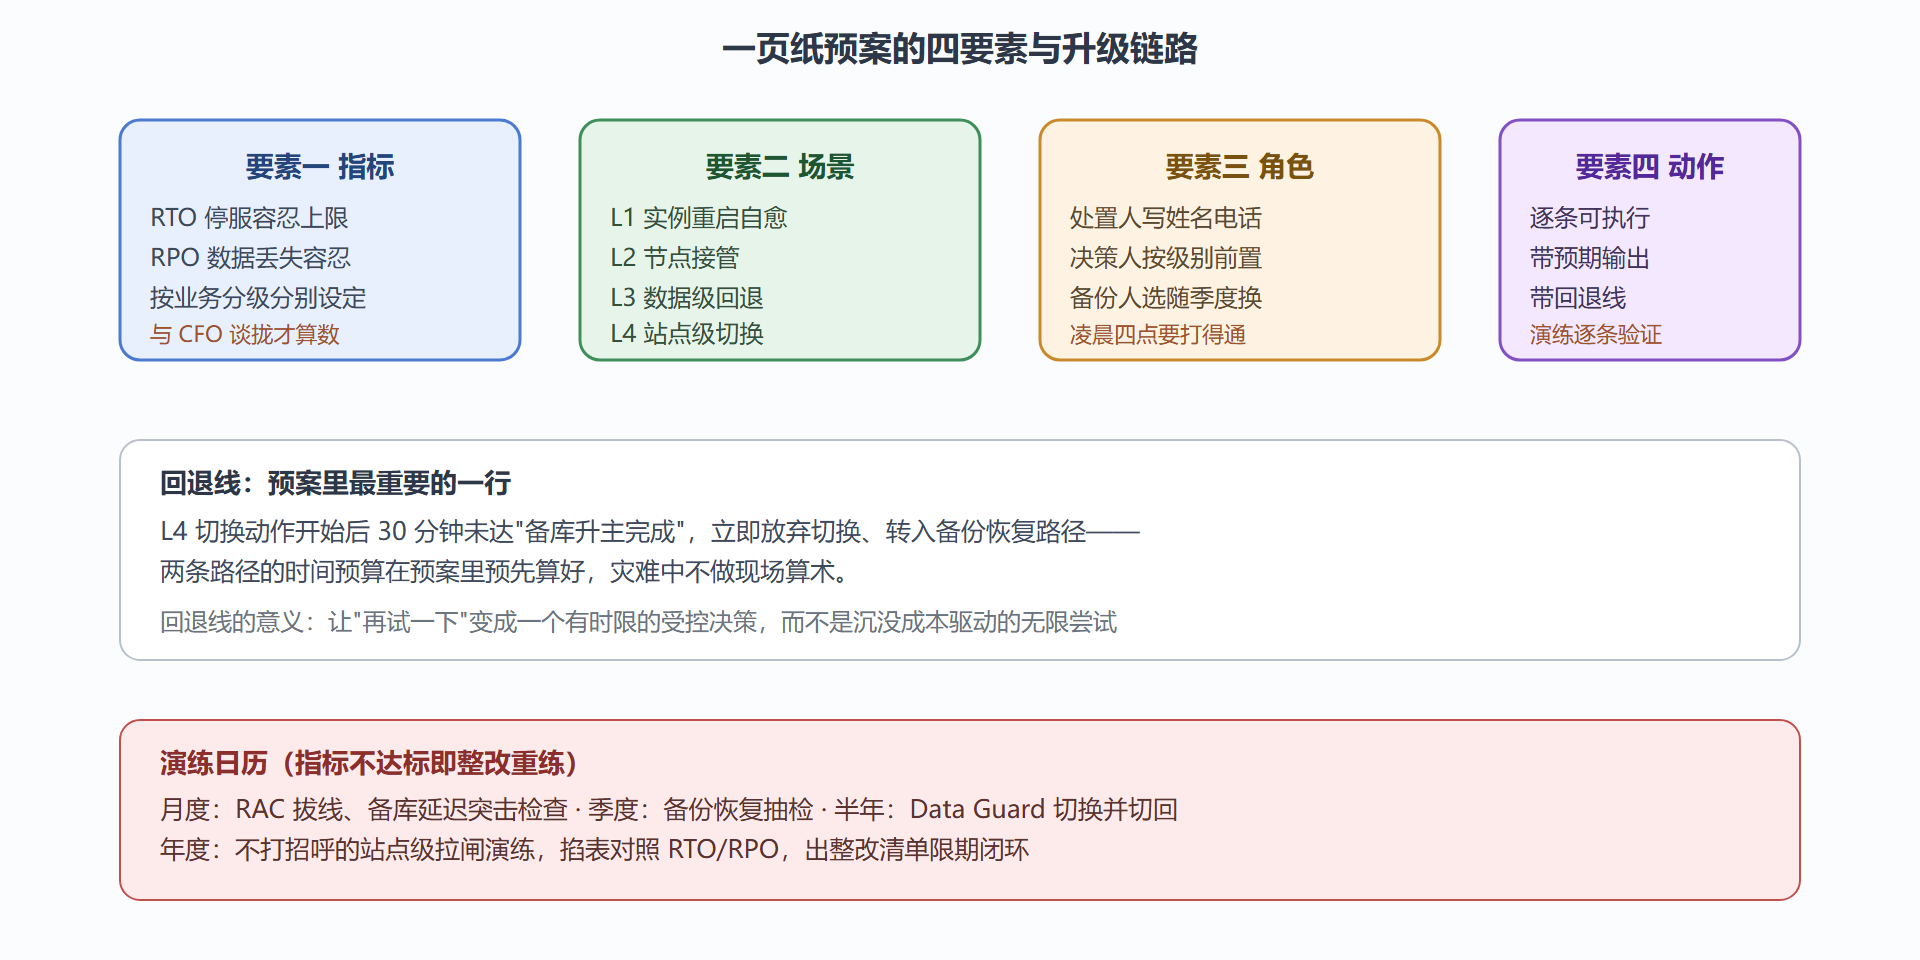
图 5-4:灾难恢复预案的骨架结构
二、从技术清单到正式预案
写预案的过程就是拿 5.1 到 5.3 的能力对表:每个场景级对应"技术上走得通的最快路径",再把路径拆成"可由非专家在压力下执行"的动作清单。写清单有两条纪律。动作要带预期输出:"执行恢复命令"不算动作,"执行恢复命令,预期十分钟后日志显示媒体恢复完成"才算——压力下的人需要的是核对点,不是知识。路径要带回退线:每条路径在什么时点、什么信号下放弃并转入备选,写死在纸上。灾难现场最常见的失控就是"再试一下",回退线把"再试一下"变成有时限的受控决策。
三、案例:一场年度拉闸演练的全程与产出
背景。 某消费金融公司年度演练:凌晨 1:00 演练组切断生产机房电源(生产与灾备双活架构,灾备在另一城市),指标为 RTO 30 分钟、RPO 零。
操作。 时间轴回放:1:00 拉闸;1:02 监控确认双机房心跳全断,值班员判定 L4,电话通知预案上的技术总监(2 分钟接通,达标);1:05 启动灾备接管流程——备库升主、应用配置中心切流;1:19 数据库侧完成,日志序列核对无缺口(RPO 零达成);1:31 应用全面恢复,对外服务验证通过——总耗时 31 分钟,超指标 1 分钟。
结果。 演练判定"整改后通过",出三条整改:其一,应用切流依赖的配置中心操作在预案里只有一行字,实际要 12 个手工步骤,补自动化脚本;其二,技术总监电话打通用了 2 分钟,因为在拨备用号——预案的联系方式没更新到当月值班表,改为每季度强制核对;其三,1 分钟的超时来自备份验证环节,把"备库数据一致性抽检"从切换路径挪到切换后并行执行。
解读。 这场演练的产出价值远超 31 分钟本身:三条整改里没有一条是"数据库技术问题",全是预案颗粒度问题——这正是演练的本职:技术能力是买来的,执行能力是练出来的。变式。 小团队养不起双活架构的,把演练降级为"季度恢复抽检加半年切换彩排",指标放宽到 RTO 4 小时——预案的规格跟着业务赔付能力走,而不是跟着大厂模板走。
💡 关键直觉:预案写得越"全"越没人看。能用的一页纸预案胜过书柜里的灾难恢复白皮书——四要素(指标、场景、角色、动作)加回退线,一页 A4 排得下,凌晨的值班员才翻得完。
四、从预案到日常:让文档保持活性的三个机制
预案最大的敌人不是灾难,是过期。三个机制能让它保持活性。其一,联系方式与值班表强制挂钩:预案里的每个电话与升级路径从值班系统自动同步,人岗变动即更新——本案里"拨备用号"的两分钟就是联系方式过期交的学费。其二,整改闭环跟踪表:每次演练产出的整改项进统一跟踪表,每条有责任人与期限,下次演练先验收上期整改——没有闭环机制的演练,产出的是文档不是能力。其三,预案版本与演练记录绑定:每次演练对应一个预案版本号,改过预案就重跑相关场景,保证"练过的就是用的"。
还有一条写给管理者:演练通过率不是团队 KPI。如果演练总是满分,说明场景设计太温柔——真正有价值的演练一定会暴露问题,暴露越多、修复越早,账越划算。把"演练发现了 N 个问题并全部闭环"当正面指标,把"零问题通过"当场景设计失败的信号,这个观念转过来,容灾建设才算上了正轨。
问题一:小公司没有灾备机房怎么办? 把"站点级"替换为"云上副本":核心库用 Data Guard 同步到云端托管环境,成本按月付、规模随需调。RTO 与 RPO 指标不变,资产从"第二机房"变成"一条专线加一个云订阅",预案的分级、授权、回退线照常成立。
问题二:预案应该详细到什么程度? 判断标准是"压力下的执行者需要什么"。详细到动作与预期输出,但不逐字写命令语法——那是值班员的基本功,预案只写"执行哪份手册的哪个流程"。写成命令大全的后果是每次工具升级预案就作废,半年后没人再信它。
问题三:怎么向管理层要演练的预算与时间? 用事故概率乘损失金额的语言谈:一次 RTO 超标的真实事故的损失,通常覆盖十年演练成本。再配上本案的对照——超时 1 分钟换来的三条整改都是文档级问题,几小时可修复;同样的差距出现在真实灾难里,代价按分钟计。演练是把事故成本兑换成办公时间成本的手段。
问题四:预案里要不要写具体命令? 分界线是"应急手册"与"操作手册"分开:预案写动作与预期输出("执行恢复流程 B,预期归档重演完成",不写语法),命令细节放在被引用的操作手册里。这样预案稳定(不随工具版本腐烂),手册独立演进,两者用编号互相引用——混写在一起的预案,半年后既不是好预案也不是好手册。
本节要点回顾
- 先谈数再选型:RTO 与 RPO 是和业务方谈出来的制度数字,全部技术投入的标尺。
- 四级场景授权前置:L1、L2 值班员动手,L4 明确到决策人名字——灾难里最贵的是等决定。
- 动作带预期输出、路径带回退线:压力下的人需要核对点与止损点,不是知识。
- 演练验的是预案不是人:拉闸式演练的产出是整改清单,颗粒度不足的预案一次现形。
- 活性三机制:联系方式自动同步、整改闭环跟踪、版本与演练绑定——预案过期比没有更危险。
第 5 章解决了"停"的问题。下一章回到日常的另一端:系统没停、但人人喊慢的时候,性能诊断就该登场了。