6.1 性能诊断工具
6.1 性能诊断工具
本节摘要:性能诊断的第一戒律是先看数据再动手。Oracle 自带一套完整的取证体系:AWR 快照是全库病历、ASH 是实时监控、v$ 视图是第一手证据。本节把 AWR 报告拆成四段教读,并用一次"现在正慢"的实时会诊演示工具链的配合。
一、诊断的第一原则:先看数据再动手
性能故障与别的事故不同:它多数时候"还活着",只是难受。这带来一个致命诱惑——趁"活着"赶紧调点什么。参数改一个、索引加一个、缓存冲一下,碰好了算是医术,碰坏了连病根都找不到。诊断工具存在的意义就是把"赶紧做点什么"的冲动换成"先看看数据说了什么"。Oracle 从 10g 起把这套取证做成了默认开启的自动体系:内核每小时给全库拍一份快照(工作负载画像)存进 AWR,出事后任意时段的"体检报告"都能生成。你要练的不是工具操作——点几下鼠标的事——而是报告的读法:哪段是结论、哪段是噪音、哪段在暗示下一个查询。
二、AWR 报告的四段读法
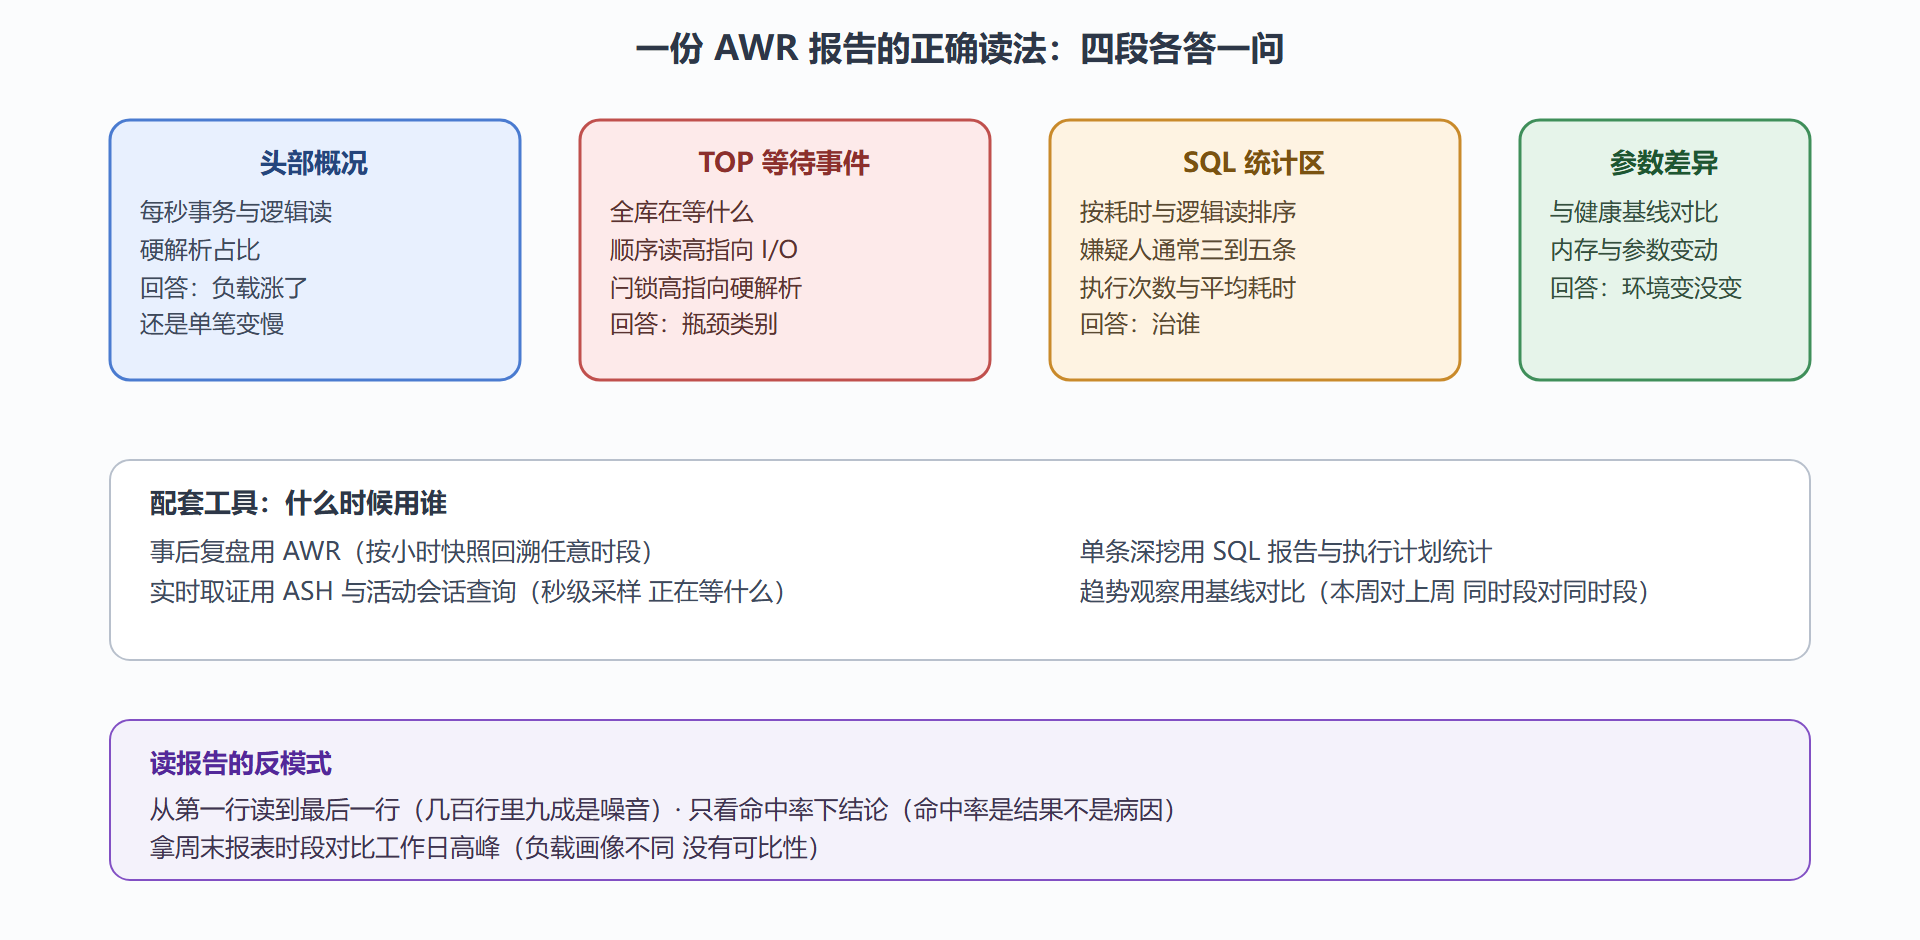
一份几百行的 AWR 报告,真正要读的只有四段。第一段:头部概况——时段、实例负载画像(每秒事务数、逻辑读、硬解析比),先判断这个时段是"负载涨了"还是"单笔变慢了",两者的处方完全不同。第二段:TOP 前台等待事件——全库会话的时间都花在等什么上,DB 顺序读占大头指向 I/O,库缓存锁占大头指向硬解析,这是报告的结论区。第三段:SQL 统计区——按消耗排序的 TOP SQL 清单,每条的执行次数、平均耗时、逻辑读,性能问题的嫌疑人名单就在这里,通常是三到五条。第四段:参数与配置差异——和健康基线比,初始化参数、内存配置有没有被动过。
-- 生成指定时段的 AWR 报告(先查快照对) SELECT snap_id, begin_interval_time FROM dba_hist_snapshot ORDER BY snap_id DESC FETCH FIRST 10 ROWS ONLY; -- 两个方式取报告:工具包过程或查询预构建的报告列表 SELECT output FROM TABLE(dbms_workload_repository.awr_report_html( :dbid, :inst_id, :begin_snap, :end_snap)); -- 快照策略可调:默认每小时一张、保留八天 EXEC dbms_workload_repository.modify_snapshot_settings(interval => 30, retention => 15*24*60);
图 6-1:AWR 报告四段读法与信息流向
三、实时取证:等不了下一张快照时
AWR 是病历,看病历要等小结;会话正在疼的时候用 ASH(活动会话历史)与 vsession 做实时取证。vsession 一眼看清"现在谁在等谁":每一秒对全部活动会话采样,等待事件、等待对象、阻塞会话尽在眼前。ASH 把这些采样按秒存档,既补了 AWR 小时级粒度的粗,又不至于像全量跟踪那样把库压垮——1:1000 的采样率就是为此设计的。
-- 实时:现在谁在等什么(当前活动会话全息) SELECT sid, username, event, wait_class, seconds_in_wait, blocking_session, final_blocking_session FROM v$session WHERE status = 'ACTIVE' AND username IS NOT NULL; -- 近十分钟:哪些等待占了大头(ASH 聚合) SELECT event, COUNT(*) AS samples, ROUND(RATIO_TO_REPORT(COUNT(*)) OVER () * 100, 1) AS pct FROM v$active_session_history WHERE sample_time > SYSDATE - 10/1440 AND session_state = 'WAITING' GROUP BY event ORDER BY samples DESC FETCH FIRST 8 ROWS ONLY;
两段查询是"现在正慢"场景的固定开场:第一段抓现行,第二段看十分钟的趋势构成。绝大多数投诉在它们面前现出原形——要么某事件一枝独秀(I/O 或锁),要么 TOP SQL 的每秒逻辑读异常(烂 SQL 在烧 CPU)。
四、案例:把"系统卡"翻译成处方
背景。 客服总监的"系统卡"投诉,值班员按本节流程走一遍:先问时段——13:30 起;再问范围——客服工单模块为主。
操作。 调 13:30 至 14:30 的 AWR:头部概况显示每秒事务数与平时持平——不是负载涨了;TOP 等待事件里"日志文件同步"从基线的 2 毫秒涨到 41 毫秒,占比第一。SQL 统计区第一名是一条工单状态更新,每小时执行 6 万次——高频小事务全部卡在提交等待上。换 ASH 验证实时:会话的等待确为日志文件同步。三段证据指向同一处:重做日志写盘变慢。
结果。 顺着日志 I/O 查下去,归档日志所在卷上一小时前新挂了一个备份作业,争抢同一块盘的带宽。备份作业挪到 23 点窗口,等待事件 5 分钟内回落到 3 毫秒,投诉结案。解读。 这次会诊的完整链路值得背下来:主诉翻译成时段与范围、AWR 头部排除负载因素、TOP 事件定性、TOP SQL 定位、ASH 实时验证、最后追到 I/O 的物理层。每一步都是"证据推着走",没有一步是猜的。变式。 若 TOP 事件是"缓冲区忙等待"且对象集中在一张表,方向就换成 3.2 的锁与热点块分析——同一份报告,TOP 事件不同,通向完全不同的章节。这也说明性能诊断不是孤立技能:等待事件是全册知识的一张索引表。
五、常见问题
⚠️ 常见坑:诊断版(Diagnostic Pack)的授权边界。AWR、ASH 属于诊断包,标准版许可不含,误用属于许可违约——社区版替代品(Statspack 或自建采样)可以合法顶上。接手环境先搞清许可版本,再决定用哪套工具。
问题一:快照间隔改成 15 分钟值不值? 看粒度需求:故障多为几分钟内的突刺时,小时级快照会"平均掉"病灶,15 分钟粒度能抓住;代价是存储与生成开销翻四倍。折中方案是常态一小时、出事时段手工打密集快照——把粒度当取证动作用,而不是常态开销。
问题二:ASH 的采样能代表真实负载吗? 统计意义上可以——它是 1:1000 的系统抽样,等待分布的比例结构基本不失真,但绝对次数不能直接当真值用。读 ASH 聚合看占比与排序,不看总数;需要精确计数的场景回到 AWR 或 v$ 计数器。
问题三:怎么建立"健康基线"? 挑业务平稳的周做一条 AWR 基线(时段对齐工作日高峰),之后每次诊断都先与基线对比差异项。基线在版本升级、扩容、大促后要重新采集——过期基线的误导性比没有基线更强,它会让"本来就该慢"被误判为新病灶。
本节要点回顾
- 四段读法:头部辨负载、TOP 事件定性、SQL 区点名、参数段查变动——顺序读,别通读。
- AWR 管复盘、ASH 管现行:小时级快照回溯历史,秒级采样抓现场,两者是接力不是二选一。
- 等待事件是索引表:日志同步指向重做 I/O,缓冲忙指向热点块,不同事件通向不同章节。
- 许可先于工具:AWR/ASH 是付费诊断包组件,标准版环境用 Statspack 替代。
病人定位到了,下一节开处方:TOP SQL 的降耗全流程。