6.2 SQL调优
6.2 SQL调优
本节摘要:TOP SQL 的处方有固定顺序:先看执行计划合不合理,再查统计信息新不新鲜,然后才轮到索引与改写——顺序错了常常白忙。本节给出完整的处方流程,并用一次从 41 秒到 1.3 秒的降耗记录演示每一步的实际收益。
一条 SQL 的降级史
报表库一条月度汇总 SQL,历史上 8 秒,某月开始 41 秒。业务的抱怨可以理解,但"修好它"需要先回答三个问题:它在做什么(执行计划)、它对未来的假设对不对(统计信息)、它的写法是不是在跟优化器对着干(改写空间)。本节就按这三个问题展开,最后把这条 41 秒的 SQL 当病例,完整走一遍处方流程。
一、处方顺序:为什么先计划、再统计、后索引
第一步看执行计划,是因为它是唯一能告诉你"这 41 秒花在哪"的证据:哪步全表扫了、哪步估算行数与实际差了量级、连接顺序是不是反的。4.3 讲过读法,这里补一个效率技巧——拿 display_cursor 的 ALLSTATS LAST 输出,直接对比每步的估算行与实际行,偏差最大的那步就是案发点,比逐行审快得多。
第二步查统计信息,因为四成以上的计划劣化是统计过期惹的祸:last_analyzed 太旧、变更量超阈值没触发重收集、直方图缺失导致倾斜列估算失真。修统计常常比加索引便宜得多,而且不引入新的维护负担——所以它排在索引前面。
第三步才谈索引与改写。索引的纪律在第 2 章与 4.1 铺垫过,这里给一张快速决策表:
| 证据 | 处方 | 注意 |
|---|---|---|
| 高频等值查询走全表扫 | 建 B 树索引 | 确认选择性好,否则白建 |
| 范围与排序混合查询 | 索引按"等值列在前、范围列在后"排 | 列顺序错则后半段失灵 |
| WHERE 只用列的前缀 | 考虑函数索引或改写 | 隐式转换是常见元凶 |
| 低选择性列(状态、类型) | 位图仅限读多写少的库 | OLTP 用位图是灾难 |
| 大表 JOIN 小表反复回表 | 覆盖索引把所需列全带上 | 列多则索引过胖,得不偿失 |
改写的弹药库在 4.1 已经备齐(窗口函数、递归、批量),这里的提醒只有一条:改写前先跑一次 SQL 顾问(SQL Tuning Advisor),它是官方的自动体检,偶尔能发现人眼漏掉的改写点,但它给的方案也要按本节的证据链复核——顾问意见是线索不是结论。
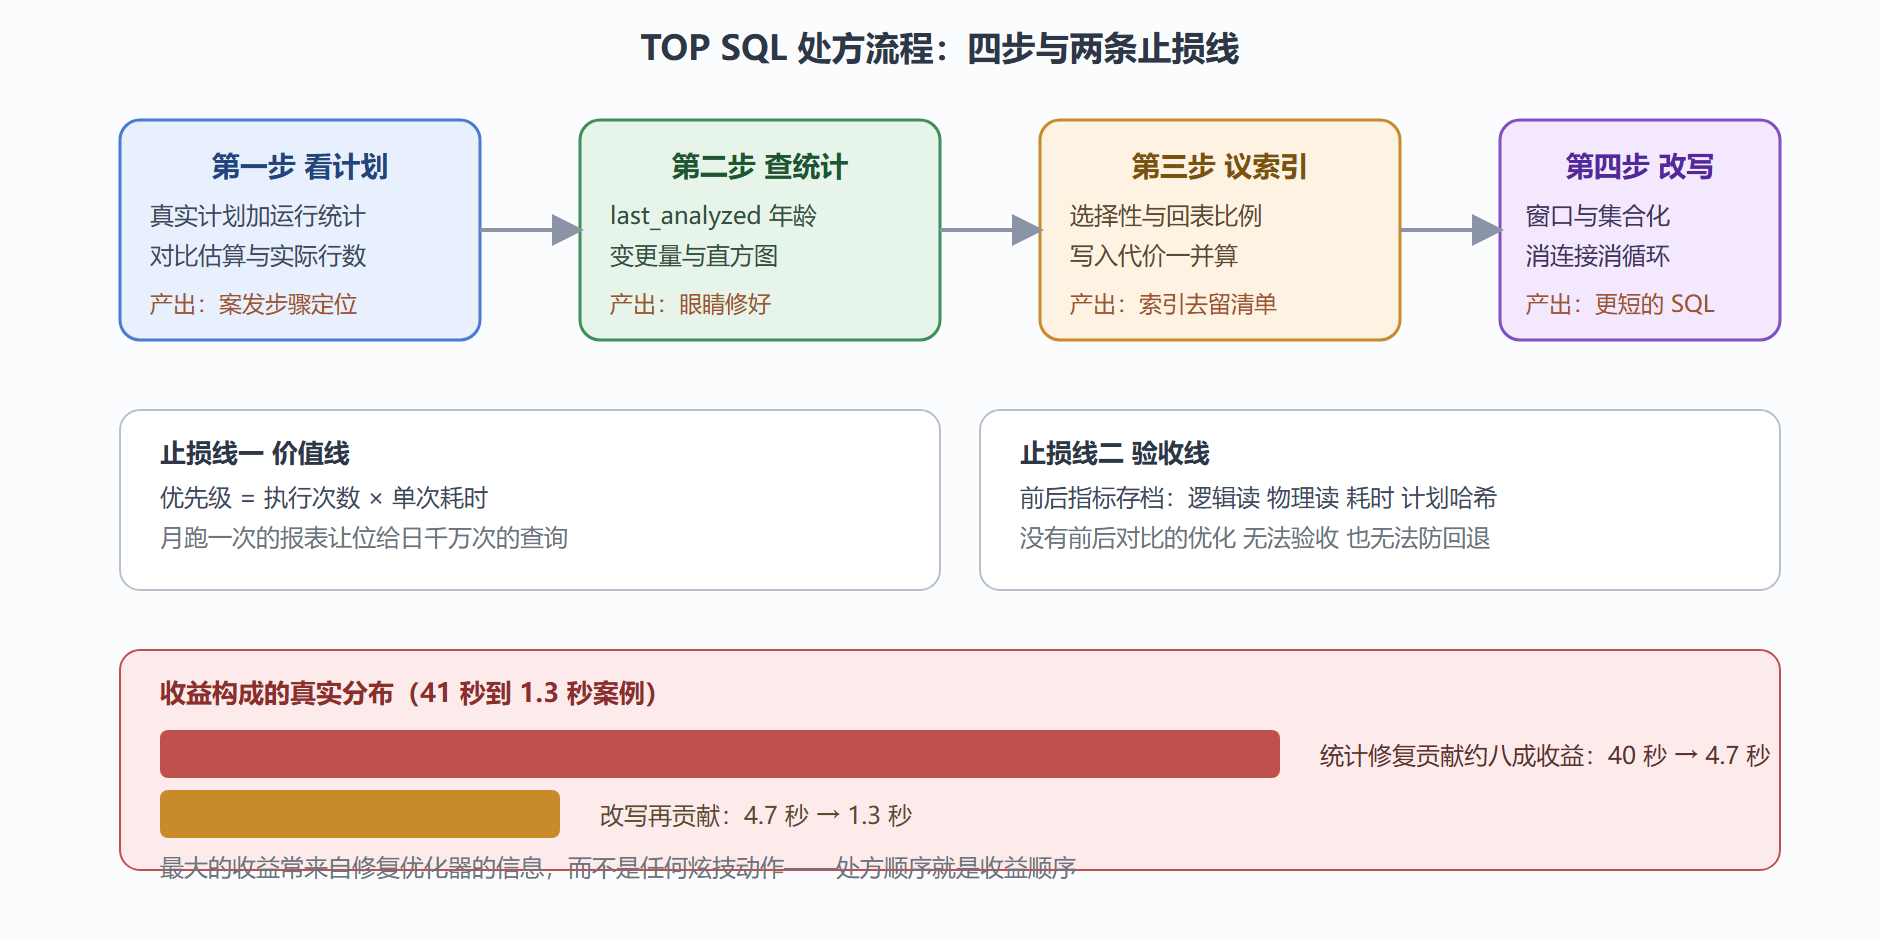
图 6-2:TOP SQL 处方流程与止损线
二、案例:41 秒到 1.3 秒的完整病历
背景。 月度汇总 SQL:从五千万行的交易明细按商户、按日聚合,关联商户维表,输出当月报表。月初开始 41 秒,业务要压回 10 秒内。
操作。 按处方顺序走。第一步抓真实计划:第 3 步对明细表做全表扫,估算行数 80 万、实际 5200 万,偏差两个数量级——案发点锁定。第二步查统计:last_analyzed 停在 40 天前,而这表每天进 180 万行——统计严重过期;同时过滤列(交易日期)没有直方图。第三步动手:收集统计(cascade 带索引、对倾斜列 size auto),计划立刻变了——日期过滤走了分区裁剪加本地索引,估算行数与实际只差 8%。
结果。 41 秒降到 4.7 秒。还没到 10 秒目标内就收手吗?不——继续第四步看计划细节:聚合前的排序占了 2.8 秒,而 GROUP BY 的列组合本来就有对齐的索引,排序本可省去。加提示让聚合走索引序,4.7 秒再降到 1.3 秒。总收益 30 倍,其中统计修复贡献了约 8.7 倍,改写提示贡献了 3.6 倍。
解读。 这份病历的真正教益在收益构成:最大的一刀来自修复优化器的眼睛,而不是任何"优化动作"。很多团队的第一反应是加索引或上缓存,那是把顺序整个倒过来——统计是坏的,新索引反而可能被坏估算骗着走错。变式。 若统计修复后计划没变化,下一站查优化器环境:这条 SQL 是不是被旧版 hint 或 SQL 计划基线(SQL Plan Baseline)钉死在老计划上——基线机制是防计划突变的保险,也会把劣化计划锁成"永久的病",查 dba_sql_plan_baselines 一目了然。
-- 病历里的关键动作存档 -- 1. 真实计划与运行统计(对比估算与实际) SELECT * FROM TABLE(dbms_xplan.display_cursor(:sql_id, NULL, 'ALLSTATS LAST')); -- 2. 修统计:带索引、倾斜列自适应直方图 EXEC dbms_stats.gather_table_stats('RPT','TXN_DETAIL', - cascade=>TRUE, method_opt=>'FOR ALL COLUMNS SIZE AUTO'); -- 3. 排序消除:确认聚合列有对齐索引后,用索引序聚合 SELECT /*+ index(TXN_DETAIL ix_txn_date_mchnt) */ ... -- 4. 长期防复发:捕获基线,允许优化器演进但禁止突变 EXEC dbms_spm.load_plans_from_cursor_cache(sql_id => :sql_id);
三、调优的边界与习惯
三条经验之谈收尾。其一,设止损线:一条 SQL 的调优投入以业务价值封顶——月报跑 40 秒但一个月只跑一次,30 倍优化的意义远小于把日均千万次的 2 秒压到 0.5 秒;TOP SQL 清单里"执行次数乘单次耗时"才是优先级排序的真依据。其二,每次优化记录前后指标:逻辑读、物理读、耗时、计划哈希值——没有前后对比的优化无法验收,也无法在下一次劣化时判断"是回退了还是环境变了"。其三,警惕负优化:新计划在测试集更快、在生产的数据分布上更慢的案例真实存在,上线前用生产采样数据验证,上线后盯一天的执行统计。
💡 关键直觉:SQL 调优的成熟标志不是会多少 hint,而是对"先证据后动作"的纪律感。计划、统计、索引、改写这个顺序不是流程洁癖——它是"最大收益的动作排在最便宜的动作后面"这条经济学规律的体现。
四、常见问题
问题一:为什么加索引后反而变慢了? 索引是双刃账:查询受益,写入多付一份索引维护费,且优化器可能被诱导走一条"低效索引扫描加海量回表"的路。判断依据是回表比例——按索引取回的行里最终被过滤掉的比例越高,索引越亏。建索引前估算选择性,建完对比前后计划,这两步不能省。
问题二:统计信息收集会不会影响在线业务? 有影响但可控:收集本身消耗 I/O 与临时空间,大表全量采样会持续数十分钟。对策是分级——大表用自动采样率、增量收集(只统计变更分区)、或安排在维护窗口;报表前置的宽表用加载即收集。把收集的代价显式排进维护日历,而不是放任夜间自动作业与跑批互相踩踏。
问题三:hint 应该怎么写才不是隐患? 三条纪律:写在注释提示里而不是改 SQL 语义、每条 hint 配一行"为什么用它"的注释、定期复核(版本升级后 hint 的含义与最优解都可能变化)。能做到这三条,hint 就是精准的外科手术;做不到,它就是埋进代码的技术债。
本节要点回顾
- 处方顺序:计划、统计、索引、改写——先看证据,再做便宜的修复,最后上重的手段。
- 收益大头在统计:过期统计与缺失直方图贡献了多数"突然变慢",修复它们最便宜。
- 优先级看乘积:执行次数乘单次耗时,才是 TOP SQL 排队的真依据,别被单次绝对值迷惑。
- 记录与防突变:前后指标存档是验收依据;SQL 计划基线防突变,也可能锁死劣化计划。
SQL 级的处方开完了。下一节处理"SQL 都没病、库还在喘"的情况——内存、检查点、I/O 与资源隔离的系统级旋钮。