6.3 系统级调优
6.3 系统级调优
本节摘要:TOP SQL 都治好了、库还在喘,病根通常在系统层:内存配比、检查点节奏、I/O 分布、资源争抢。本节拆这四个旋钮的工作原理与调节方法,并用资源管理器解决"月末跑批拖垮交易"的经典冲突。
一、SQL 之外还有半壁江山
6.2 的处方治好了单条 SQL,但有一类投诉它治不了:没有哪条 SQL 特别慢,全库都"钝"——提交变慢、响应毛刺、高峰期整体延迟抬升。这类症状指向系统层。系统级调优的四个旋钮按出场频率排序:内存(SGA/PGA 配比与自动管理)、I/O(数据文件与日志文件的分布)、检查点(恢复速度与运行压力的取舍)、资源调度(谁可以占用多少)。本节逐个拆,但先立一条军规:系统级参数的每一次变更都要有前后计量与回滚方案——参数是全局的,一个坏参数能拖垮整库,而"改完感觉快了"不是计量。
二、四个旋钮逐个拆
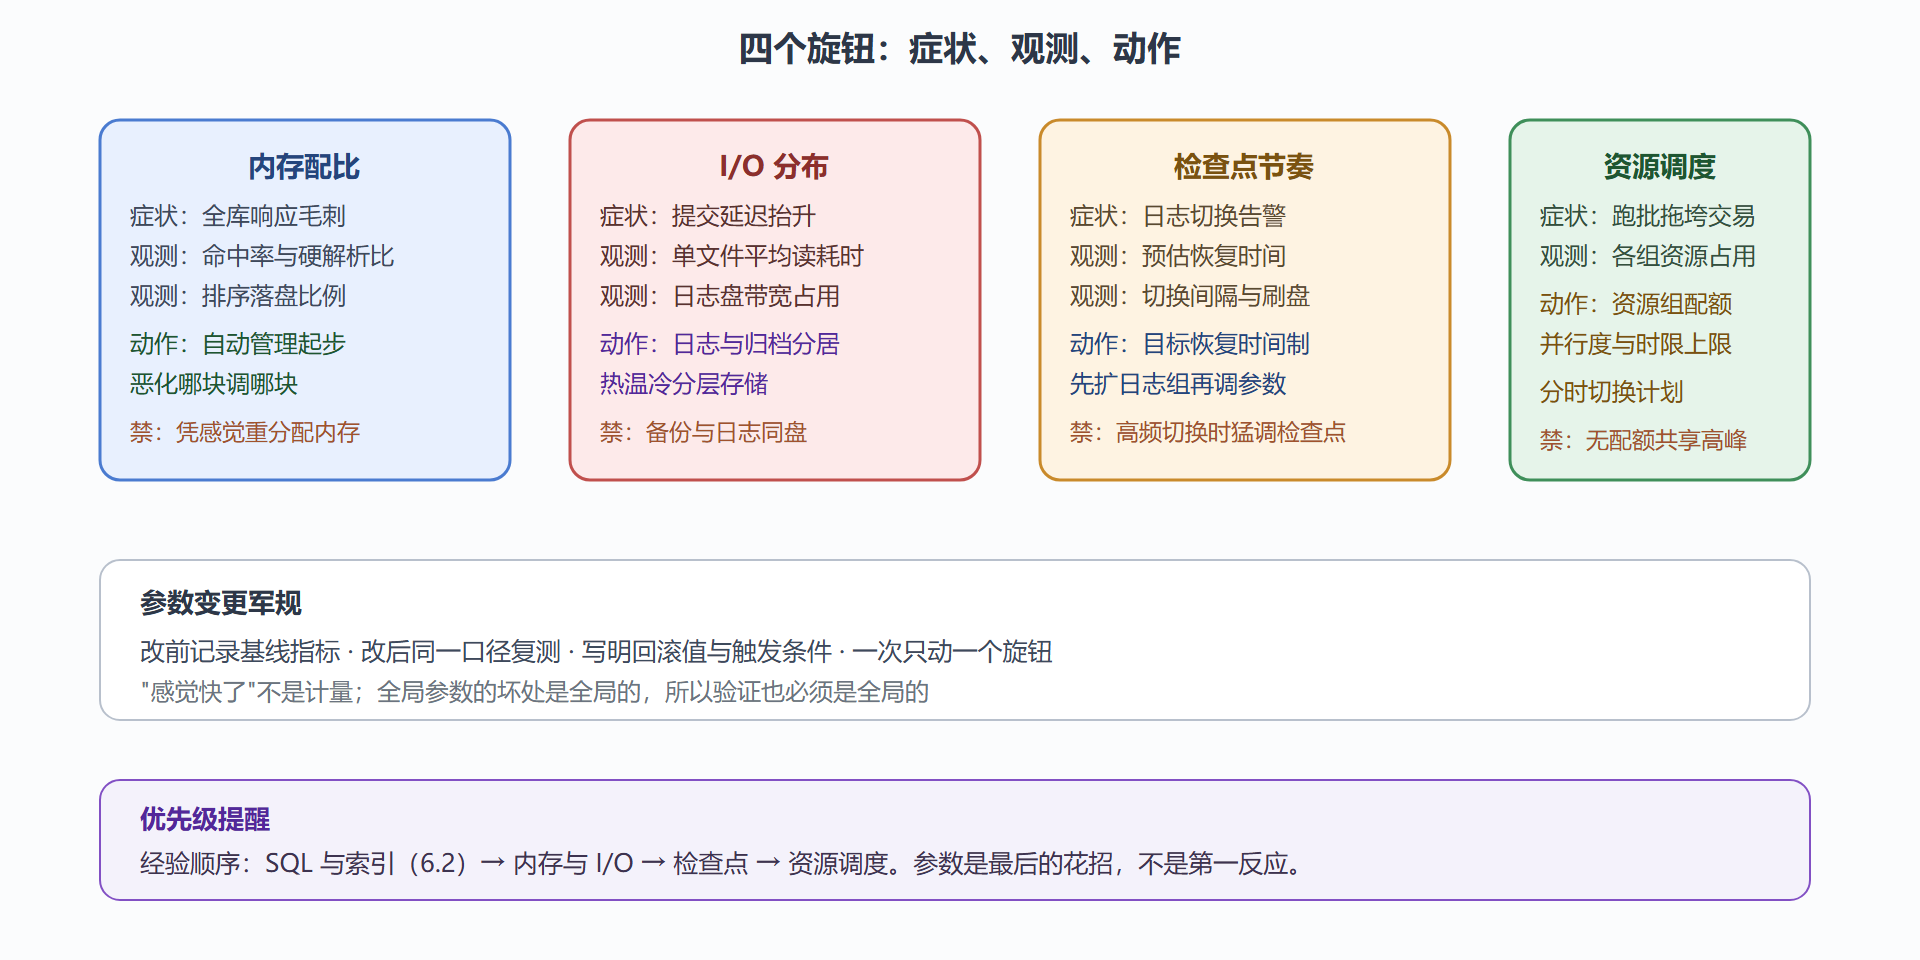
内存旋钮。 2.1 讲过结构,这里讲配比纪律:现代版本起步就用自动管理(memory_target 或 sga_target 加 pga_aggregate_target),手工逐池配比只在自动管理顾不过来的极端负载下介入。检查内存健康的三块表:缓冲缓存命中率(vsysstat 逻辑读与物理读之比)、共享池的硬解析率(vsysstat 解析统计)、PGA 的排序落盘比例(vpgastat 与 vsql_workarea)。哪块恶化调哪块,别凭感觉重分配。
I/O 旋钮。 原则一句话:把争抢的对手分开住。在线重做日志(顺序写、提交路径上、最怕延迟)必须独享最快存储,绝不与归档、备份、数据文件混居——6.1 案例里那个备份作业争抢日志盘的事故就是反面教材。数据文件按负载分热温冷:热点小表与索引放高速层,历史大表放容量层。诊断工具是 AWR 的 I/O 统计段与 v$filestat:单文件的平均读耗时显著高于同伴,就是分布失衡的证据。
检查点旋钮。 2.2 讲过机制,这里讲取舍:检查点越勤,崩溃恢复越快,但运行期 DBWn 刷盘压力越大。调节依据是一对观测值——预估的恢复时间(v$instance_recovery 的 estimated_mttr)与增量检查点触发的刷盘节奏。联机事务系统通常设目标恢复时间几分钟,让内核自动调节;发现日志切换频繁报"检查点未完成"(2.2 案例的复现路径),先加日志组容量再动检查点参数。
资源调度旋钮。 前三个旋钮管"总量",资源管理器(Database Resource Manager)管"分配":给不同业务组定义 CPU 份额、并行度上限、会话数上限、甚至执行时长上限。月末跑批与在线交易共用一套库的冲突,靠它优雅收场。
图 6-3:系统级调优的四个旋钮与观测指标
三、案例:月末跑批不再拖垮交易
背景。 某支付平台月末结算批处理与在线交易共用一套库。每逢月末 1 日零点后的两小时,交易接口 P99 延迟从 80 毫秒飙升到 2 秒,客诉集中爆发。6.2 的方法用过了:TOP SQL 都健康,没有可治的单条语句。
操作。 AWR 对比正常日与事故日:事故日的 CPU 与 I/O 总量并未翻倍,但"并发"结构变了——批处理会话从 20 个涨到 60 个,并行查询大量启动,CPU 排队(调度器等待事件)显著。诊断结论:总量够、分配乱,批处理把在线业务的资源挤占干净。方案用资源管理器分时段配额:
-- 建资源计划:白天在线优先,月末窗口批处理限额 BEGIN dbms_resource_manager.create_plan(plan => 'MONTH_END_PLAN'); dbms_resource_manager.create_consumer_group( consumer_group => 'ONLINE_GRP', comment => '在线交易'); dbms_resource_manager.create_consumer_group( consumer_group => 'BATCH_GRP', comment => '月末批处理'); dbms_resource_manager.create_plan_directive( plan => 'MONTH_END_PLAN', group_or_subplan => 'ONLINE_GRP', mgmt_p1 => 70, parallel_degree_limit_p1 => 4); dbms_resource_manager.create_plan_directive( plan => 'MONTH_END_PLAN', group_or_subplan => 'BATCH_GRP', mgmt_p1 => 25, parallel_degree_limit_p1 => 8, switch_group => 'KILL_GRP', switch_time => 1800); -- 单会话超30分钟强制降级 dbms_resource_manager.submit_pending_area; END; / -- 批处理作业连接时切换到批处理组 EXEC dbms_session.switch_current_consumer_group('BATCH_GRP'); -- 计划启用与分时调度(月末自动切换由调度器触发) ALTER SYSTEM SET resource_manager_plan = 'MONTH_END_PLAN';
结果。 下一个月末窗口实测:交易 P99 稳定在 110 毫秒以内,批处理完成时间从 2.1 小时延到 2.6 小时——用批处理慢 24% 换交易延迟降 94%,业务方确认接受。解读。 这类冲突的本质是"资源在错误的主体之间分配",资源管理器的价值是把分配规则写进内核而不是靠跑批团队的自觉。注意配额设计的细节:在线 70%、批处理 25%、留 5% 余量给系统进程;给批处理更高的并行度上限(它值得用并行换时间);配逃生舱(超时会话强制降级)防止批处理组自己内讧。变式。 若平台已上 RAC,还可以按服务(Service)把批处理固定调度到其中一个节点,节点级隔离比资源组隔离更彻底——代价是该节点的容灾冗余变相减半,双节点集群要慎用。
⚠️ 常见坑:一上来就调 optimizer 相关的隐式参数。网上流传的"优化参数清单"多数针对十年前的版本与特定负载,照抄进现代版本常常负优化。版本内置的自动管理(内存、PGA、检查点)在绝大多数场景优于手工微调,动它们之前先让 6.2 的证据链说话。
问题一:资源计划开错了怎么紧急回退? 一条命令切回空计划:把 resource_manager_plan 置空(或切回默认计划),资源分配立即恢复"先到先得"。这也是军规里"写明回滚值"的示例——计划上线前就把回退命令写在变更单上,紧急时不用临场翻文档。
问题二:并行度给多少合适? 默认交给自动并行度管理,人工干预只在两个方向:批量窗口内的作业显式给高并行度(用满窗口换时间),在线高峰期对报表类会话限并行甚至禁并行(防大查询独占资源)。按"时段不同、对象不同、额度不同"的思路配,比全局一个值合理得多。
本节要点回顾
- 症状即导航:毛刺查内存、提交慢查日志 I/O、切换告警查检查点、争抢查资源分配——先定性再动手。
- I/O 分居原则:重做日志独享最快存储,绝不与归档备份混居;数据文件按热温冷分层。
- 检查点是取舍:目标恢复时间制让内核自动平衡恢复速度与刷盘压力;先扩日志组再调参数。
- 资源管理器管分配:在线与批处理的冲突用配额、并行度、超时降级三件套写进内核,自觉靠不住。
第 6 章把"慢"诊完了。下一章转向"不能说的泄露":谁有权限、数据是否加密、谁动过记录——安全与审计。