1.1 Selenium是什么:二十年从萌芽到标准
1.1 Selenium是什么:二十年从萌芽到标准
本节摘要:Selenium 是一个通过 WebDriver 协议驱动真实浏览器、把人工页面操作转成可重复脚本的开源自动化测试框架。它的核心概念只有五个:驱动会话、浏览器驱动、被测元素、定位器与等待。理解它二十年从 JavaScript 注入到 W3C 标准的演化史,是理解后续所有架构设计与兼容性问题的钥匙——本节是全册的起点,第 2 章的架构拆解、第 3 章的定位排错都建立在这份历史坐标之上。
一张工单:浏览器一升级,脚本全线阵亡
先看本册的第一张工单。某团队的回归套件在周五还全绿,周一晨会前突然集体报错,报错信息清一色是"session not created:此版本驱动仅支持某区间的浏览器版本"。排查了半天代码,一无所获——代码一行没改。最后发现是运维周末统一升级了办公网与流水线节点的浏览器版本,而浏览器驱动没有跟着换。
这张工单的迷惑性在于:故障不在你写的脚本里,而在脚本与浏览器之间的那层"翻译"。要看懂这层翻译,就得回到 Selenium 的演化史——它是怎么一步步从"往页面里注入 JavaScript 的补丁"变成"有国际标准、有独立驱动体系的工程设施"的。看懂了这条线,你遇到驱动版本、协议差异、浏览器兼容这类工单时,就不会当作玄学处理。
从报价系统的手工苦役说起
2004 年,ThoughtWorks 的 Jason Huggins 负责一个内部报销与报价系统。那个年代没有几个像样的测试工具,验证一次业务流程意味着人工把几十个页面点一遍。Huggins 的解法很直接:写一段 JavaScript,让浏览器自己重复这些点击与断言。这套工具被命名为 JavaScriptTestRunner,后来更名 Selenium——名字是个玩笑,用来嘲讽某个竞争对手的开发者的自嘲式回应,却意外好记。
第一代方案 Selenium Core 的原理是"注入脚本":把测试逻辑以 JavaScript 形式塞进被测页面里执行。它绕不开浏览器最古老的安全铁律——同源策略:注入的脚本只能操作与自身同域的页面。于是测试人员得先把 Core 部署到被测站点所在的服务器上,工程上极其别扭。第二代 Selenium RC 用了个聪明的绕法:由一个代理服务器负责"改写"请求,让测试脚本看起来与被测页面同源。能用,但代理层拖慢速度,也让诡异的环境问题成了家常便饭。
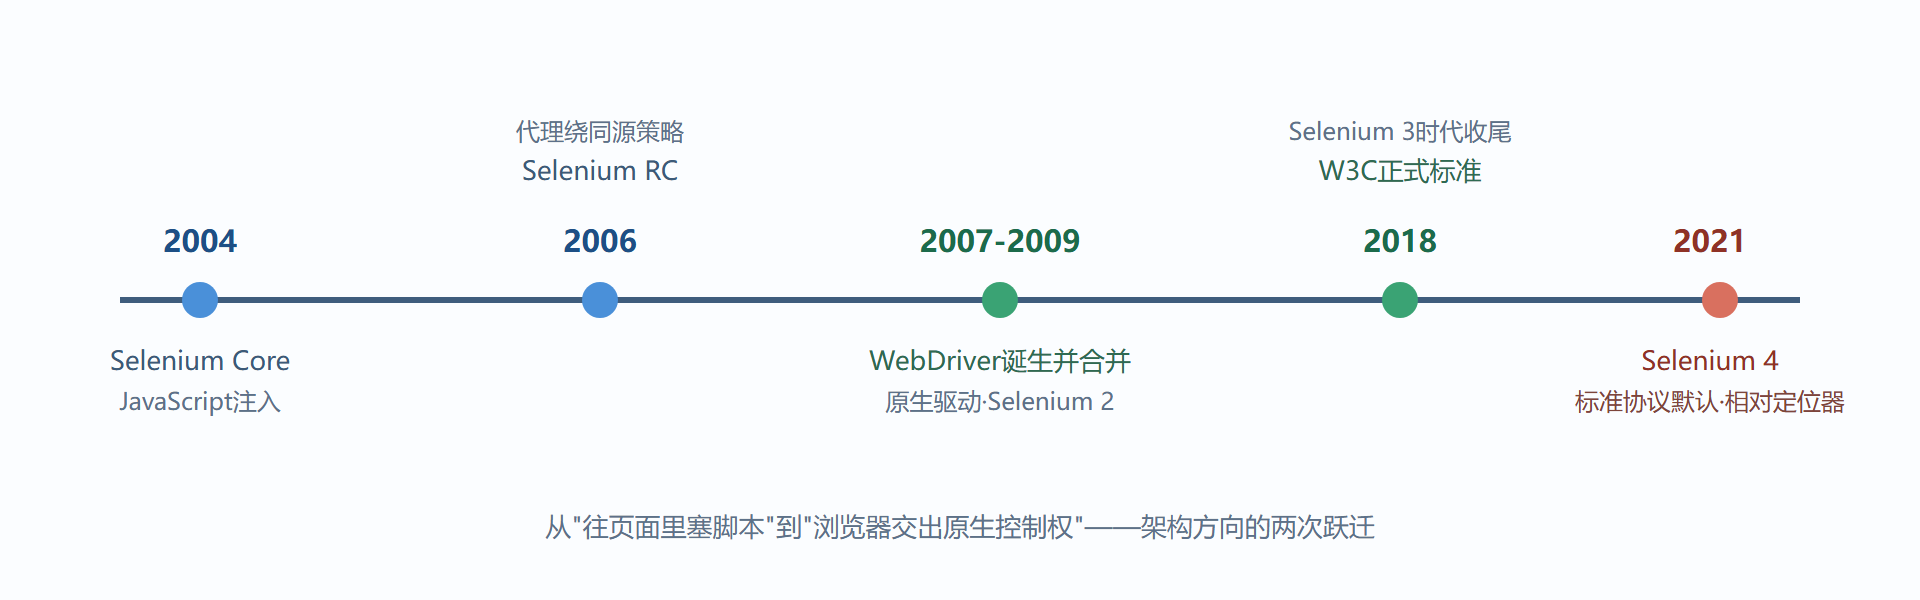
真正的分水岭出现在 2006 年前后。Google 的 Simon Stewart 认为注入与代理都是权宜之计,另起炉灶写了 WebDriver:不再往页面里塞代码,而是让每个浏览器通过自己的原生自动化接口接收指令——浏览器把一部分控制权直接交给驱动程序。这条路快、稳、不受同源策略摆布。2009 年,Selenium 与 WebDriver 两个项目合并,也就是后来大家熟知的 Selenium 2;再往后,2018 年 W3C 把 WebDriver 定为正式推荐标准,2021 年 Selenium 4 发布,标准协议成为默认。
图1-1 Selenium二十年演化时间线
核心概念的五个名字
历史讲完,回到现在时。今天说"用 Selenium 写自动化",实际指的是一套分工明确的组件,你只需要先记住五个名字。
WebDriver 是统称的自动化协议与接口层:你的测试代码调用它,它把"点击这个按钮"翻译成协议报文发给浏览器。浏览器驱动是每个浏览器配套的独立可执行文件,比如 Chrome 与 Firefox 各有对应的驱动程序,它接收协议报文,转换成浏览器内部的原生调用——本节开头那张工单,卡住的就是测试代码、驱动、浏览器这三者的版本匹配。会话(session)是一次自动化运行在驱动里建立的完整上下文,从创建浏览器实例到退出,定位到的元素、设置的窗口尺寸都活在会话里。WebElement 是定位命中后返回的页面元素对象,你的所有交互都作用于它。定位器是"怎么在页面里找到元素"的策略描述,是第 3 章整整一章的主角。
另外一个常见的搭配也值得认识:Selenium 家族里还有两个老成员。Selenium IDE 是浏览器插件形态的录制回放工具,适合原型验证与入门演示,但录制产物脆弱,撑不起工程化回归;Selenium Grid 负责把脚本分发到多台机器、多个浏览器上并行执行,第 6 章会专门讲它。核心结论先记一句:IDE 管演示,WebDriver 管脚本,Grid 管规模。
演化史教会我们的三件事
第一,Selenium 的每次架构跃迁都在回答同一个问题:如何让"脚本发出的指令"更接近"浏览器原生能做的事"。理解这一点,第 2 章看三层架构时你会有一种"原来如此"的顺畅感。第二,驱动与浏览器的版本匹配是自动化项目的第一个常态化运维点,不是故障而是日常——第 2 章的环境搭建会给出自动管理驱动的方案。第三,W3C 标准化意味着你今天写的脚本不绑死在某一家实现上:任何遵循标准的浏览器与驱动组合都能跑,这也是它能在企业里长期存在的根本原因。
收编进工单簿的三个常见疑问
问:Selenium 现在还值得学吗?新引擎都出这么多代了。 值得,理由在协议层而非情怀:标准协议意味着你学的不是某个产品,而是整个浏览器自动化领域的通用语言——日后换任何引擎,会话、定位、等待这套心智全部迁移。反过来只学过某家新引擎的工程师,理解协议细节时反而要补这一课。
问:Selenium IDE 录制的东西能不能直接用于正式回归? 只能当草稿。录制产物按"元素当时的样子"逐条记录,页面一改就碎,也没有等待与断言的设计空间。正确的用法是把录制当探索工具——快速确认流程可行性,然后按第 4 章的结构手写正式用例。
问:驱动版本不匹配为什么不能像浏览器一样自动更新解决? 其实从 Selenium 4.6 起已经基本自动化了(第 2 章 2.3 详述)。历史工单的价值在于理解机制:驱动与浏览器之间的私有通道决定了版本强绑定,理解了这层因果,遇到"会话未创建"类报错你第一反应就是查版本对,而不是重装环境碰运气。
一个动手观察练习
历史最好的消化方式是亲眼看看它留下的痕迹。打开任意一个网页,在开发者工具的控制台里执行一句查询——你会发现现代浏览器早已内置了自动化世界的接口:页面元素可以被枚举、属性可以被读取、事件可以被派发。二十年前 Selenium Core 往页面里塞的正是这类脚本;而今天,同样的能力经由标准协议由外部程序驱动,不再受同源策略的辖制。理解了这条演进线,你就理解了本册后续所有设计的原因:协议负责翻译,驱动负责落地,脚本负责表达意图——三者各司其职,始于那一个"让浏览器自己动起来"的朴素愿望。
收工清单
- Selenium 的本质:通过 WebDriver 协议驱动真实浏览器的开源自动化框架,强项是跨浏览器回归与端到端旅程验证。
- 演化主线:JavaScript 注入(2004)→ 代理绕行(2006)→ 原生驱动(2007 起)→ W3C 标准(2018)→ Selenium 4(2021)。
- 五个核心概念:WebDriver 协议、浏览器驱动、会话、WebElement、定位器,后续所有章节都在这五个词上展开。
- 工单 #001 的答案:驱动与浏览器版本必须配套,升级浏览器时同步更新驱动是运维动作,不是代码缺陷。
- 家族分工:IDE 管演示、WebDriver 管脚本、Grid 管规模,三者不互相替代。
下一节我们划清它的能力边界——知道它能做什么只是入门,知道它不该被用来做什么,才能避开项目立项时最贵的那些坑。