1.2 能测什么不能测什么:技术定位与适用边界
1.2 能测什么不能测什么:技术定位与适用边界
本节摘要:Selenium 的技术定位是 UI 驱动的端到端行为模拟器——它验证的是"用户在真实浏览器里能否走通业务",而不是"代码逻辑是否正确"。它的甜蜜区是回归测试、跨浏览器验证与核心旅程守护三大场景;它的禁区是单元逻辑、纯接口契约与像素级视觉比对。上一节建立了它的历史坐标,本节在这张坐标上圈出能力边界,并给出一套"三问判断法",让你在立项会上就能拦住注定失败的自动化方案。
先讲一个反例:最快的自动化,死于跑错了赛道
某电商团队决心搞自动化,第一期的成果是四百条 Selenium 用例,覆盖了优惠券金额计算的各种组合。半年后这套用例成了团队的负担:页面每次小改版,几十条用例跟着修;用例执行要开浏览器、等渲染,一轮跑三个小时;而它验证的金额计算逻辑,其实一个纯函数加十行单元测试就能覆盖,毫秒级出结果。
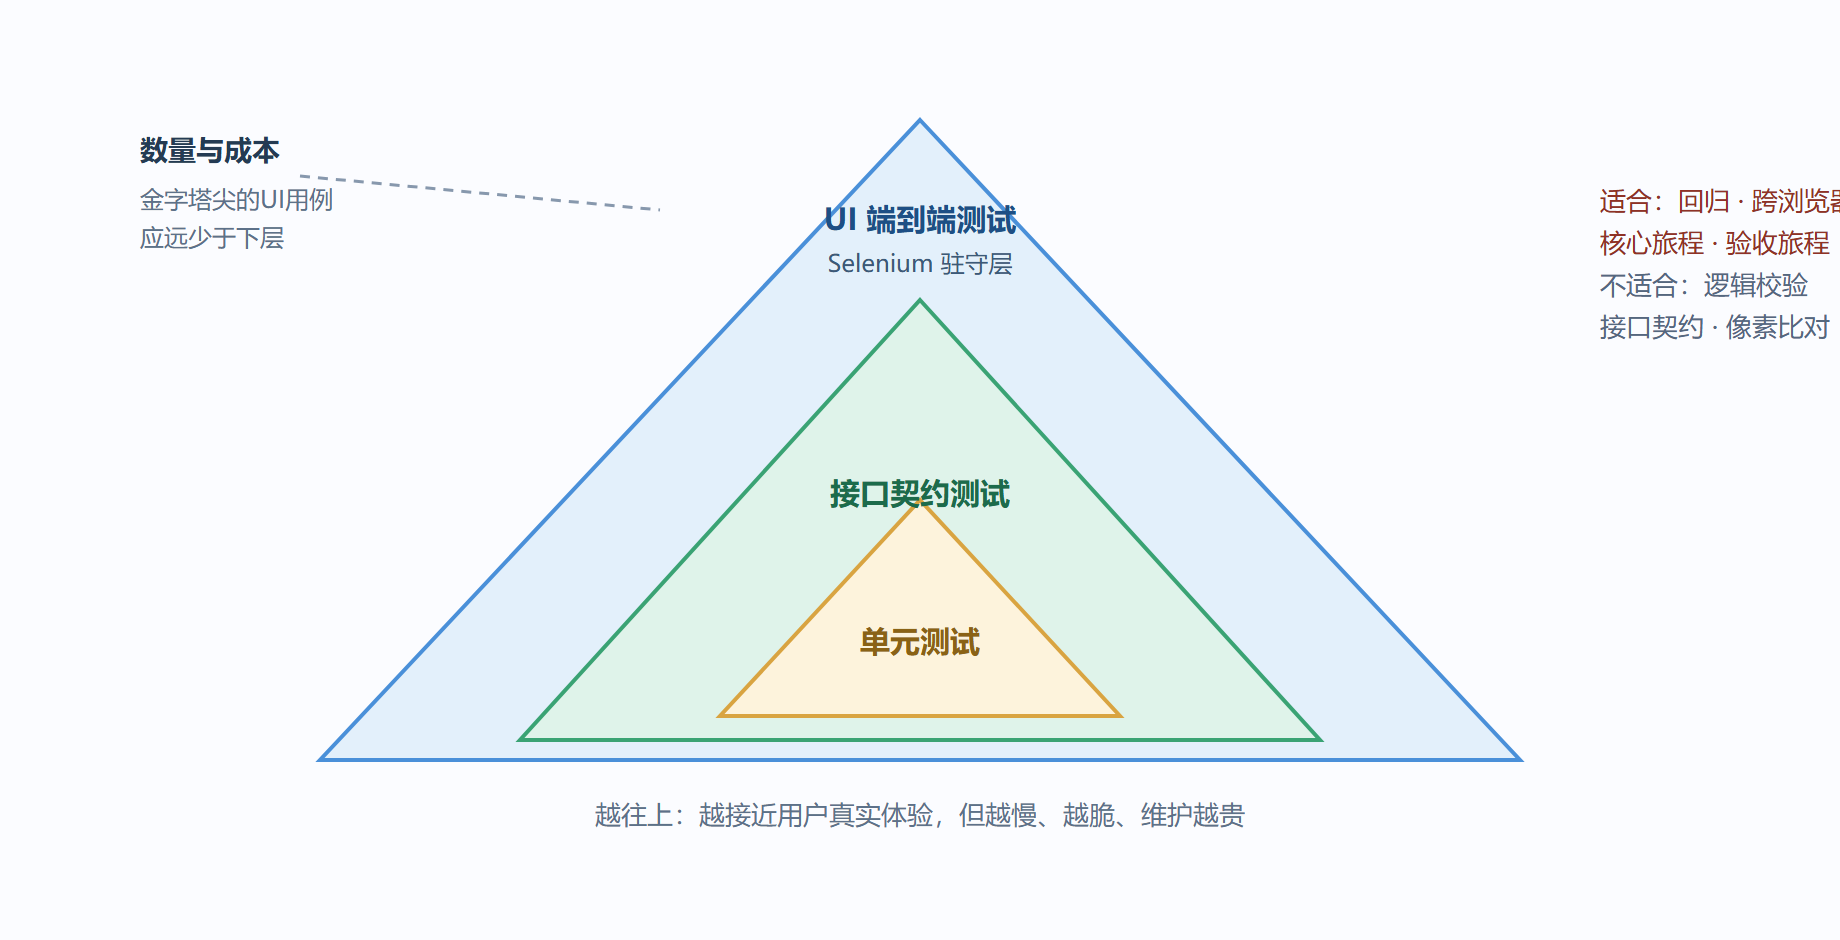
这是自动化领域最典型的错位:把"慢而全"的工具用在了"快而窄"的验证上。Selenium 每次执行都要走完整的浏览器链路——启动驱动、加载页面、渲染 DOM、执行交互。这个成本对端到端验证是值得的,因为你要的正是"真实浏览器里的最终行为";对逻辑校验则是纯粹的浪费,因为逻辑不需要浏览器作证。判断一个场景该不该上 Selenium,本质上是在判断:这个验证是否必须由"真实浏览器 + 真实页面"来作证。
它的甜蜜区:三个主力场景
场景一:回归测试。 这是最核心的用法。新功能迭代不断,老功能不能坏——人工回归的成本随功能数线性上涨,而脚本回归的边际成本接近于零。回归用例的特点是高频重复、路径固定、判定明确,恰好是自动化最擅长的形态。第 7 章会讲如何把回归套件打造成发布门禁。
场景二:跨浏览器验证。 同一个页面在 Chrome、Firefox、Safari、Edge 上的表现可能不同:布局错位、脚本兼容、字体渲染各有各的问题。Selenium 用同一套脚本跑不同浏览器的能力来自它的标准协议,这正是它对比许多新引擎的差异化优势——第 6 章的兼容矩阵会展开具体做法。
场景三:核心用户旅程守护。 注册、登录、下单、支付,这几条主路径是产品的生命线。围绕它们维护少量(通常几十条以内)高质量的端到端用例,在每次发版前执行,是投入产出比最高的自动化资产。注意关键词是"少量":旅程用例贵在精不在多,堆到几百条时维护成本会反过来吞噬信心。
图1-2 验证手段分层与Selenium的位置
它的禁区:三类注定失败的用法
禁区一:单元与模块逻辑。 判断一个促销规则、一个金额分摊算法是否正确,单元测试在毫秒内给出答案且定位精确到行。绕过逻辑层直接在页面上验证逻辑,等于用最贵的仪器做最便宜的测量——上一节反例里的四百条用例就是前车之鉴。
禁区二:纯接口契约。 服务之间的参数校验、状态码、报文结构,用接口测试工具直接打请求即可,快且稳。Selenium 只在"接口行为最终影响页面呈现"时才有出场价值,而且此时它验证的也是页面,不是接口。
禁区三:像素级视觉比对。 Selenium 能截图,但截图只是取证材料(第 7 章 7.2 会讲),不是视觉回归的比对引擎。亚像素级的渲染差异、字体抗锯齿、动画中间帧,都会让朴素的像素 diff 报出无穷误报。视觉回归应该交给专门的视觉比对工具,Selenium 负责把页面导航到位并截下图。
三问判断法:立项会上的防翻车工具
把上面的边界收拢成三个问题,按顺序问,任何一问答不上来就先别立项。
第一问:这个验证必须经过浏览器吗? 必须经过的场景——用户看得到的呈现、浏览器差异相关的行为、跨系统的端到端旅程。不必须的——纯逻辑、纯接口、配置校验,这些交给更快的工具。
第二问:这条路径一年会被回归多少次? 高频回归的路径值得投资;一次性活动页、快速试错的实验功能,脚本还没写稳页面就下线了,投入永远收不回。
第三问:页面里有没有能稳定定位的锚点? 前端愿意配合输出稳定的测试标识(比如语义化属性),自动化成本会低一个数量级;如果页面满是随机生成的类名且团队无权改动,先解决协作问题再谈自动化。这一问的答案直接决定第 3 章你会过得有多顺。
边界清单的工程价值
把三问判断法的结果沉淀成一页"自动化准入清单"放进团队 wiki,新用例进入回归套件前先过一遍。这页纸的作用不是限制自动化,而是保护自动化的信誉:套件里的每条用例都值得被自动化、都被高频执行、都能稳定定位,红屏才值得人认真对待。反过来,混进一堆"凑数用例"的套件,红屏会变成狼来了的故事——这是比任何技术故障都贵的失败。
边界判断的三个常见争议
争议一:接口都测过了,还有必要用 Selenium 测同一流程吗? 有必要,但测的不是同一样东西。接口验证的是服务契约(给定请求返回正确响应),端到端验证的是组装结果(页面拿这些响应渲染出可用的界面、用户走得通流程)。前端接错字段、状态没刷新、按钮没绑定事件——这些缺陷接口测试天然看不见。反之,逻辑错误也不该靠端到端兜底,两层各司其职才是完整防线。
争议二:老板要求"覆盖率百分之百",怎么回应? 用三问判断法把"覆盖率"翻译成"值得自动化的用例占比"。把一次性活动页、纯展示页纳入覆盖率数字很容易,但每条凑数用例都是长期负债。给管理层的正确表达是:我们的目标是核心旅程百分之百被守护,而不是所有页面被脚本路过一遍——前者防事故,后者只产出报表。
争议三:视觉回归真的不能直接用截图对比吗? 截图对比可以做,但要交给专门的视觉比对工具管理基线、容忍亚像素噪声、支持忽略区域;Selenium 在其中的角色是"把页面导航到位并截取素材"。自己写像素对比脚本,用不了几周就会被抗锯齿差异与动态内容的误报淹没。
一个反例工单的反面:划界成功的样子
反例看多了容易悲观,补一个划界成功的样子。另一个团队面对同样的立项诉求——"把核心流程自动化起来",做法是先花一周做盘点:核心旅程梳理出六条;三问过滤后,两条降级为接口验证(纯数据正确性),一条移交单元测试(优惠计算逻辑),最终进入 UI 自动化的只有三条旅程、二十来条用例。半年后的状态:用例总数没涨多少,但发布前红屏条条是真问题,团队对回归报告的信任度稳步上升。
对照开篇那个四百条用例的反例,两个项目的差别不在技术与投入,而在立项第一周有没有做边界判断。自动化项目的规模是设计出来的,不是攒出来的——这一节给你的三问判断法,就是那支设计用的笔。
收工清单
- 技术定位:UI 驱动的端到端行为模拟器,验证对象是"真实浏览器里的用户旅程",不是代码逻辑。
- 三大甜蜜区:回归测试、跨浏览器验证、核心用户旅程守护;三者的共同点是"必须由浏览器作证且高频重复"。
- 三大禁区:单元逻辑、纯接口契约、像素级视觉比对——各有更合适的专用工具。
- 三问判断法:必须过浏览器吗、一年回归几次、有稳定锚点吗;三问全过才立项。
- 本节与后续章节的接口:准入清单是第 4 章用例组织的前提,也是第 7 章"回归即门禁"的质量源头。
边界画好了,下一个问题是:如果团队确实需要 UI 自动化,选 Selenium 还是新引擎?下一节我们把四个主流引擎放到同一张桌子上比。