2.1 三层架构与W3C WebDriver协议
2.1 三层架构与W3C WebDriver协议
本节摘要:Selenium 的运行时由三层构成:你编写的客户端代码、承载指令的 WebDriver 协议层、由浏览器驱动与浏览器本体组成的浏览器端。协议层是 W3C 标准,规定了一组以 HTTP 接口形态呈现的指令端点与 JSON 报文格式,这让"任何语言、任何浏览器"成为可能。本节先立起这三层框架,第 2.2 节再让一次真实的点击沿着它走完全程——这两节合起来,是全册排错思维的地基。
为什么报错信息总是指向你没写过的代码
你有没有注意过,Selenium 的报错堆栈经常长得吓人:十几个调用栈帧里,只有一两个来自你写的用例,其余全是框架与协议层的内部转发。新手看到这种堆栈会本能地怀疑"是不是我的代码写错了",而老手会先做一件事——判断报错落在哪一层。层判断对了,排查方向就定了;层判断错了,越查越远。
这就是本节要建立的核心能力:把整个自动化运行时在脑子里分成三层,任何一个故障都能先归层再处理。"连不上驱动"是层与层之间的通信断了,"找不到元素"是浏览器端执行成功但页面不配合,两者的修法南辕北辙。层次感,是自动化排错与"瞎试"的分水岭。
三层各自负责什么
图2-1 Selenium运行时三层架构
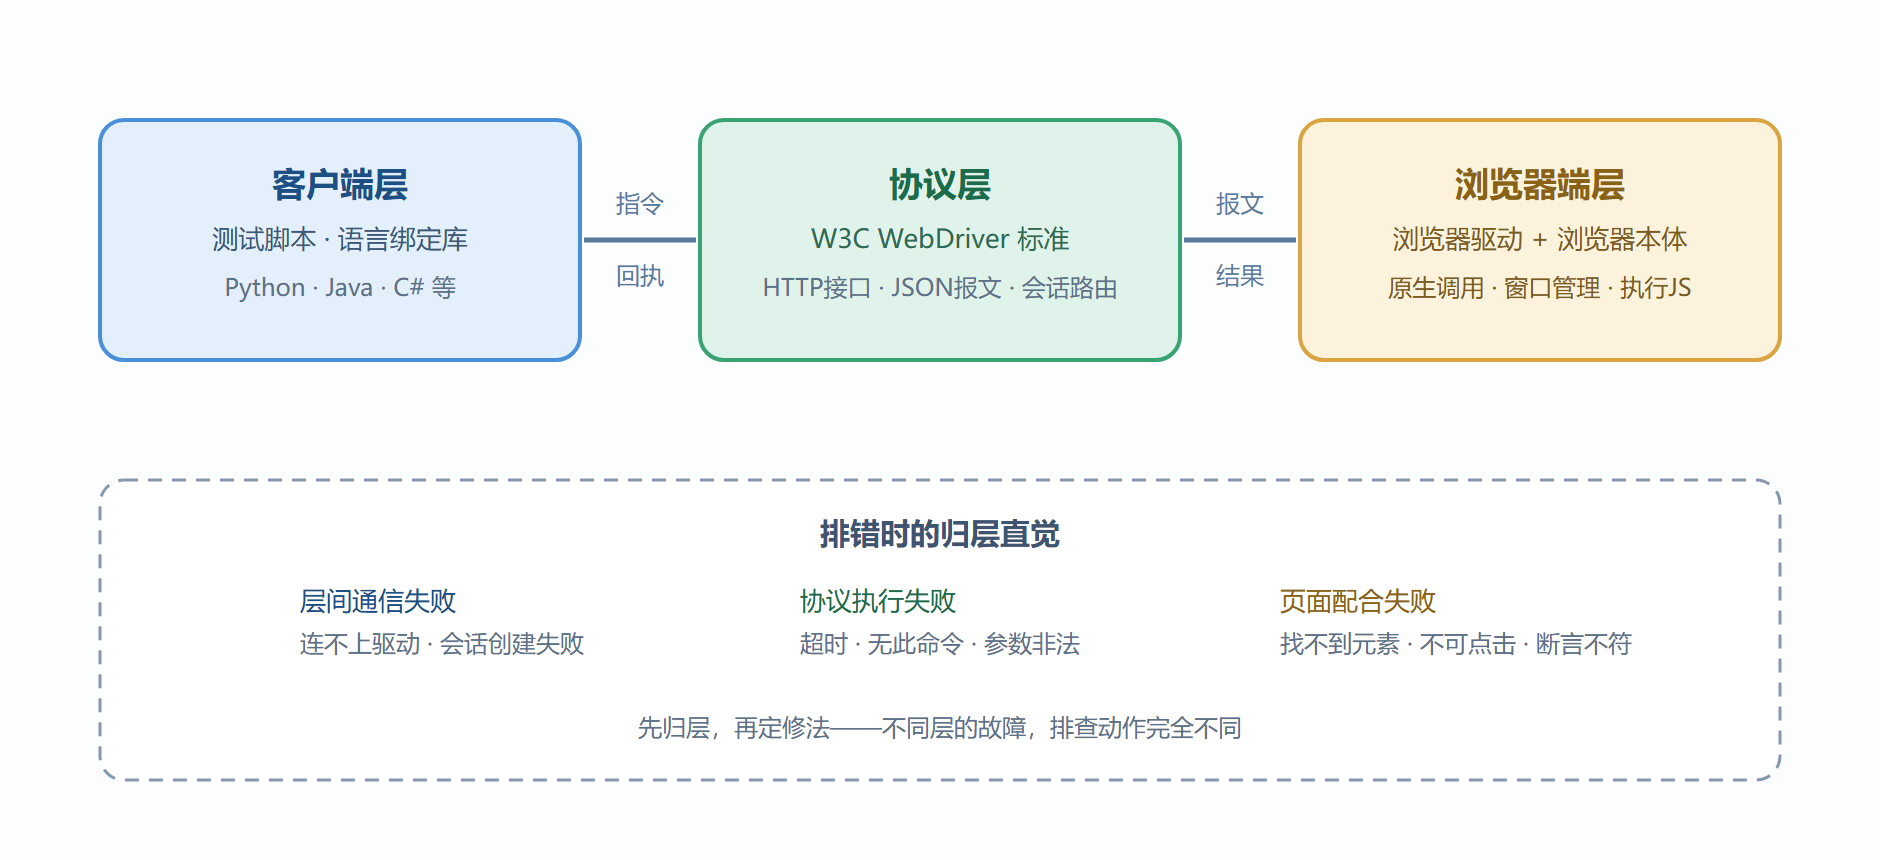
客户端层是你看得见的一层:用例代码加所用语言的 Selenium 绑定库。绑定库的职责是把 find_element(By.ID, "kw") 这样的调用翻译成协议报文——它只做翻译与本地管理(比如等待逻辑、元素引用缓存),不直接碰浏览器。你在本节语言绑定里看到的类与方法,最终都汇成对协议端点的调用。
协议层是整套体系的契约。W3C WebDriver 标准把"自动化能力"定义成一组资源端点:创建会话是一个端点,导航是另一个,元素点击又是一个。每个请求携带 JSON 报文,报文里是会话标识、参数与元素引用。这一层的存在解释了 Selenium 最独特的气质——语言无关与浏览器无关。绑定库只要会说这门"协议语言",就能指挥任何符合标准的浏览器;浏览器只要提供标准实现,就能被任何语言驱动。第 1 章说的"选型时拼标准",拼的就是这层。
浏览器端层由两个角色组成。浏览器驱动是独立进程,接收协议报文,把它们转换成该浏览器的原生自动化调用;浏览器本体则真正执行——加载页面、渲染 DOM、派发事件。驱动与浏览器之间走的是浏览器各自的控制通道,这段路不属于 W3C 标准,所以驱动版本必须与浏览器版本匹配:协议层人人一致,驱动与浏览器之间却是各家私事。第 1.1 节那张版本不匹配的工单,断点就在这层内部。
协议报文长什么样
抽象三层容易飘,看一段具体报文就落地了。下面的 Python 代码创建会话并设置浏览器选项:
from selenium import webdriver from selenium.webdriver.chrome.options import Options options = Options() options.add_argument("--headless=new") # 无头模式,不弹出窗口 options.add_argument("--window-size=1920,1080") options.page_load_strategy = "eager" # 页面加载策略:DOM就绪即继续 driver = webdriver.Chrome(options=options) # 这一行背后是协议的创建会话调用 print(driver.capabilities["browserVersion"])
webdriver.Chrome(options=options) 这一行的幕后是一次向本地驱动进程发起的创建会话请求:客户端把刚才设置的选项序列化成 JSON,驱动校验后拉起浏览器进程,回执里带着本次会话的标识与能力清单。capabilities 就是回执的一部分——驱动告诉你"我给你启动的到底是什么版本"。排查环境问题时,第一动作往往就是打印它,确认实际生效的浏览器与设置和你以为的一致。
页面加载策略值得一笔:默认策略等页面完全加载(包括图片、样式)才算导航完成,eager 策略在 DOM 就绪即返回。网速一般的流水线里,把加载策略调快是零成本提速的第一招,代价是图片类资源不保证就绪——这个取舍在第 3 章的等待设计里会再次遇到。
会话是协议层的一等公民
三层架构里最容易被低估的概念是会话。它不是"一次脚本运行"的文学说法,而是协议层的实体:创建会话时驱动分配唯一标识,之后每个请求都带着这个标识路由;元素引用也是会话内的资源,换个会话就作废。理解这一点,两类常见现象就有了解释——为什么脚本结束时必须显式退出会话(否则浏览器进程与驱动进程残留,流水线节点越跑越慢);为什么不能把一个 driver 对象跨进程共享(会话标识到了别人手里也没有对应的浏览器上下文)。
本节开头说"报错堆栈吓人",现在你有了归层的武器:堆栈底部是连接类异常,先查层间通信——驱动进程在不在、端口通不通、版本配不配;堆栈里出现超时与命令错误,看协议参数与全局超时设置;报错文案是元素、点击、断言相关,恭喜,问题大概率在你的用例或页面上,这层最值得深挖,也是下一章的主角。
层次认知的两个延伸问题
问:知道了三层,对日常写用例有什么直接帮助? 最直接的回报在报错阅读。看到"invalid session id"你知道会话被销毁了(协议层状态问题),看到"element not interactable"你知道指令已到达浏览器、是页面不配合(浏览器端层),看到"connection refused"你知道指令根本没出门(层间通信)。三种报错三种修法,层次就是索引。
问:协议层既然是 HTTP,能不能绕过绑定库直接发请求? 技术上可以——协议端点就是普通 HTTP 接口,有些团队用它做轻量操作(比如直接调用截图端点)。但绕过绑定库意味着放弃等待体系、元素引用管理这些上层封装,日常用例不建议;理解"可以绕"的价值在于彻底消除对绑定库的神秘感,它只是协议的翻译层。
另一个值得养成的习惯:升级绑定库或浏览器后,主动打印一次能力清单对齐认知。环境类工单的最短路径,往往就是"先确认实际生效的是什么"。
一个动手观察练习
三层架构可以直接观察。启动一个会话后,在任务管理器(或进程列表)里找到对应的驱动进程——你会看到它独立于你的脚本进程与浏览器进程存在,这正是 2.2"三次进程边界"的实物证据。再进阶一步:用命令行查看本机监听端口,能找到驱动服务占用的本地端口号——你的脚本正是通过它发送协议报文的。花五分钟把这两个进程与一个端口亲眼确认一遍,"三层"就从示意图变成了你机器上真实运行的东西。
收工清单
- 三层记忆法:客户端管翻译、协议管契约、浏览器端管执行;故障先归层再排查。
- 标准的价值:W3C 协议统一了语言与浏览器两侧的接口,是 Selenium 生态位的根基。
- 版本匹配的原理:协议层标准化了,驱动与浏览器之间的私有通道没有标准化,所以驱动必须跟版本。
- 会话是实体:带唯一标识、承载元素引用、必须显式销毁;资源泄漏类工单先查会话。
- 加载策略:默认完整加载,eager 模式 DOM 就绪即返回;提速与就绪保证的第一次取舍。
三层框架立起来了。下一节让一次真实的点击从上到下走一遍,你会看到每一层在时间轴上的先后与耗时。