2.2 从一次点击看组件全链路
2.2 从一次点击看组件全链路
本节摘要:一行
element.click()背后至少跨越三次进程边界:从测试代码到语言绑定,从绑定到浏览器驱动的协议请求,再从驱动到浏览器内部的原生事件。把这条链路逐帧拆开,你会获得两样东西:一张"耗时都花在哪"的地图,和一套"点击没反应该查哪"的排错分层。本节是 2.1 三层架构的动态版,也是第 3 章交互操作与第 7 章失败取证的方法论预演。
三次进程边界:一行代码的完整旅程
先给一个量级事实:在你感觉"瞬间完成"的一次点击里,指令至少要跨越三次进程边界——测试代码所在的语言进程、独立运行的驱动进程、浏览器进程。每次跨界都有序列化、传输、校验的开销;如果算上驱动拉起浏览器、页面加载渲染,一次端到端操作的真实耗时常常在秒级。这就是 UI 自动化"天然慢"的物理原因,也是第 6 章并行化、第 8 章优化的出发点:慢不是罪,不明不白地慢才是。
更重要的推论是:三个进程任何一处出问题,现象都可能是"点击没反应"。没有全链路视角的人只能反复重跑碰运气;有视角的人会先问——指令到驱动了吗?驱动到浏览器了吗?事件派发了吗?页面状态变了吗?四问逐级收窄,一分钟内就能把故障锁进一层。
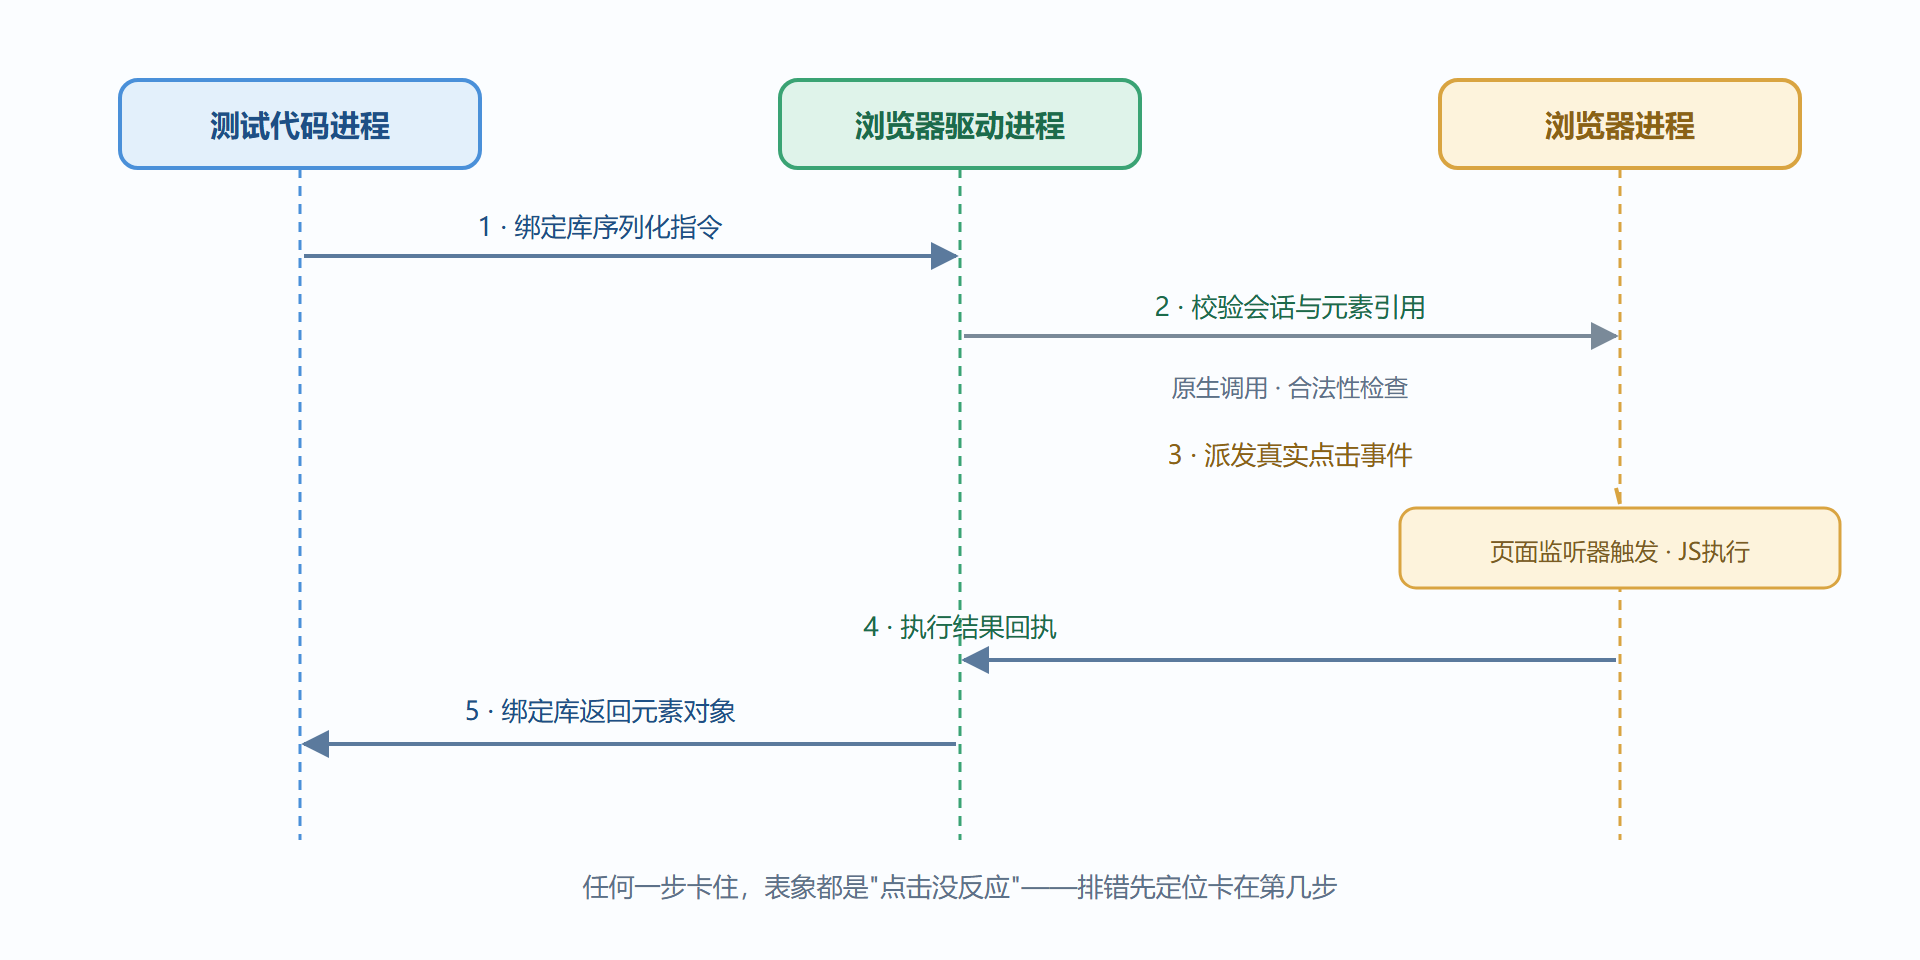
图2-2 一次点击的全链路时序
逐帧解读:每一步会发生什么、能坏什么
第一帧,序列化。 绑定库把元素引用与方法名打包成协议报文。这一步几乎不出错,但你值得知道一个细节:find_element 返回的元素对象在客户端只是"一个引用号",不是页面上的真实节点。引用号在协议层的会话里登记,浏览器端才持有真身。这个设计解释了一个经典怪象——页面刷新后旧元素引用全部失效报"元素已过期":引用号还在你手里,真身已经随旧 DOM 销毁了。
第二帧,驱动校验。 驱动收到报文,先查会话标识是否存在、元素引用是否有效、参数是否合法。会话被误关、元素引用过期、参数类型错,都卡在这帧。这一帧的错误信息通常明确——报什么缺什么,是三层里最"诚实"的一层。
第三帧,原生执行。 驱动调用浏览器内部的自动化通道,把点击落到正确的坐标与节点上,浏览器按真实用户操作的标准派发事件:悬停、按下、抬起。注意"真实"二字的分量——如果目标按钮被一个悬浮层遮挡,原生执行会判定不可交互而报错,而不是隔着遮挡层硬点。第 5 章处理遮挡与覆盖问题时,依据的就是这条规则。
第四、五帧,回执。 浏览器把执行结果沿原路返回,绑定库把回执翻译回语言对象。若页面在等待事件处理的回调里出了错,回执本身是成功的——页面 JS 的报错默认不会传回测试代码。这就是为什么"点击成功了但页面没变化"要用断言兜底,而不是指望点击报错。
打开驱动的黑匣子:把链路日志落在纸上
全链路认知要变成排错武器,还得能看见链路本身。给驱动服务打开详细日志,等于给黑匣子接上记录仪:
from selenium import webdriver from selenium.webdriver.chrome.service import Service service = Service(service_args=["--verbose", "--log-path=driver_trace.log"]) driver = webdriver.Chrome(service=service) driver.get("https://shop.example.com") driver.find_element("id", "search-box").click() driver.quit()
跑完后打开日志文件,你会看到刚才那次点击的真实足迹:驱动收到请求的时间戳、校验过程、转发给浏览器的通道指令、执行耗时与回执。排错时把日志时间戳与报错对照,"卡在第几帧"一目了然。日常不必开着它——日志量大,流水线里还会拖慢执行;只在复现疑难故障时打开,用完即关。
耗时地图与提速的直觉
把链路地图转成耗时视角:绝大多数时间花在第三帧前后——页面加载、渲染、脚本执行;协议传输本身在毫秒级。由此得出两条提速直觉:第一,能少导航就少导航,导航一次的代价比页内操作大一个量级;第二,慢的根因常在页面而不是框架,用浏览器开发者工具看一次加载瀑布,比反复调等待参数有用得多。这两条直觉在第 8 章 8.3 讲执行性能时会展开成完整的优化清单。
五帧排错的三个短案
短案一:点击"成功"但页面没跳转。 用第几帧的视角看:回执正常说明前三帧全通,问题出在第四帧之后——页面的事件处理器里出了异常,或者点击触发的条件没满足(表单校验未过)。用浏览器控制台看有没有页面脚本报错,一分钟定位;若没有报错,检查是不是触发了校验拦截。这案子教会你:回执成功只证明"点击送达",不证明"业务生效"。
短案二:同一操作时快时慢,偶尔超时。 逐帧计时(驱动日志的时间戳)发现慢在第三帧前后且波动大——那是页面加载渲染的领地。再查页面加载瀑布,发现某个第三方统计脚本偶尔拖慢整体。处置:页面加载策略换 eager,加统计脚本的域名到阻断清单。这案子教会你:时快时慢先怀疑页面依赖,别急着调等待参数。
短案三:流水线上"浏览器意外退出"。 第一帧就失败——连接建立不起来。查驱动日志发现浏览器进程启动即崩,根因是容器里共享内存不足。这案子是 2.3 与 6.3 容器配置的伏笔:跨进程链路里,任何一个进程的死亡都会以"另一端报错"的形式出现,归层思维帮你快速锁定该看谁的日志。
三个短案共用同一套推理:先定帧,再定层,最后定责。把这套推理练成条件反射,是本节真正的产出。
全链路视角的三个推论
把时序地图内化后,有三个推论值得单独记录。推论一:用例的数量级决定会话成本。 每条用例独立会话(隔离最好)意味着浏览器启动成本乘以用例数;理解了链路,你才能在第 8 章的优化里算清"会话复用省多少、风险加多少"的账——不明机制就没法做这种取舍。推论二:等待的设置位置应当与链路对齐。 元素级的等待解决元素晚到,导航级的等待解决页面晚到,把两层混用(拿元素等待去等页面跳转)是常见的设计错位。推论三:日志要按链路分层采集。 脚本日志、驱动日志、浏览器控制台日志各记录链路的一段,排错时按可疑帧取对应日志,比一把抓高效得多。
这三个推论会在后续章节反复出现:推论一通向第 6 章的并行与第 8 章的优化,推论二通向 3.3 的等待体系,推论三通向 7.2 的取证设计。本节的时序地图,是它们共同的底图。
收工清单
- 三次跨界:测试进程、驱动进程、浏览器进程;每次跨界都是潜在故障点。
- 元素引用的真相:客户端持有引用号,浏览器端持有真身;页面刷新即引用过期。
- 五帧排错法:序列化、校验、原生执行、回执、翻译——"没反应"先问卡在第几帧。
- 黑匣子技巧:驱动详细日志是疑难故障的复查手段,日常关闭。
- 耗时直觉:时间在页面不在协议;少导航、查瀑布,比调参数更治本。
链路通了、地图有了,就差一台真正能跑的机器。下一节把环境搭建一次做对,并用第一条脚本验证这条链路在你手里完整可用。