6.1 跨浏览器兼容性策略
6.1 跨浏览器兼容性策略
本节摘要:跨浏览器验证的工程问题不是"怎么在别的浏览器上跑脚本",而是"哪些浏览器组合值得测、各测多深、怎么组织"——也就是兼容矩阵。本节给出矩阵的三层设计(主力、次级、抽检)、用参数化让同一套代码按矩阵执行的做法,以及浏览器内核差异的排错入门。规模化三问中的第一问"测什么",本节一次说清。
全量矩阵是个预算黑洞
先泼冷水:主流桌面加移动端组合几十种,全量矩阵意味着执行时长与维护成本翻几十倍,而大多数组合验证的是同一个内核的近似副本——投入产出严重失衡。兼容性策略的第一课是承认预算有限,把"测什么"变成一道配平题:用户实际分布决定矩阵密度,故障历史决定抽查方向,预算决定每层跑多全。
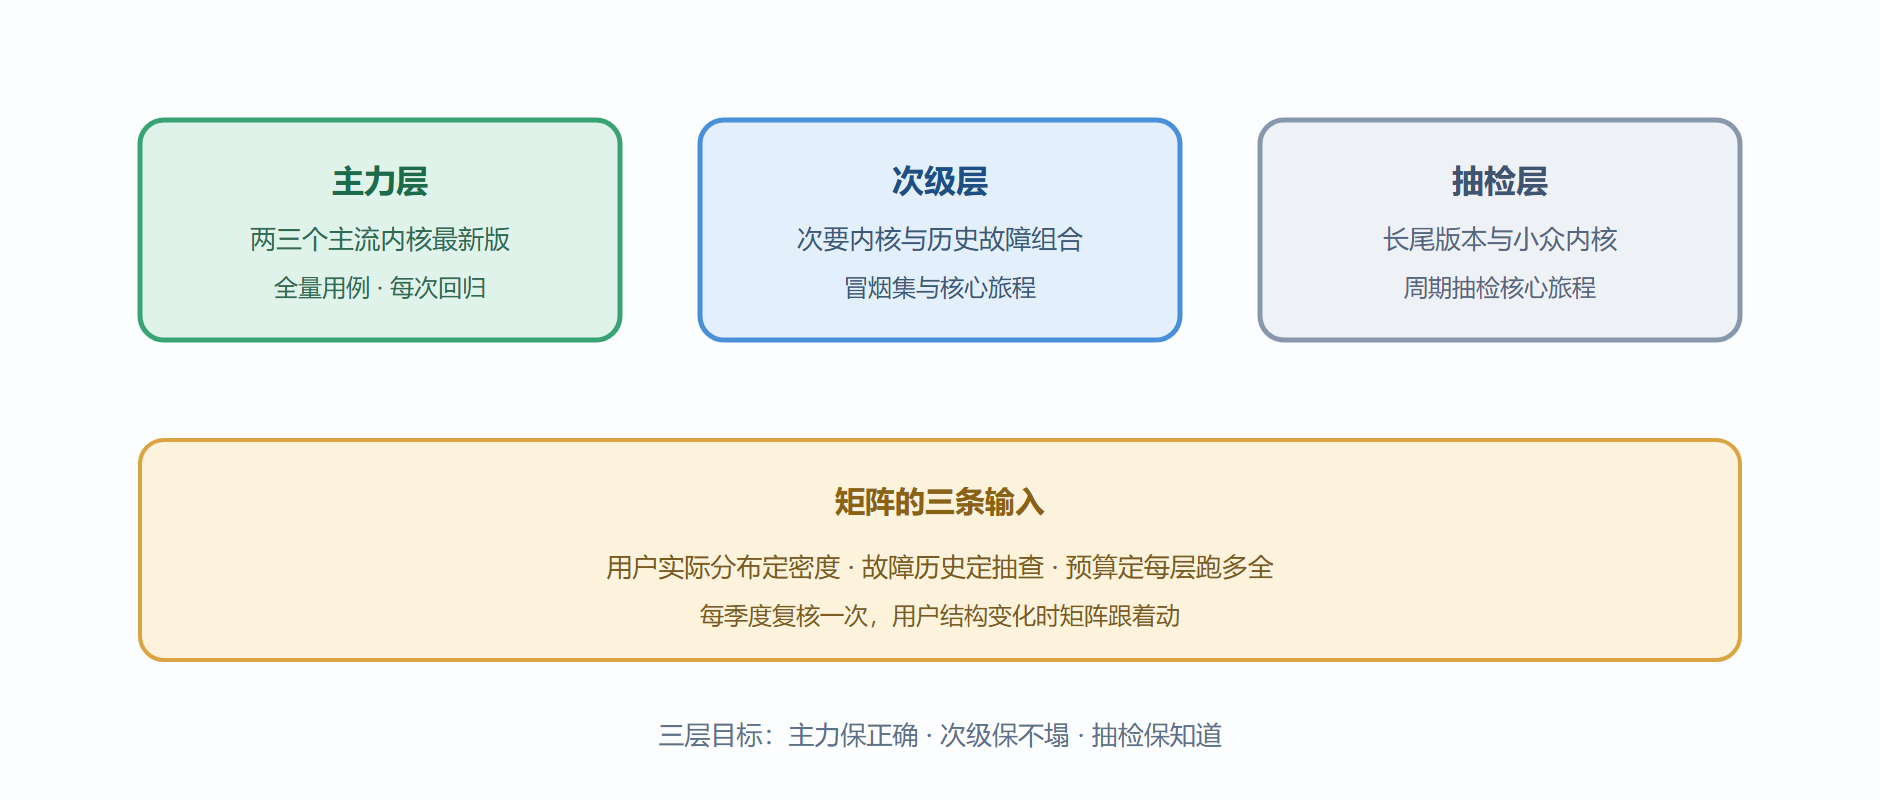
矩阵分三层设计。主力层:用户占比最高的两三个浏览器加最新版本,全量用例每次回归必跑——这是兼容性的基本盘。次级层:占比次之或历史上出过兼容问题的组合,跑冒烟集与核心旅程——它们的任务是"别让明显的塌方漏网"。抽检层:长尾组合(旧版本、小众内核)按周期抽检核心旅程即可,不进日常回归。三层各自的目标不同:主力层保正确,次级层保不塌,抽检层保知道。给管理层报兼容性风险时,这三层就是你的语言。
图6-1 兼容矩阵三层密度
矩阵参数化:一套代码,多种浏览器
矩阵定了,工程问题随之而来:难道为每个浏览器维护一套用例?绝不。Selenium 的标准协议(2.1 的老朋友)保证了"同一套代码驱动不同浏览器",工程上的做法是把浏览器变成运行参数:
BROWSERS = { "chrome": webdriver.ChromeOptions, "firefox": webdriver.FirefoxOptions, "edge": webdriver.EdgeOptions, } @pytest.fixture(params=list(BROWSERS), ids=list(BROWSERS)) def driver(request): options = BROWSERS[request.param]() # 按参数取对应配置 options.add_argument("--headless=new") driver = webdriver.Remote( command_executor=GRID_URL, options=options) # 同一段代码随参数切换 yield driver driver.quit()
这个夹具让套件自动翻倍成矩阵:参数化展开后,每条用例在列出的每个浏览器各跑一遍,报告里按浏览器分列。配合标记体系还能做差异裁剪——某条用例只在主力层跑、某条在特定浏览器上标记跳过并注明原因,执行策略全部写在用例元数据里,流水线按层调用即可。
内核差异排错入门:差异从哪来
跨浏览器故障集中在三个来源。渲染与布局:字体度量、盒模型细节、默认样式在内核间有微妙差异——症状是"错位、截断、换行不同",修法在前端(显式声明样式),自动化负责用矩阵把它暴露出来。脚本能力:新语法与新接口的落地时间不同——症状是"某个浏览器整页报脚本错误",用例现象是全体用例集体失败,这类要交给前端的构建与降级策略。行为时序:事件派发与渲染调度的细节差异——症状是"同一个等待条件在不同浏览器上表现不同",这是自动化自己要吸收的:等待条件在矩阵全层验证过,才算真的稳。
排错纪律是"先定位差异层,再定责":布局差异拉上前端,脚本差异推进构建,时序差异回到 3.3 加固条件。跨浏览器用例红屏最忌讳的处理方式是"在出问题的浏览器上单独调参糊弄过去"——那会让等待体系裂成每个浏览器一套参数,维护成本失控。
一场矩阵评审会:把策略变成共识
矩阵不能由测试团队闭门定,一场有各方的评审会能让策略从"文档"变成"共识"。还原一场真实的评审:质量团队带来草案——主力层定为两个内核的最新版,依据是后台的用户占比(两者合计超过九成)。前端立刻补充:主力层该加第三个内核,因为下季度的新特性依赖它的能力,灰度期需要覆盖。运维提出抽检层的旧版本组合已从办公网消失,建议裁撤。产品最后拍板:核心旅程的定义收窄到四条主路径,其余降为次级层。
四十分钟后,矩阵从草案变成了带理由、带负责人、带复核日期的承诺:每个组合为什么在矩阵里、出问题找谁、什么时候重新评估。这场会的产出质量远高于任何单方文档,因为它把三个信息源(用户数据、前端路线图、环境现实)拼在了一张桌上。矩阵是活的文档,让各方参与制定,它才会真的"活"着。
评审会还有一个副产品值得记录:争议最大的往往不是"测什么",而是"内核差异缺陷算谁的"。会上提前约定归责路径(6.1 的差异三来源归责表在此登场),日后跨浏览器红屏就不会演变成团队间的拉扯。
兼容性数据的两个来源
矩阵的输入之一是"用户实际分布",数据从哪来值得交代清楚。第一个来源是站点自己的分析统计:各浏览器与版本的访问占比、核心转化路径上的分布——这是最贴近真实用户的证据,优先级最高。第二个来源是缺陷历史:过去一年兼容类缺陷集中在哪些内核与版本,历史病灶预示未来风险,是抽检层选组合的主要依据。两个来源冲突时(统计说占比极低、历史说病灶集中),听历史的——占比会流动,病灶会复发。
数据的更新节奏同样重要:占比数据每季度刷新一次,与矩阵复核同频;大版本发布或市场突变(某浏览器强制升级)时临时加刷。矩阵管理的本质是数据管理——没有数据的矩阵,只是团队的猜测清单。
一个矩阵冷启动的速成路径
从零建矩阵的团队常被"没有历史数据"卡住,给一条速成路径:第一版矩阵只设主力层,凭站点统计的浏览器占比取前二三名,全量用例先跑起来;同时给回归报告加一个"浏览器字段",让每条失败自动带浏览器标签。三个月后,标签数据会告诉你真实病灶在哪个内核——第二版矩阵的次级层与抽检层就按病灶划。这套路径的哲学是"先跑起来让数据说话",矩阵在冷启动阶段允许粗糙,但必须滚动进化。
收工清单
- 矩阵三层:主力全量、次级冒烟、长尾抽检;密度由用户分布、故障历史与预算共同决定。
- 浏览器即参数:参数化夹具让一套代码按矩阵展开,裁剪策略写进用例标记。
- 差异三来源:布局差异归前端、脚本差异归构建、时序差异归等待体系加固。
- 禁止按浏览器调参:等待条件全层验证,不许裂成每浏览器一套参数。
- 季度复核:用户结构变了,矩阵就得跟着变——矩阵是活的文档。
矩阵定了"测什么",下一个问题是怎么快起来。几百条用例乘上矩阵倍数,串行执行已经不可想象——下一节把并行执行的安全与效率一次讲透。