6.2 并行执行与SeleniumGrid
6.2 并行执行与SeleniumGrid
本节摘要:并行执行的安全前提是"用例之间零共享"——共享账号、共享目录、共享全局配置,任何一处都会在并行世界炸成灵异故障;在此前提上,用运行器的并行进程加 Selenium Grid 的分布式会话,套件执行时间随并行度近线性下降。本节先给共享状态清查清单,再讲并行的两层架设,最后给出并行度的调优方法。它是规模化三问中"怎么快"的完整答案。
并行的第一课:先找出被共享的东西
工单 #049:套件并行化后,登录用例开始随机失败,报错是"账号已在别处登录"。单跑全过、并行全飘——教科书级的共享状态症状。排查发现套件所有用例共用一个测试账号,串行时后登录者自然顶掉前者没人察觉,并行时变成明目张胆的互踢。
这类故障的原理一句话说透:串行世界里,"先后顺序"掩盖了用例之间的耦合;并行世界里,耦合现形为随机故障。所以并行化的第一步不是配并行参数,而是清查共享。给你一份四类共享清单,逐项过堂:
| 共享类别 | 典型症状 | 消除方案 |
|---|---|---|
| 账号与会话 | 互踢下线、购物车串单 | 账号池独占分配,用例领取后释放 |
| 文件系统 | 下载文件互相覆盖、截图错乱 | 每进程独立目录,按进程号命名 |
| 全局配置 | 改环境的配置影响同批用例 | 配置只读注入,禁止用例改全局 |
| 外部数据 | 两人同时改一条订单互相干扰 | 数据构造器造专属数据,用完清理 |
清查的验收标准很硬:把并行度从一调到八,用例结果必须与串行完全一致。做不到就还有共享没清出来——随机失败用例的排查套路是看它失败了什么动作,动作背后动了什么资源,资源是否被别人也在动。这个推理链通常十分钟内见底。
运行器层并行:单机多进程
共享清干净后,第一层并行由测试运行器承担。pytest 生态的并行插件用多进程跑用例,每进程独立加载夹具——天然形成进程隔离:
pytest -n 4 --dist loadgroup # 4个进程并行,按组分配
两个参数值得记住。-n 控制并行进程数,单机建议从中央处理器核数的一半起步试;--dist loadgroup 支持把必须同进程的用例打成组(比如共享一个浏览器会话的连续操作),其余用例自由分发。进程级并行的边界也明确:它并行的是"用例",浏览器还是各进程自己起——单机资源很快见顶,中央处理器与内存被多个浏览器实例瓜分,吞吐量上不去了,就该第二层出场。
Grid:把会话分发到机器群
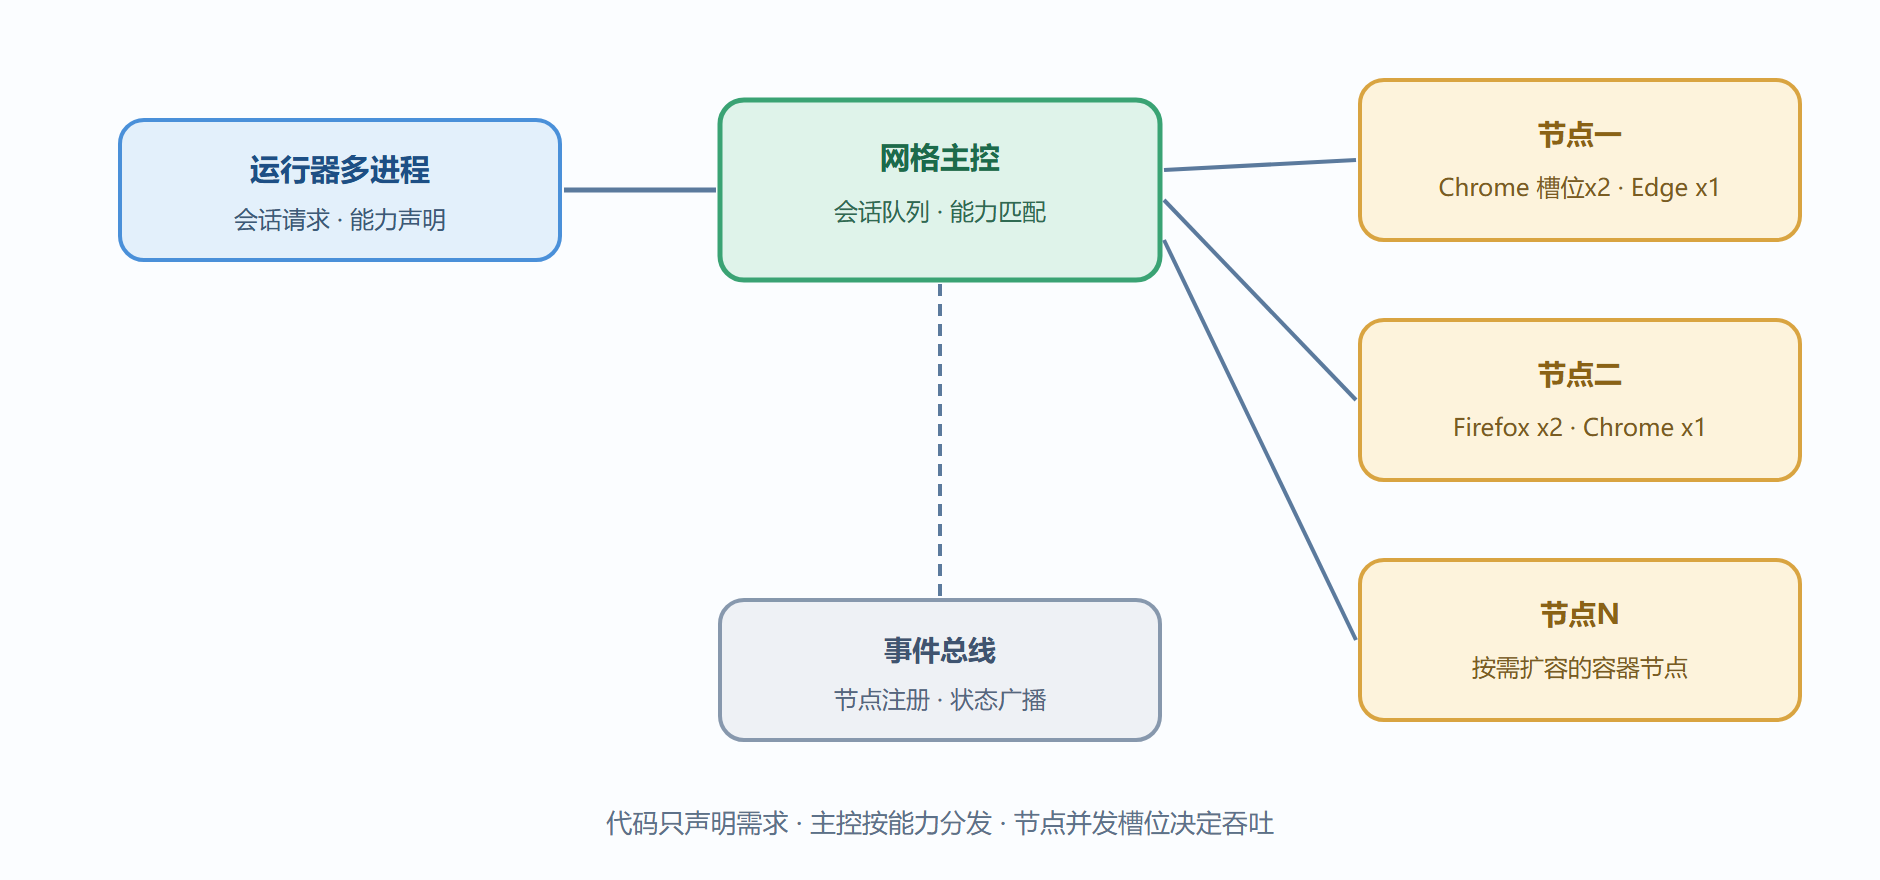
Selenium Grid 的角色是把"会话请求"分发到一排"有能力提供浏览器的节点"上。脚本侧的唯一变化是把本地驱动换成远程端点加能力声明——想要什么浏览器,声明清楚,网格负责找匹配的节点:
from selenium import webdriver options = webdriver.ChromeOptions() options.browser_version = "latest" options.platform_name = "linux" driver = webdriver.Remote( command_executor="http://grid.internal:4444", options=options) # 代码只声明需求,分发交给网格
对用例代码而言,本地与网格执行只差这一处工厂函数——这也意味着 6.1 的矩阵参数化夹具可以无缝从本地切到网格。现代版网格内部由事件总线、会话队列与分发器几个组件协作:请求进队列,分发器按能力匹配空闲节点,会话结束节点回收复用。你不需要深究内部协议,但值得记住两个运维参数:节点并发槽位(一台节点最多同时服务几个会话)与最大会话时长(防泄漏会话占着槽位不放)。
图6-2 网格分发拓扑
并行度调优:从哪里加、加到哪里停
并行度不是越大越好,调优口诀是"观察瓶颈再加码"。起步配置:单机进程数取核数一半,网格槽位按节点内存预算(每个浏览器实例预留一至两吉字节)。加码的信号与停下的信号都很明确——用例等待时间变长、超时类失败率上升,说明节点资源已饱和,此时加并行只会制造假失败;执行时间随并行度近线性下降、资源占用留有三成余量,就是当前的甜点位。另一个常被忽略的维度是按层并行:冒烟集高并行快跑,全量集低并行稳跑,两层并行度分开定——一刀切的并行度必然一层吃亏。
一次并行化改造的完整时间线
把本章的方法落进一个真实工程,时间线长这样。第一周:清查。 静态扫描加人工排查,产出共享状态清单——两处共享账号、一处共享下载目录、三处用例顺序依赖。第二周:隔离。 账号池上线(独占分配用后释放),下载目录按进程号隔离,三处顺序依赖重写为独立场景。本周结束的验收标准:并行度八与串行结果完全一致。第三周:并行。 运行器进程数从二起步逐级上调,每级观察超时率与执行时长;随后网格接入,矩阵参数化夹具指向远程端点。第四周:调优。 按节点内存定槽位,冒烟集与全量集分别定并行度,最终全量回归从两小时十四分压到十七分钟,假失败率与串行时代持平。
这条时间线的价值不在数字,在顺序:清查在前、并行在后,每一步有验收标准。跳过前两周直接开并行的团队,通常在第四周仍在处理"随机的灵异红屏"——不是他们技术不行,是顺序反了。
零共享改造的两个典型 refactor
共享清单里最难改的两类,给出现成的改法。顺序依赖的拆解:用例乙依赖用例甲"创建的商品",改法是把"创建商品"从甲用例里提出来,做成独立的数据准备函数——甲与乙各自在夹具里调用它,从此互不依赖。判断改造完成的标准:任意单条用例可以单独执行且通过,套件获得"随机顺序执行"的能力,这正是并行插件默认行为的前提。全局配置的收敛:某条用例为了测试特殊场景修改了全局超时配置,同批用例遭殃。改法是把"特殊场景需要特殊参数"显式化为该用例的局部配置注入——参数随用例走,不落全局。改完之后,工程里应当只剩只读的全局配置,任何运行时修改都视作设计缺陷。
这两类改造的共同哲学是:并行化暴露的不是并行的问题,而是工程原本就存在的耦合。从这个意义上说,并行化改造是一次强制性的工程体检——体检通过了,套件的可维护性也顺带上了一个台阶。
收工清单
- 并行的前提是零共享:账号、目录、配置、数据四类共享逐项过堂,串行掩盖的耦合在并行现形。
- 两层架设:运行器管进程级并行,Grid 管机器级分发;代码侧只换工厂函数。
- 声明式会话:能力声明表达"要什么浏览器",分发细节不进用例代码。
- 调优看信号:超时失败率上升即资源饱和,甜点位是近线性加速加资源余量。
- 按层分并行度:冒烟快跑、全量稳跑,两层参数分开。
并行使执行快了十倍,但也把"环境一致性"的重要性放大了十倍——八台节点的浏览器版本稍有参差,红屏就会被误读成代码缺陷。下一节用容器与云平台把执行环境标准化。