2.2 分子系统学重建的现代框架
2.2 分子系统学重建的现代框架
本节摘要:分子系统学可以被视为一门现代形态的生命考古学——墨水是碱基,量尺是演化,镜子是计算。本节先拆掉一个流行误解:"分子钟是匀速滴答的机械钟";它的真身,是变异沉积速率留下的地质断层。随后沿分辨力梯度盘点各分子标记的分工,最后沿 APG 系统四个版本的演进轨迹,看重建框架如何一步步由形态祛魅走向基因组共识与溯祖整合。
学习目标
读完本节,请自查能否做到:
- 说明似然思想在系统树推断中扮演的角色;
- 面对不同分类尺度的课题,挑得出合适的分子标记;
- 分别举出 APG 一至四版各自的标志性突破;
- 讲清现代框架的四大支柱,特别是溯祖模型如何消化基因树之间的冲突。
一、问题与直觉:分子钟不是钟
刚入门的人往往以为这门学科建立在某种普适分子钟之上——仿佛所有基因都以同一节拍突变。事实并非如此。推动系统发育重建的引擎,从来不是绝对时间,而是变异的相对积累。其数学内核一句话即可概括:给定一棵候选树和一套进化模型,去找最能生成眼前这套观测序列的树形与分支长度组合。这个目标函数求解的不是"哪棵树更古老",而是"哪棵树最能解释手里的数据"。
因此,所谓重建框架,实质是在高维参数空间的似然面上做一次稳健的爬山。它需要三个部件严密咬合:谨慎挑选承载信息的"地质层"——分子标记;设计贴合生物实际的"沉积模型"——核苷酸替换模型;再部署足以解析海量信号的"勘探算法"——系统发育推断引擎。三者一处掉链子都不行:标记挑错,算法再好也只是对着噪声拟合;模型选错,长枝吸引之类的系统误差就会把树形拧成一团假象。
二、标记选择:在保守与多变之间走钢丝
一枚理想的分子标记,得同时扛住三股张力:对近缘类群分辨得开,对远缘类群比对得拢,并且在目标类群里呈现出可预期的进化速率梯度。
叶绿体基因组母系遗传、罕有重组、拷贝数高,这套半自主细胞器基因组天然适合充当陆生植物系统学的主干标尺。其中编码光合大亚基的基因极其保守,重建科级以上关系时稳如磐石——可也正因为它太稳,到了属种层次往往掉进分辨率荒漠:同属几十个物种的序列几乎看不出差别,好比拿米尺去量一层薄膜。这时候成熟酶基因开始发挥威力:进化速率约为前者的三至五倍,简约信息位点密集,是理清蔷薇类、菊类内部关系的关键武器。非编码区间则继续向种下层次延伸,其重复序列与插入缺失拼出独一无二的条形码指纹,在兰科、禾本科这类快速辐射类群的杂交溯源里无可取代。
不过叶绿体只会讲母系的故事。一旦演化历程里充满杂交、渐渗乃至胞质捕获,只听它一家之言便如盲人摸象——核基因组的双亲印记这时成了必需品。核糖体内转录间隔区拷贝数高、进化快、种间分化明显,长期坐稳被子植物通用条形码的位子。一项覆盖四百余科的研究证实,它在属级鉴别上的成功率显著超过单一叶绿体标记;但它也有阴影——种内多态性与假基因化的风险:一个个体身上可能挂着几百个彼此略异的拷贝,某些蕨类和裸子植物中它甚至已严重退化。
光谱的另一端站着极度保守的核糖体小亚基基因——它分不出玫瑰与月季,却能在"被子植物是否单系""轮藻与陆生植物关系几何"这类深时节点上给出磐石般的支撑。植物线粒体基因组则惰性得惊人:突变速率只有叶绿体的十分之一甚至更低。看似短板,实为解读深层分歧的利器——其他标记因进化太快而信号饱和时,线粒体基因里残存的古老变异,恰似冰川融水冲刷出的远古河床。对早期被子植物线粒体基因组的系统分析,正是靠着这类慢速基因,头一次以高支持率敲定了被子植物最基部三支的精确拓扑,让"无油樟与睡莲谁先分出"这场二十年的争论画上句号。
表 常用分子标记的分工
| 标记 | 遗传方式 | 速率 | 最佳尺度 | 主要风险 |
|---|---|---|---|---|
| 叶绿体光合大亚基基因 | 母系 | 慢 | 科目级骨架 | 属种分辨率不足 |
| 叶绿体成熟酶基因 | 母系 | 中 | 族属级关系 | 引物通用性有限 |
| 叶绿体非编码区间 | 母系 | 快 | 种下与杂交溯源 | 长度变异致比对困难 |
| 核糖体间隔区 | 双亲 | 快 | 属种级条形码 | 种内多态性与假基因 |
| 核糖体小亚基基因 | 双亲 | 极慢 | 界门级深时节点 | 信息位点过少 |
| 线粒体基因 | 多为母系 | 极慢 | 基部分支拓扑 | 长度多变与水平转移 |
💡 关键直觉:标记谈不上谁优谁劣,只有合不合适。拿深时标尺去量种内分化,与拿游标卡尺去量山脉,犯的是同一种错误。
三、范式跃迁:APG 系统的静默革命
分子标记若是砖石,被子植物系统发育组系列系统便是用这些砖石砌成的穹顶,而它的历次翻修,本身就是范式升级的编年史。
第一版(1998)降生于测序技术的黎明。 当时数据来自世界各地实验室的零散提交,总数不足万条。它最了不起的地方在于敢于对形态直觉说不:把伞形科与五加科从传统双子叶里摘出、归入新目;确认木兰类并非单系,而是一串基部分支。这并非因为数据占了压倒性上风,而是形态趋同造成的系统误差,在分子信号面前再也藏不住——第一版的实质,是一场凭初步分子证据完成的形态学祛魅。
第二版(2003)跨入多基因协同分析的时代。 数据量翻了十倍,关键进步在于承认并刻画类群各自特有的进化速率:菊类叶绿体基因的速率明显快过豆类,硬套统一模型只会严重扭曲内部关系。分区似然模型应运而生,不同基因片段可以各自拥有最优替换模型与速率参数——分子系统学自此由粗放整合转入精耕细作。
第三版(2009)迎来高通量测序的晨光。 取样思路改为密集采样:一个科不再只挑代表种,而是把各亚科族属的典型成员一网打尽。这一改,大批形态上含混不清的"孤儿科"现了形——比如南美一个长期被塞进禾本目的小科,分子数据却把它钉到了单子叶基部。第三版不再满足于大体正确,转而追求拓扑的无遗漏与完备。
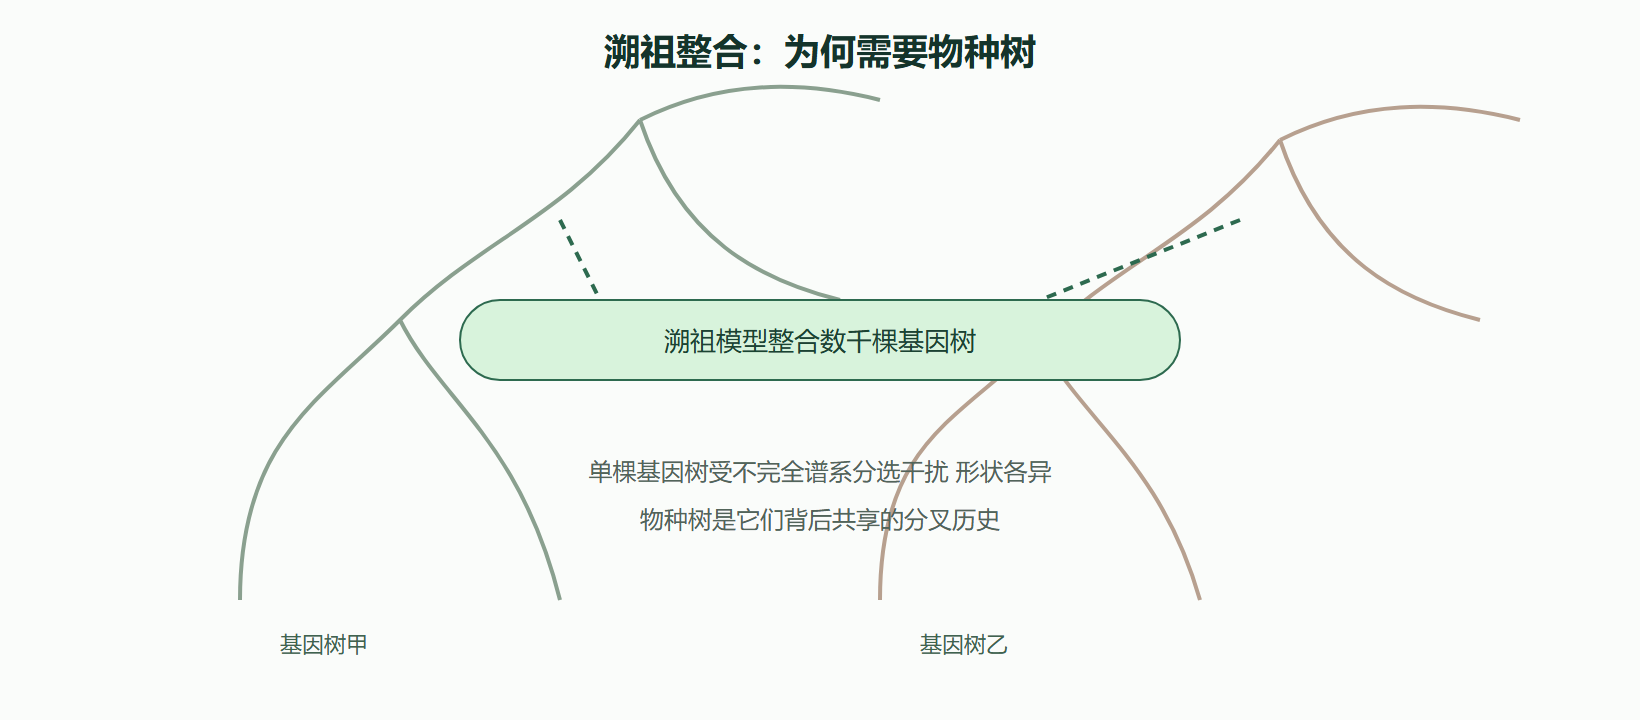
第四版(2016)全面拥抱基因组尺度的共识。 千余种被子植物的数百个核基因、完整叶绿体基因组及部分线粒体片段被整合到一起。单个基因树之间的冲突至此不再被当作噪声清理,而是放进溯祖模型的框架里解析:物种形成过程中发生的不完全谱系分选得到正式建模。最终交付的不再是某条"最佳基因树",而是整合数千棵基因树之后、后验概率最高的那棵物种树。它承认演化自身的纷繁,并举起统计学的盾牌,抵御单个位点带来的随机颠簸。
这场演进堪比天文望远镜的换代:第一版望见了行星,第二版看清了环带,第三版绘出地表沟壑,第四版开始分析大气成分——口径没换,认知的颗粒度与确定性早已今非昔比。
四、四大支柱:超越线性流水线
今天的重建框架,早已跳出"测序、比对、建树"三点一线的流水线,其稳固立于四根支柱之上。
第一支柱:把生物学知识嵌进位点进化模型。 序列不再被当成抽象符号串:密码子不同位置速率各异、茎环结构约束着非编码区的进化、GC 含量偏倚左右突变谱——这些都被编入更复杂的混合模型。模型至此不只是拟合工具,而成了表达生物学知识的语言。
第二支柱:把不确定性说出口。 一棵树不再是一张静止的图,而是一个概率分布。贝叶斯推断吐出成千上万棵后验树样本;最大似然法配以自展检验,给每根分支标上统计支持值。我们学会了说"该分支的后验概率为零点九八"——这是谦逊,更是科学的力量所在。
第三支柱:数据类型的战略性混搭。 单核苷酸多态性靠位点数量取胜,分辨率高,适合捕捉快速辐射事件;基因存在缺失与全基因组共线性则在更深的节点上提供稳健的宏观信号。这不是多多益善的问题,而是各司其职的安排。
第四支柱:可重复性的基础设施。 从原始测序数据、中间比对文件,到最终树文件与分析脚本,全流程被容器化、版本化并附上标准化元数据,任何研究者都能一键复现——分子系统学就此告别黑箱手艺,成为可证伪、可批判、可累积的现代科学实践。
⚠️ 常见坑:把单基因树当作物种关系的定论。在杂交频繁的类群里,叶绿体树往往只记录了母系的历史;遇到基因树打架,正确做法是补独立核基因标记并做溯祖分析,而不是挑一棵"顺眼"的树。
实操:分区模型建树的命令行实践
真实研究中,分区似然模型与溯祖物种树都由命令行工具完成,典型流程如下:
# 1. 用 IQ-TREE 做分区分析:每个基因片段自动选最优替换模型 iqtree2 -s concatenated.fas -spp partition.nex -m MFP+MERGE -B 5000 -T AUTO --prefix angiosperm_parted # 2. 基因树逐个推断,供后续溯祖整合使用 iqtree2 -s aligned_loci/ -S 250 -m GTR+F+R -B 1000 --prefix gene_trees # 3. ASTRAL 以全部基因树为输入,汇总出物种树 java -jar astral.jar -i gene_trees.treefile -o species_tree.tre 2> astral.log
三条命令分别对应"分区建树—基因树批量推断—溯祖汇总",正是第四支柱可重复性基础设施的最小闭环:输入、参数、输出全部落盘。
实操:读入 Newick 树并检查分支支持率
from Bio import Phylo tree = Phylo.read("species_tree.tre", "newick") for clade in tree.find_clades(order="level"): if clade.confidence is not None and clade.confidence >= 95: spp = [t.name for t in clade.get_terminals()][:4] print(f"支持率 {clade.confidence:.0f} -> 节点成员示例: {spp}")
拿到树文件之后的第一个动作永远是审视支持率:后验或自展值高的分支才值得写进结论,低于阈值的节点应明确标注不确定——第二支柱"把不确定性说出口"落到代码层。
图 从基因树到物种树的溯祖整合
核心回顾
- 要点一:分子钟的真身是相对变异的积累,重建就是寻找最能解释数据的那组树与模型。
- 要点二:标记按速率梯度分工——慢的量深时,快的量种级;叶绿体讲母系故事,核基因补上双亲视角。
- 要点三:线粒体基因的惰性反而让它成为厘清基部类群拓扑的钥匙。
- 要点四:APG 四版一路走过形态祛魅、分区建模、密集采样,抵达基因组共识与溯祖整合。
- 要点五:基因树的冲突不是噪声,而是不完全谱系分选的信号,应交给物种树方法整合。
- 要点六:可重复性基础设施让系统学成为可累积的科学,而不再是黑箱手艺。
骨架与标尺均已备齐,下一节去看这棵树上真正精彩的部分:每个大分支各自亮出了怎样的演化绝活。