3.1 数组语法与整体操作
3.1 数组语法与整体操作
本节摘要:数组是 Fortran 的一等公民,本节的使命是把这套语法武器库打开:三要素(秩、形状、大小)定义数组身份,列优先布局决定缓存命中率,切片与三元组做精细取数,整体数组运算与 where/merge 掩码消灭显式循环。读完你能写出"像数学一样"的数组代码,并预判每条语句在内存层面的行为。
一个三重循环的委屈
一段典型的热扩散模拟,每个时间步都要更新整块网格。新手写法是三重循环:外层时间、中层行、内层列,逐元素加。跑起来不是不对,而是慢得可疑——同一段逻辑,别人用一行数组表达式,速度还快几倍。这不是语言玄学,是 Fortran 把"数组运算"做成了语义承诺:编译器拿到整数组表达式,敢向量化、敢重排。手写循环时,它反而畏手畏脚。本节就从这条分界线讲起。
三要素:秩、形状、大小
数组的身份由三个元数据确定:秩(rank)是维度数,标量 0 维、向量 1 维、矩阵 2 维;形状(shape)是每个维度的大小;大小(size)是元素总数。声明 real :: a(3,4) 意味着秩 2、形状 (3,4)、大小 12。
program array_basics use iso_fortran_env, only: real64 implicit none real(real64) :: a(3, 4) write(*,*) 'rank =', rank(a) write(*,*) 'shape =', shape(a) write(*,*) 'size =', size(a) end program array_basics
三个内在函数输出 (2)、(3 4)、(12)。这些元数据是数组操作的安全网:形状不匹配的赋值会被编译期或运行期拦截,而不是静默错位。
列优先:决定缓存命中的隐藏规则
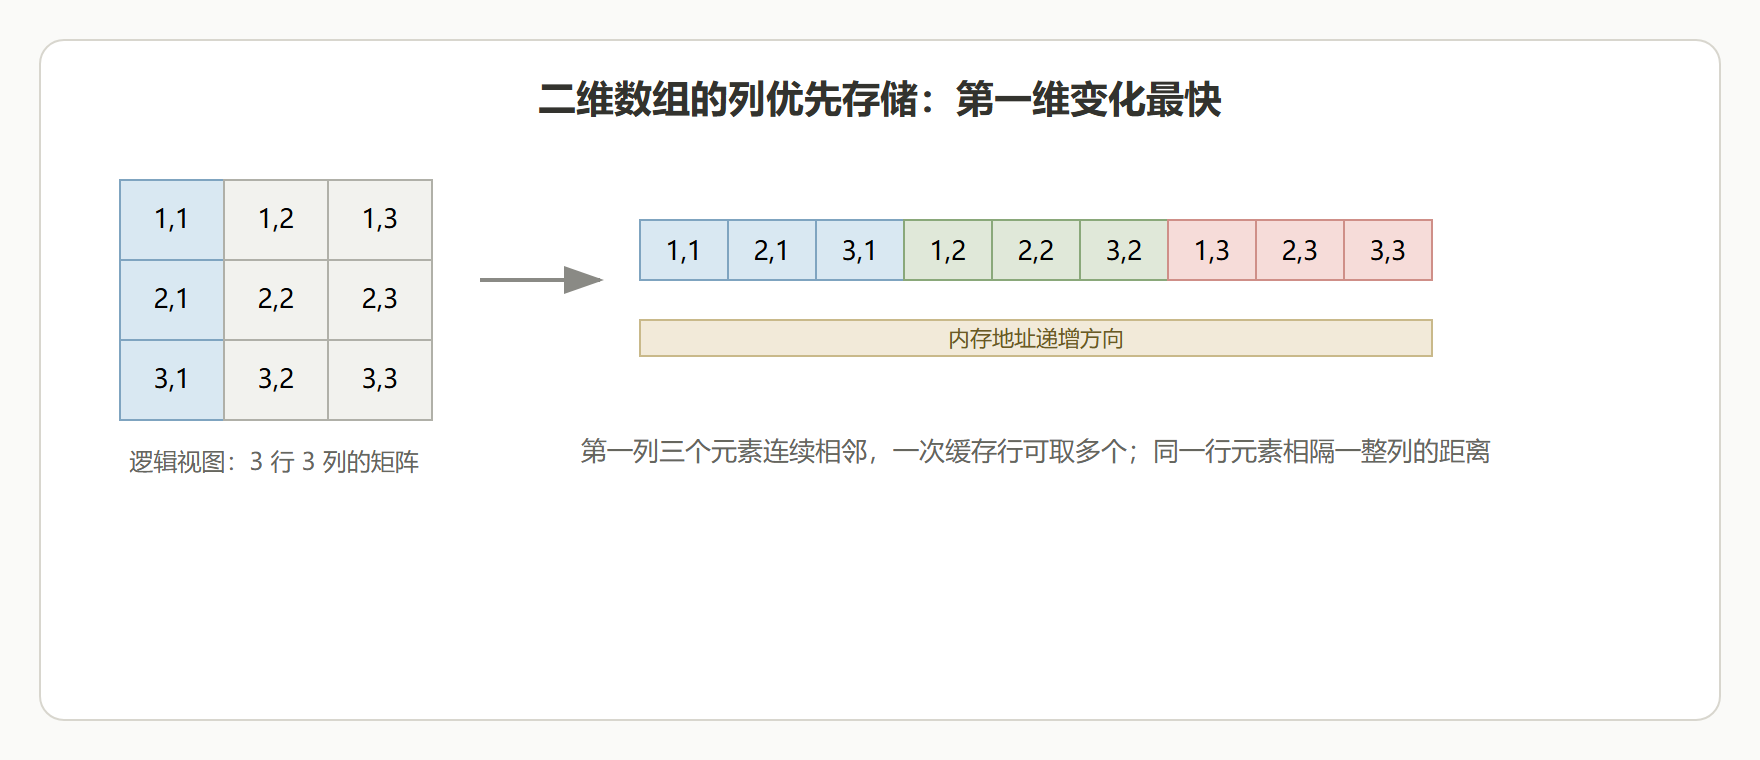
Fortran 数组按列优先存储:第一维(最左边下标)变化最快。声明 a(3,4) 的内存顺序是 a(1,1)、a(2,1)、a(3,1)、a(1,2)……C 语言是行优先,恰好相反。这条规则直接决定缓存表现:CPU 按缓存行取数,连续访问才能把预取吃满。
program cache_demo use iso_fortran_env, only: real64 implicit none real(real64) :: a(100, 100) integer :: i, j real(real64) :: t ! 列优先友好:内层循环跑第一维,内存连续 do j = 1, 100 do i = 1, 100 t = a(i, j) end do end do ! 缓存不友好:内层循环跑第二维,每次跳 800 字节 do i = 1, 100 do j = 1, 100 t = a(i, j) end do end do end program cache_demo
两个循环做的事一样,第一个通常明显更快。规则记住一条:最内层循环尽量对应第一维。用整体数组操作时编译器会自动遵循布局,这也是"数组优先"能赢的地方之一。
图:列优先存储与缓存行
切片与三元组:精细取数的两种姿势
三元组 start:end:stride 是切片的基本语法。a(1:10:2) 取第 1、3、5…个元素;省略写成 a(:)(整维)或 a(2:5)(步长 1)。向量下标用整数数组作下标,a([1,3,5]) 取指定位置。
program slice_demo use iso_fortran_env, only: real64 implicit none real(real64) :: m(6, 6) integer :: i m = 0.0_real64 do i = 1, 6 m(i, i) = 1.0_real64 ! 对角线置 1 end do m(1:6:2, :) = -1.0_real64 ! 奇数行整行赋 -1,用三元组 write(*,*) m(:, 1) ! 打印第一列 end program slice_demo
步长为 1 的切片内存连续,向量指令友好;步长大于 1 的切片是"取稀疏点",性能打折。频繁用 a(::2, :) 这类大跨度切片时,要意识到编译器可能无法向量化。切片赋值的形状必须匹配——这是 Fortran 的强类型纪律,也是运行时少报越界事故的原因。
整体运算与掩码:告别显式循环
整体数组运算的核心价值是向编译器宣告"逐元素、无依赖"。算术、比较、内置函数都能作用于整个数组,配合 where 与 merge 处理条件逻辑,几乎可以写出零显式循环的数值代码。
program vectorized use iso_fortran_env, only: real64 implicit none real(real64) :: u(100), v(100), w(100) logical :: mask(100) u = [(real(i, real64), i = 1, 100)] ! 隐含 do 构造器 v = 2.0_real64 * u w = u + v ! 整体加法 mask = w > 100.0_real64 where (mask) w = log(w) ! 只对满足条件的位置取对数 elsewhere w = 0.0_real64 end where write(*,*) sum(w), maxval(w), minloc(w) ! 归约内置函数 end program vectorized
where 本质是掩码赋值,编译器把它编译成向量谓词操作而不是跳转分支,这在 SIMD 与 GPU 上都占便宜。sum、maxval、matmul 等内置函数多由 BLAS 级的优化实现,别用自己手写的循环去挑战它们。
一个性能提醒
整体表达式 c = a + b + d 可能被编译器展开成两步临时数组:先算 a+b 存临时内存,再加 d。现代编译器多半会做表达式融合避免临时数组,但别依赖它。性能敏感路径上,如果一个表达式层层嵌套,考虑拆成几步或显式写循环——这不算退步,是知道编译器什么时候需要帮忙。数组语法是给编译器发许可证,不是免了所有思考。
学习目标
阅读完本节,你应当能够:
- 说出数组的秩、形状、大小并计算给定声明下的元素总数
- 画出二维数组的列优先存储顺序,判断一种循环顺序是否缓存友好
- 用三元组与向量下标构造数组子集
- 用整体赋值、算术、where、merge 写一段无显式循环的向量化代码
本节要点回顾
- 三要素定义数组身份:秩、形状、大小,是强类型安全网的根基
- 列优先决定缓存:最内层循环对应第一维,否则白烧缓存带宽
- 三元组是切片主力:步长 1 连续友好,大跨度切片要警惕向量化失效
- 整体运算即语义承诺:无显式循环 + where/merge 掩码,编译器敢向量化
- 内置归约函数优先:sum、matmul 等背后是 BLAS 级优化
- 复杂表达式留意临时数组:必要时手动拆分,把优化机会还给编译器
数组怎么表达学会了,下一步是怎么在形态之间搬运——构造与重构。