5.3 参数化派生类型与现代泛型
5.3 参数化派生类型与现代泛型
本节摘要:继承解决"行为差异",参数化派生类型(PDT)解决"类型差异"——同一种矩阵,因为精度不同就要复制四遍代码,这是泛型要消灭的重复。本节讲清 PDT 的 kind/len 两类参数、延迟长度参数的使用,再展望 Fortran 2023 的模板化过程设计,最后给出当前标准下务实的替代方案。
同一种矩阵,为什么写了四遍
线性代数库的经典噩梦:同一套矩阵乘法,要为单精度、双精度、单精度复数、双精度复数各写一份,名字还不同(sgemm、dgemm、cgemm、zgemm)。算法一模一样,只是类型不同。改一处 bug 要同步四份,漏一份就出现"这个精度对、那个精度错"的幽灵问题。参数化派生类型的使命,就是让类型本身带上参数——精度作为参数传进去,一套定义覆盖所有变体。
PDT:把精度与维度变成类型参数
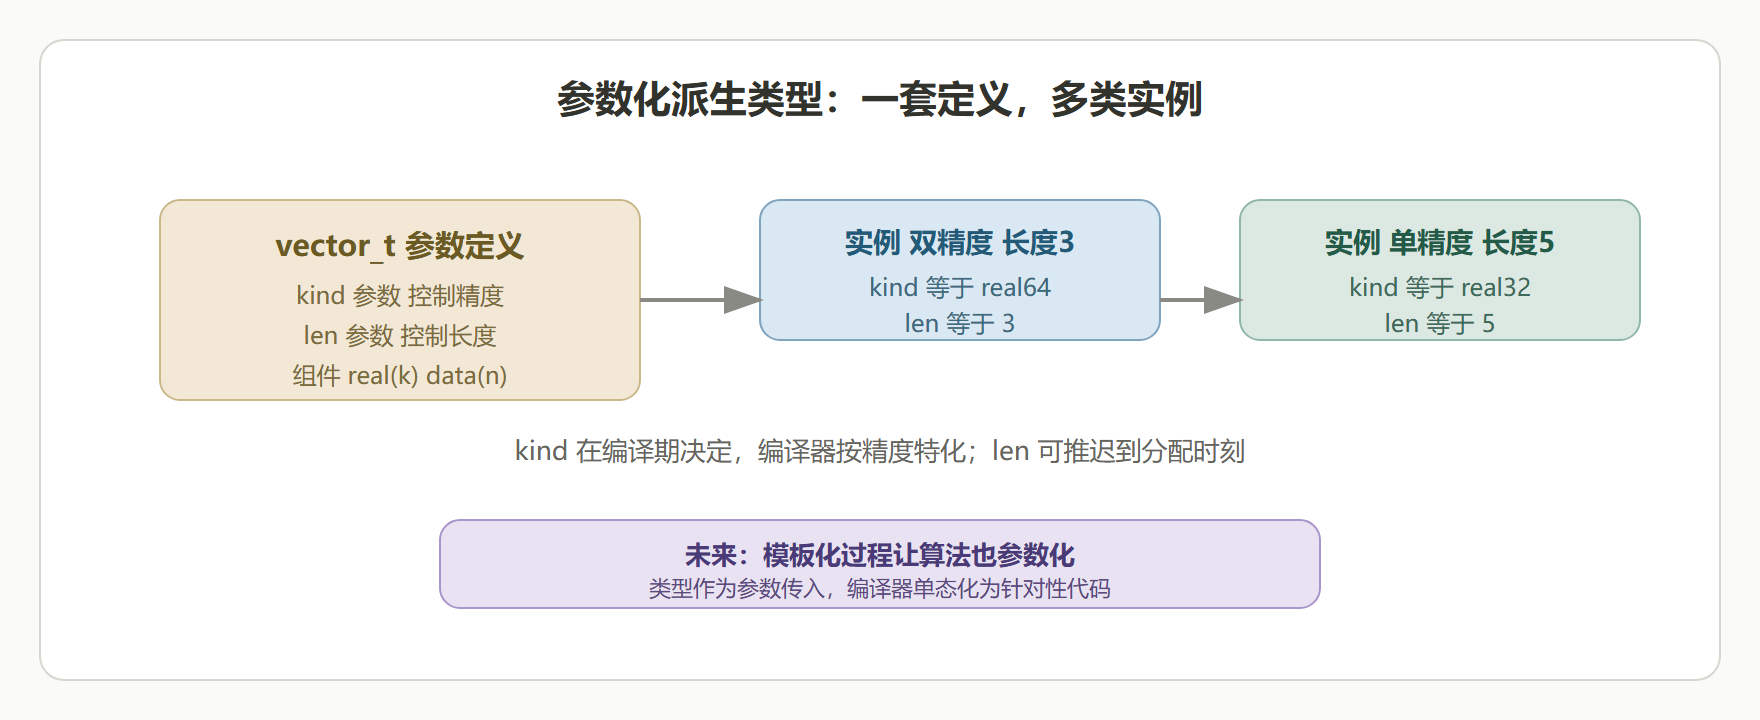
PDT 在类型定义时声明参数:kind 参数(控制精度/表示)与 len 参数(控制长度/维度)。声明变量时像调用一样实例化。
module vector_mod use iso_fortran_env, only: real64, real32 implicit none type :: vector_t(k, n) integer, kind :: k ! 种类参数:元素精度 integer, len :: n ! 长度参数:元素个数 real(k) :: data(n) end type vector_t contains ! 类型绑定过程:点积 function vec_dot(self, other) result(d) class(vector_t(*, *)), intent(in) :: self, other real(self%k) :: d d = sum(self%data * other%data) end function vec_dot end module vector_mod program pdt_demo use vector_mod, only: vector_t, vec_dot use iso_fortran_env, only: real64 implicit none type(vector_t(real64, 3)) :: a, b ! 实例化:双精度、3 元素 a%data = [1.0_real64, 2.0_real64, 3.0_real64] b%data = [4.0_real64, 5.0_real64, 6.0_real64] write(*,*) 'dot =', vec_dot(a, b) ! 32.0 end program pdt_demo
class(vector_t(*, *)) 是"任意 kind、任意 len"的通用引用方式,让过程能接受任何实例化版本。kind 参数通常在编译期确定,编译器能据此生成针对性指令;len 参数灵活但可能引入运行时开销。
长度参数与延迟长度
len 参数还有"延迟"形态:声明时不给具体长度,分配时再定。这对变长字符串和动态容器特别有用。
module text_mod implicit none type :: text_t(len) integer, len :: len character(len=len) :: content end type text_t end module text_mod program len_demo use text_mod, only: text_t implicit none type(text_t(:)), allocatable :: msg ! 延迟长度 allocate(text_t(11) :: msg) ! 分配时确定长度 msg%content = 'hello world' write(*,*) msg%content end program len_demo
延迟长度把"多长"推迟到 allocate 时刻,兼顾类型安全与动态性。代价是分配时才有确定布局,热路径上要斟酌。
图:PDT 的参数结构与实例化
从 PDT 到现代泛型:Fortran 2023 的方向
PDT 参数化的是数据结构,还没到"过程本身接受类型参数"。Fortran 2023 草案在讨论的模板化过程,就是让子程序/函数带类型参数:写一个 normalize(type_t),编译器按调用处的实参类型实例化——单态化,为每个用到的类型生成专门代码。这比虚函数表多态更彻底:编译期决定、零间接寻址、可内联,性能与手写特定类型代码一致。配套的"约束"概念会限制类型参数必须支持的操作(比如必须能加法),把错误从实例化内部提到调用点。
这项特性的价值在大型数值库:现在靠 include 宏把同一算法展开 N 份,以后一套代码覆盖所有精度与容器类型。但它依赖编译器实现成熟,社区共识是"方向明确、落地尚需时日"。
现状的务实选择
在 2023 泛型全面落地前,三条替代路线各有地盘。include 宏:把算法源码用文件包含 + 类型占位展开多份,历史最长但破坏编译器语义检查,报错信息对着展开后的临时文件,调试痛苦。泛型接口(第 4 章):同名绑定多个具体过程,编译期按实参类型分派,适合"类型数量有限、愿意手动写各版本"的库。PDT:参数化数据结构,配合泛型接口可以覆盖多数"同算法多精度"需求。选型建议:核心库先上"PDT + 泛型接口",把 include 宏留在必须兼容旧编译器的角落;新项目盯住 2023 泛型落地进度,一旦编译器支持就迁移。
学习目标
阅读完本节,你应当能够:
- 定义一个带 kind 参数的派生类型,并在声明时实例化
- 区分种类参数与长度参数的作用与约束
- 说出 Fortran 2023 泛型(模板化过程)的设计方向与"单态化"思想
- 评价 include 宏、泛型接口、PDT 三种当前替代方案的适用场景
本节要点回顾
- PDT 参数化数据结构:kind 管精度、len 管长度,一套定义覆盖多类实例
- 延迟长度推迟到分配时刻:变长字符串与动态容器的基础
- 2023 泛型把类型参数化推向过程:单态化换取零开销与可内联
- 约束概念把错误提到调用点:类型必须支持的操作在调用时校验
- 现状三选一:include 宏、泛型接口、PDT 各有边界,新库优先 PDT 加泛型接口
- 泛型的本质是消灭"同算法多类型"复制:与继承消灭"同接口多行为"互为补充
抽象层讲完,下半程进入性能战场——并行计算。