6.1 共阵列:语言内建的并行模型
6.1 共阵列:语言内建的并行模型
本节摘要:协同数组(coarray)把分布式内存并行直接写进语言:程序以"映像"为单位运行,方括号语法访问其他映像的数据,同步语句保证一致性。本节讲清映像模型、协同数组声明、远程访问与同步的规则,并给出 PGAS 模型相对 MPI 的取舍——它省心,但在细粒度通信上有自己的边界。
从 MPI 的显式消息说起
分布式内存并行的老牌标准是 MPI:每个进程有自己的内存,跨进程交换数据靠显式的发送与接收。代码里充斥着 send、recv、tag、communicator——一个简单的数组交换要写好几十行。MPI 强大,但它把"通信"这个动作完全暴露给程序员,认知负荷高,且细粒度通信的代码极易出错。协同数组(Fortran 2008 起)的目标,是把分布式并行从"显式通信"变成"像访问本地变量一样访问远程数据"。
映像与协同数组:把分布式写进声明
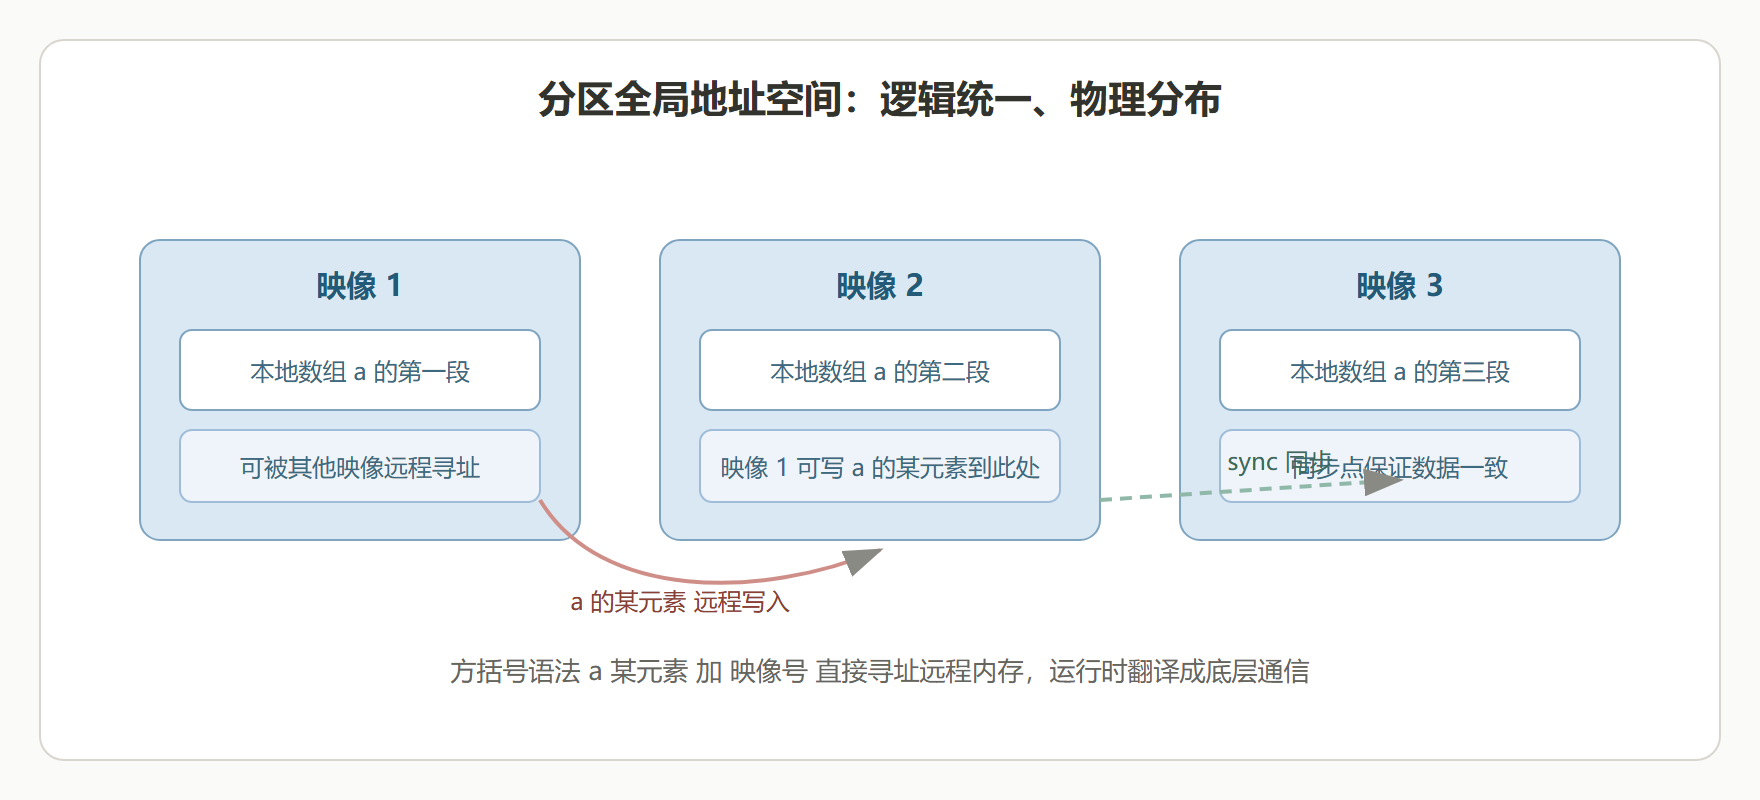
协同数组模型里,程序的每个并行执行实例叫映像(image)。声明 real :: a(100)[*] 表示:每个映像都有一份长度为 100 的数组 a,[*] 表示"在所有映像上分布"。用下标 a(i)[j] 访问第 j 个映像上的第 i 个元素——远程访问的语法和本地访问几乎一样。
program coarray_demo use iso_fortran_env, only: real64 implicit none real(real64) :: a(100)[*] ! 每个映像都有一份,可远程访问 integer :: me, nimg, i me = this_image() ! 我是第几个映像 nimg = num_images() ! 一共几个映像 ! 每个映像初始化自己的那份 do i = 1, 100 a(i) = real(me * 100 + i, real64) end do sync all ! 所有映像完成初始化后再继续 ! 映像 1 读取映像 2 的数据 if (me == 1 .and. nimg >= 2) then write(*,*) 'image2 a(10) =', a(10)[2] end if ! 每个映像把自己这份的第一个元素发给下一个映像 if (me < nimg) then a(1)[me + 1] = a(100) ! 远程写入:把 a(100) 写到下一个映像 end if sync all end program coarray_demo
this_image() 与 num_images() 是基本探针。sync all 是全局同步点:所有映像都执行到这里才继续,避免"我还没写完你就来读"的竞态。协同数组的运行时库负责把远程访问翻译成底层通信(通常就是 MPI),程序员不用碰发送接收。
远程访问与同步
远程访问是一方通信(one-sided):写方直接寻址目标映像的内存,不需要目标映像参与代码配合。这比 MPI 的成对通信简单得多。代价是同步要靠程序员自己:sync all 全体同步,sync images(list) 只和指定的映像同步。规则就一条:读别人写的数据之前,先同步。忽略同步的后果是竞态与未定义行为——并行 bug 最难查的就是这类。
program halo_exchange use iso_fortran_env, only: real64 implicit none real(real64) :: u(0:100)[*] integer :: me, nimg me = this_image() nimg = num_images() u = 0.0_real64 ! 填本地边界,然后与相邻映像交换边界值 sync all if (me > 1) u(0) = u(100)[me - 1] if (me < nimg) u(100) = u(0)[me + 1] sync all end program halo_exchange
这个一维 halo 交换是区域分解的入门操作:每个映像管一段区间,只和邻居换边界。用 MPI 写至少二十行,协同数组五、六行搞定。注意 sync 成对出现——写之前同步确保邻居的数据就绪,读之后同步确保别人能安全读我的。
PGAS 的取舍:省心,但别拿它当万能药
分区全局地址空间(PGAS)模型的核心承诺:全局可见、局部拥有。它的优势是代码简洁、与串行代码结构接近、编译器能利用通信模式做优化。边界也很清楚:一是细粒度的逐元素远程访问会产生大量小消息,通信开销按条计,性能反而不如一次打包的 MPI 传输;二是协同数组运行时在不同编译器的实现成熟度不一,跨编译器移植要测试;三是调试工具对协同数组的支持弱于 MPI,出问题难定位。
| 维度 | 协同数组 | MPI |
|---|---|---|
| 通信表达 | 远程变量访问,代码接近串行 | 显式 send/recv,控制力强 |
| 学习成本 | 低 | 高 |
| 细粒度通信 | 消息小、开销高 | 可批量打包,效率可控 |
| 生态成熟度 | 编译器实现有差异 | 工具链与库最成熟 |
选型建议:节点间并行首选协同数组做原型——开发快、可读性好;需要精细控制通信模式、或要对接既有 MPI 生态库时,再回到 MPI。两者还能共存,生产级代码常以 MPI 为主干、局部用协同数组简化热点。
图:PGAS 模型——全局地址空间里的映像与远程访问
编译与运行
协同数组需要编译器开协同数组运行时:gfortran 用 -fcoarray=single(单映像,调试用)或 -fcoarray=lib(多映像,配合 caf 运行时);ifx 用 -coarray。运行命令类似 MPI:cafrun -n 4 ./program。初学建议先单映像跑通逻辑,再上多映像,别一步到位。同步点越多,通信开销越大,能少同步就少同步。
学习目标
阅读完本节,你应当能够:
- 解释"映像"概念,说出协同数组声明的方括号语法含义
- 用协同数组完成一次跨映像的数据写入与读取
- 说出 sync all 与 sync images 的区别与用途
- 对比协同数组与 MPI 的适用场景,给出选型依据
本节要点回顾
- 映像是有独立内存的执行实例:
[*]声明"每个映像各有一份" - 远程访问是一方通信:写目标映像不需要它配合,但同步必须自己负责
- sync all 与 sync images 分工:全体同步与定向同步,读写前都要想清楚
- PGAS 省心但有边界:细粒度通信开销高、工具链不如 MPI 成熟
- 选型看场景:原型与热点简化用协同数组,精细通信与生态对接用 MPI
- 先单映像调试再上多映像:同步点越少越好
节点间搞定了,看节点内——OpenMP 多线程。