3.1 调度器核心机制:滴答、就绪表与上下文切换
3.1 调度器核心机制:滴答、就绪表与上下文切换
本节摘要:调度器的全部运转浓缩在两个例行程序里——滴答中断驱动时间前进并轮转同级任务,切换例程完成现场的保存与恢复。本节解剖滴答中断里做的每件事、就绪链表加优先级位图如何实现常数时间的任务挑选,再把一次上下文切换拆到汇编层:哪些寄存器硬件自动压栈、哪些要手工保存、第一个任务的初始现场是如何"伪造"出来的。读完,调度器对你不再是黑盒,第 8 章的开销测量也有了理论坐标。
第 2 章说过调度器"立刻"就能切换——本节兑现这个"立刻"的内部细节。这一节不要求你写汇编,但要求你看懂汇编在做什么:排障到深层(硬故障、切换异常、栈帧分析)时,这几百纳秒的机器动作就是你的案发现场。
一、滴答中断:内核的心跳起搏器
滴答由一个硬件定时器按配置频率产生(1 千赫兹即每毫秒一次),中断服务程序里内核完成四件事。第一,滴答计数加一——全系统的时间基准,所有延时与超时都以它为准。第二,服务延迟链表:检查按到期时刻排序的睡眠任务,把到期的逐一唤醒(移入就绪链表),2.2 节讲的"只看链表头"就发生在这里。第三,时间片轮转:若开启了同优先级轮转且当前任务所在级别还有别的就绪任务,让当前任务排到队尾。第四,裁决抢占:醒来任务的优先级若高于被打断的任务,请求一次切换。此外还有个附赠节目:滴答钩子函数在此执行,轻量的周期性杂务(统计计数、观测翻转)可以挂这里。
值得琢磨的是效率设计:四件事都刻意做成"通常无事可做"的形态——延迟链表头部没到期就立刻返回,同级无竞争就不轮转,醒来任务不够高就不切换。滴答是全系统频率最高的中断,它的耗时是纯粹的系统税,内核把它压到极致。
二、就绪表:常数时间挑出下一个任务
调度器最频繁的问题是"现在该谁跑"。朴素实现是遍历所有任务取最高优先级,任务一多就成了性能税。FreeRTOS 的答案是一组按优先级分桶的链表加一个位图:每个优先级一条就绪链表,位图记录"哪些优先级上非空"。挑选时先从位图找最高的非空位(开启移植优化时用处理器的前导零计数指令,一两条指令搞定),再取该链表第一个任务——整个过程与任务总数无关,恒定几条指令。
/* 挑选逻辑的骨架(示意,真实代码含 SMP 分支) */ #define taskSELECT_HIGHEST_PRIORITY_TASK() \ { \ UBaseType_t uxTopPriority = uxTopReadyPriority; \ listGET_OWNER_OF_NEXT_ENTRY( pxCurrentTCB, \ &( pxReadyTasksLists[ uxTopPriority ] ) ); \ }
两个细节。其一,取"下一个"而不是"第一个":同优先级链表是环形遍历的,每次切换移到下一项——时间片轮转其实就藏在这个环形步进里,滴答只是触发它的节拍器。其二,位图的最高非空位维护着缓存(每次有任务就绪时更新),挑选时连位图扫描都省了。这套结构是"数据结构为算法定制"的教科书案例:链表管归属,位图管查找,环形步进管轮转。
三、上下文切换:两个栈之间的接力
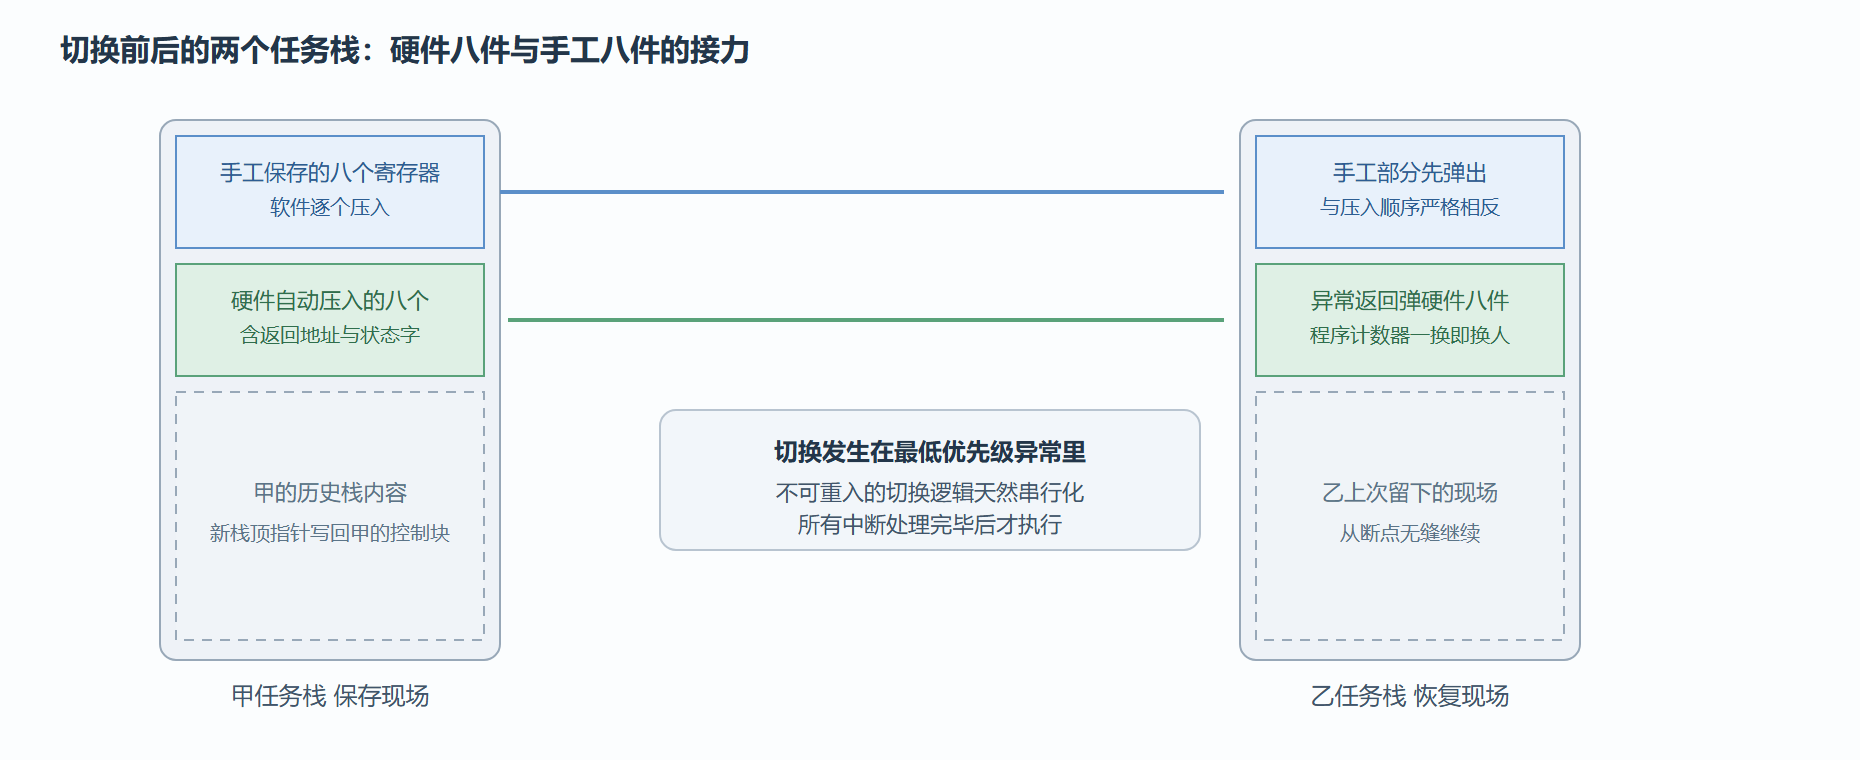
切换的触发点在 2.3 节列过:任务阻塞、主动让出、被更高优先级抢占。触发后真正的动作发生在 Cortex-M 的一个特殊异常里——挂起服务异常。选它做切换场所有个精妙理由:它是唯一可以被配置成最低优先级的异常,而切换逻辑不可重入(切到一半又来切换会乱套),放在最低优先级意味着"切换永远排队等到所有中断处理完才发生",天然串行化,还避免了中断嵌套里的栈搬家难题。
一次切换的完整接力,以任务甲让位给任务乙为例:
第一步,硬件自动压栈。进入异常时,硬件把八个寄存器(四个参数与临时寄存器、链接寄存器、程序计数器、程序状态寄存器)自动压入甲的任务栈。这八个是"硬件知道要救"的部分,无需软件插手。
第二步,手工保存其余寄存器。切换例程把另外八个被调用者保存的寄存器(四个编号靠后的通用寄存器加上几个平台寄存器)逐个压入甲的栈;若芯片带浮点单元且任务用过浮点,浮点寄存器组也要压。至此甲的完整现场全部躺在甲的栈里。
第三步,更新控制块。把甲的当前栈顶指针写回甲的控制块首字段——2.1 节说"栈顶指针放在控制块第一位",此刻兑现。
第四步,挑选并恢复。调用挑选逻辑选出乙,取乙的控制块,读出乙的栈顶指针装入栈指针寄存器,然后反向执行第二步与第一步:弹出手工保存的寄存器,异常返回时硬件自动弹出那八个寄存器——程序计数器一换,处理器就开始执行乙的代码了。
/* 切换例程骨架(示意,已删去浮点与 SMP 分支) */ PendSV_Handler: mrs r0, psp /* 取当前任务栈指针(任务用过程栈) */ stmdb r0!, {r4-r11} /* 手工保存被调用者保存寄存器 */ bl vTaskSwitchContext /* 内核挑选下一个任务,更新当前控制块指针 */ ldr r0, =pxCurrentTCB ldr r1, [r0] /* 取新任务控制块 */ ldr r0, [r1] /* 读它的栈顶指针 */ ldmia r0!, {r4-r11} /* 恢复手工部分 */ msr psp, r0 /* 装载新任务栈指针 */ bx lr /* 异常返回,硬件弹出其余八个 */
八行汇编,一次接力。顺带解释一个架构词汇:Cortex-M 的栈是"满递减"——压栈先减地址再存数,栈向低地址生长。这解释了 2.4 节溢出为什么向下踩邻居,也解释了栈底哨兵为什么设在低地址端。
一次切换的栈帧接力
四、第一个任务:伪造现场送上天地
还有个先有鸡还是先有蛋的问题:切换需要"新任务的栈里已有现场",可系统刚启动时所有任务都还没跑过,栈里哪来的现场?答案是内核的栈初始化函数替每个任务伪造一份初始现场:按真实切换后栈该有的样子,把任务函数地址放进程序计数器位置、参数指针放进第一个参数寄存器位置、程序状态字放进 Thumb 位(Cortex-M 只执行 Thumb 指令集,该位必须置一)、链接寄存器放一个"任务函数意外返回时"的兜底入口——2.1 节说任务返回等于掉出世界,兜底入口就是接住它的网(通常是死循环加断言)。
调度器启动函数随后做三件事:配置滴答定时器与中断优先级(把切换异常与滴答都设为最低优先级)、初始化就绪表、然后触发一个"启动服务调用"异常,它的处理函数直接取最高优先级任务的栈做恢复现场的动作——不做保存(没有旧任务可存)。异常返回的一瞬,处理器"以为"自己刚从中断回到任务,实际上它正进入第一个任务。启动过程骗过了硬件,干净利落。
💡 把这套机制记成一句排障口诀:任务栈里离栈顶最近的两层,是"手工八件"与"硬件八件"——硬故障后栈帧分析(第 7 章)全靠在这两层里找返回地址,判断故障发生在任务上下文还是中断上下文。
五、开销:这套机制的价目表
切换的代价是"手工八件"的压与弹加链表操作,在常见 Cortex-M 内核上典型量级是数百个处理器周期(不含浮点现场,带浮点翻倍不止)。滴答的开销则等于"每次滴答的固定成本乘以频率"——1 千赫兹滴答在 48 兆赫兹主频的芯片上约占百分之一强的处理器时间。两个数字都不算大,但它们是税:任务切得越频繁(优先级差小、事件越密),税越重。第 8 章会给出实测方法,把"我的系统交了多少调度税"变成可管理的指标;而本节的机制知识正是测量结果得以被解释的依据——比如"开浮点后切换时间近乎翻倍"这种现象,只有看过栈帧接力图才知道原因在浮点寄存器组也要进出栈。
本节要点回顾
- 滴答做四件事:推进计数、唤醒到期任务、同级轮转、裁决抢占——每件都设计成"通常无事可做",税负压到最低;
- 就绪表三件套:按优先级分桶的链表管归属、位图管查找、环形步进管轮转,挑选成本与任务总数无关;
- 切换是栈间接力:硬件八件自动压、手工八件软件压、控制块存栈顶、反向恢复到新任务;
- 切换放在最低优先级异常里天然串行化,避开嵌套中断的栈搬家难题;
- 第一个任务的现场是伪造的:函数地址、参数、状态字、返回兜底,一次启动异常送入运行态;
- 价目表:单次切换数百周期、滴答固定成本乘频率——调度税可算可测,第 8 章实测。
机器在裸芯片上还是跑不起来——滴答从哪个定时器来、异常优先级谁配置、栈初始化怎么和编译器对齐?下一节看内核与芯片之间的那份契约:移植层。