第 1 章 LevelDB 概览与设计哲学
第 1 章 · LevelDB 概览与设计哲学
章节摘要:这一章解决三个问题——LevelDB 从哪来、它信奉什么、它擅长什么又不擅长什么。我们从 Google 的 Bigtable 讲起,看 LSM-Tree 如何从巨型分布式系统里被抽出来变成一把轻量级单机工具;再用"向顺序写入妥协"这条主线贯穿它的全部设计哲学;最后用一张特性/局限对照表,帮你划清它的适用边界。读完这一章,你应该能回答一个高频问题:LevelDB 和传统 B+树数据库,到底差在哪?
核心问题
阅读完本章,你应当能够:
- 讲清 LevelDB 与 Bigtable、SSTable 的继承关系,以及它诞生的工程背景
- 解释 LSM-Tree 为什么能把随机写变成顺序写,且说清这个转变的代价
- 列出 LevelDB 的设计哲学主线(写优化、延迟合并、有序键空间、嵌入式)并各给一个例子
- 用一张表对比 LevelDB 的核心特性与固有局限
- 判断一个具体场景该不该选 LevelDB,而不是盲目套用
核心概念速览
本章金句:LevelDB 把"磁盘上数据时刻有序"这个执念放下了,换来的是一次写入只花一次顺序追加的成本——所有整理工作都推迟到后台,这是它全部性能秘密的起点。
图:本章知识全景
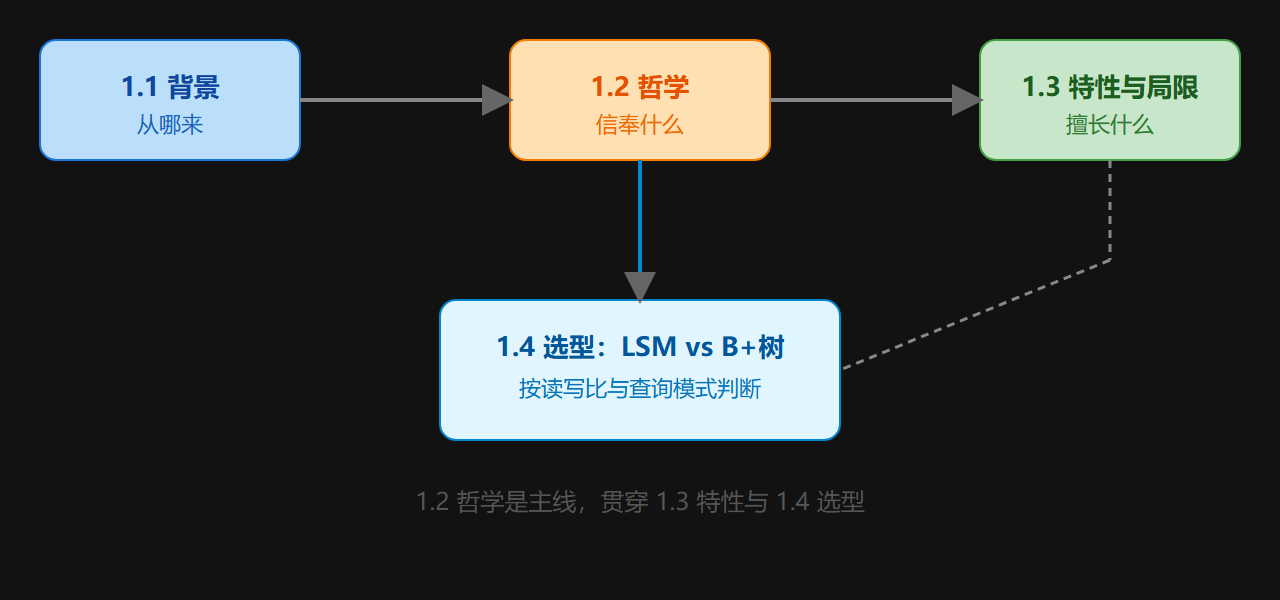
子章节导航
1.1 从 Bigtable 到嵌入式引擎:背景与起源
讲 LevelDB 是怎么从 Google 内部的 Bigtable 系统里被 Jeff Dean 和 Sanjay Ghemawat 提炼出来的,以及当时开发者们面对的"单机高性能 KV"需求空白。
1.2 设计哲学:向顺序写入妥协的艺术
拆解三条核心信念:顺序 I/O 优先、把昂贵整理推迟到后台、坚持有序键空间与嵌入式定位。这是理解全书所有细节的"操作系统"。
1.3 核心特性与局限:高写吞吐的另一面
用一张对照表讲清楚:高写入吞吐、原子批处理、快照读这些优势,各自对应什么代价——读放大、写放大、空间放大、调优复杂度。
1.4 LSM 与 B+树选型:何时选哪个
本章的对比驱动落点:从读放大的数学直觉出发,给出 B+树与 LSM 的适用边界判断框架,并解释为什么"没有更好的引擎,只有更合适的引擎"。
章节速览表
| 小节 | 核心问题 | 读完能掌握 |
|---|---|---|
| 1.1 背景与起源 | LevelDB 从哪来 | Bigtable 的继承关系、嵌入式定位 |
| 1.2 设计哲学 | 它信奉什么 | 顺序写优先、延迟合并、有序键空间 |
| 1.3 特性与局限 | 它擅长什么 | 高写吞吐的另一面是"三放大" |
| 1.4 LSM vs B+树 | 何时选它 | 按读写比与查询模式的选型框架 |
⚠️ 注意:1.2 是本章最难也最重要的一节,是后续所有章节的"操作系统",建议慢读。
💡 提示:读 1.4 前,先自己想想"为什么 MySQL 用 B+树而 LevelDB 用 LSM",再对照正文。
子章节之间的逻辑关系
1.1 背景(从哪来) │ 解释动机 ▼ 1.2 哲学(信奉什么)── 提供主线 ──► 1.3 特性与局限(好与坏一体两面) │ │ └────────── 提供判断依据 ──────────────┴──► 1.4 选型(何时用)
1.1 回答"为什么会有 LevelDB",给 1.2 的哲学提供历史背景;1.2 的三条信念是 1.3 特性/局限的推导前提(写优化必然带来读放大);1.3 把优劣势摆全,1.4 才谈得上"按场景选择"。
为什么要把"哲学"单独讲一章
很多人会觉得"设计哲学"是虚的东西,不如直接讲怎么用。但 LevelDB 恰恰是一个"哲学先行"的引擎——它几乎每一个组件、每一行关键设计,都能从几条核心信念里推导出来。如果你只记住了"MemTable 是内存表、SSTable 是磁盘文件",遇到新问题仍然无从下手;但如果你理解了"它的一切是为了向顺序写妥协",那么看到一个不认识的机制,你也能猜出它为什么存在。
哲学的价值还在于"抵抗信息过载"。LevelDB 资料很多,参数很多,机制很多——但如果它们都挂在那几条主线上,你就不需要"背"它们,而是可以"推导"它们。这也是本书选择"对比驱动"作为叙事主调的原因:对比能逼你思考"为什么是 A 不是 B",而"为什么"正是通往本质的路径。
本章使用建议
如果你时间有限,可以只读 1.1 和 1.4:1.1 让你知道 LevelDB 的出身(理解它为什么长这样),1.4 让你知道怎么选型(理解它的边界)。如果时间充裕,请完整读四节——1.2 的哲学是理解后续所有章节的钥匙,1.3 的特性/局限对照是后续调优判断的基础。
读的时候建议带着一个问题:"如果让我重新设计一个写密集的键值引擎,我会怎么取舍?" 你会发现 LevelDB 的每一个选择都给了你一个可参考的答案,而当你对某些选择不认同时,你已经开始有自己的判断了——这正是从"学习者"走向"设计者"的标志。
本章在全书的位置
第 1 章是全书的地基:它建立了"Lsm 心智模型"(写优化 + 延迟合并)和"三放大成本账"(读/写/空间放大)这两个贯穿全书的分析框架。第 2、3 章在这个地基上盖楼,第 4 章装武器,第 5 章管秩序,第 6 章谈调优,第 7 章看生态,第 8 章入源码。每一章都在反复引用本章的两个框架——所以这一章值得你读得慢一点、想得深一点。
读完本章,你应该能做到:向一个没接触过 LevelDB 的人,用三句话讲清楚它是什么、为什么这么设计、适合什么场景。如果讲不出来,说明框架还没建立,建议回头重读 1.2 和 1.3 节。
常见疑问预告
本章会回答几个读者最常问的问题:LevelDB 和 Redis 有什么区别?为什么不用 B+树?它和 RocksDB 是什么关系?如果你也有这些疑问,它们会在本章和后续章节里得到逐步展开的答案。带着问题读,收获会比"从头到尾读一遍"大得多。
前置知识与后续延伸
- 前置知识:了解操作系统"顺序 I/O 快于随机 I/O"这一基本物理事实即可,不需要数据库背景;若懂一点 B+树更好,但 1.4 节会重新讲。
- 后续延伸:第 2 章会把本章的哲学落地成具体组件——MemTable、SSTable、Manifest 如何把"写优化"变成代码;第 3 章看它们如何配合完成读写与压缩。