2.1 整体架构:内存、磁盘与元数据的三角协同
2.1 整体架构:内存、磁盘与元数据的三角协同
本节摘要:LevelDB 的整体架构可以概括成"一个二分法则 + 一套异步沉降机制":内存追求极致的写入速度,磁盘保障海量容量与持久性,而元数据系统负责记录"哪个文件在哪一层、管哪个键范围"。本节给出这张三角协同的全景图,并走一遍写读两条微观旅程,帮你建立理解后续所有组件的地图。
本节地图
阅读完本节,你应当能够:
- 画出 LevelDB 架构的三大域(内存、磁盘、元数据)及其职责
- 解释"异步数据沉降"如何化解内存易失与磁盘持久的矛盾
- 描述写路径的五步流程与读路径的查找顺序
- 说明 Manifest 与 Current 在架构中的导航角色
一、问题与直觉
一个存储引擎最根本的矛盾是什么?是"内存快但易失,磁盘久但慢"。
如果只把数据放内存,重启就丢;只放磁盘,写入就慢。LevelDB 的解法不是二选一,而是让数据在两者之间流动:先落内存快速响应,再异步沉降到磁盘保证持久,同时用一套元数据记录全局状态。
你可以把它想象成一个图书馆:新书先登记在临时工作清单上(内存),方便立即查询;清单积累到一定规模,管理员把书归档到结构化的永久书架(磁盘);同时有一本总目录(元数据)记录所有书的归档位置。整个架构就是围绕"三个部分的协同 + 数据在它们之间的有序流动"构建的。
二、核心原理
三大域:职责分明
内存域(高速、易失):活跃 MemTable 承接所有新写入,Immutable MemTable 是冻结待刷盘的状态。目标是最大化吸收写入吞吐。
磁盘域(大容量、持久):SSTable 文件按层级组织。Level-0 由内存直接刷出,文件间键范围可能重叠;Level-1 及以上通过 Compaction 生成,同一层内文件键范围不重叠、全局有序。
元数据域(记忆与导航):Manifest 记录文件层级与键范围,Current 指向当前 Manifest,WAL 保证 MemTable 数据的持久性备份。
层级化的核心意义
为什么要分层?因为每一层的数据"整洁度"不同。L0 是内存直接倾倒的产物,键范围乱;L1+ 经过 Compaction 整理,同一层内文件间键范围不重叠。
这个设计的回报很直接:在 L1 及以上层级,给定一个键,至多只需检查一个 SSTable 文件。查找从"可能要看十个文件"变成"二分定位到唯一一个文件"。这是读路径能保持高效的关键。
两条微观旅程
写路径五步:
- 序列化后追加 WAL(顺序写磁盘)
- 插入活跃 MemTable(内存跳表)
- MemTable 超阈值,转 Immutable,创建新活跃表
- 后台线程把 Immutable 排序压缩刷成 L0 SSTable
- 更新 Manifest,释放对应的 Immutable 与 WAL 段
读路径四站:
- 查活跃 MemTable
- 查 Immutable MemTable
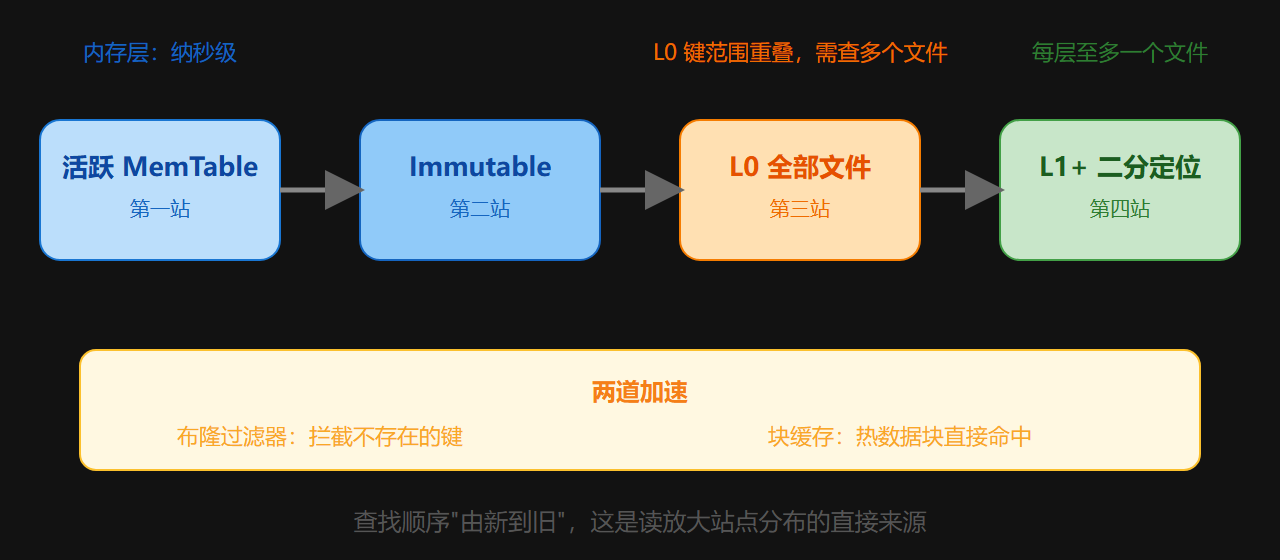
- 查 L0(键范围重叠,需检查所有可能文件)
- 查 L1+(键范围不重叠,二分定位至多一个文件)
三、工程实践要点
架构特性对照
| 特性 | 来源 | 隐藏代价 |
|---|---|---|
| 惊人写入吞吐 | 顺序追加 + 内存缓冲 | 写放大 |
| 良好顺序读 | 有序键空间 + 层级整理 | 读放大 |
| 自动整理压缩 | 后台 Compaction | 后台 I/O 竞争前台 |
| 崩溃可恢复 | WAL + Manifest 重建 | 元数据一致性成本 |
⚠️ 常见坑:读取延迟会因 Compaction 波动。这不是 bug,而是设计的一部分——后台合并与前台读共享磁盘资源。理解了这一点,你就不会在监控里看到延迟抖动时误判为"引擎坏了"。
💡 关键直觉:架构上最难的点是"数据在流动,但读者看到的视图必须是静止的"。解法是元数据版本化——读者锁定一个版本,后台随便改,读者不受影响。这个思想在第 2.4 节会展开。
SOURCE 独有事实
Compaction 策略的目标是控制下一层数据量约为当前层的 10 倍(默认放大系数为 10)。换句话说,每深一层,总数据量大致放大十倍,最终形成指数级的数据金字塔。这个"10 倍"数字是理解 LevelDB 写放大与读放大量级的基石——它也解释了为什么数据规模越大,深层文件越大,一次 Compaction 的代价越高。
四、深入展开:把架构当"系统"而非"组件清单"
图:一次读操作的四站旅程
为什么必须是异步的
本节强调"异步数据沉降",这个词值得掰开揉碎。异步的本质是:把代价高昂的操作从调用者的时间线上剥离出去。MemTable 满了要刷盘,这是耗时操作;如果同步执行,写入线程就必须等刷盘完成才能继续——写入吞吐瞬间塌方。异步让"刷盘"由专门的后台线程消化,调用者写完就返回,时间线上的阻塞被转移到后台。
但这带来一个新问题:如何保证"异步"不出乱子?答案是状态转移的明确性——活跃 MemTable 冻结为 Immutable 是瞬间的、确定的状态转换;后台刷盘只对 Immutable 负责;新写入只对新的活跃 MemTable 负责。三者各管一段,靠状态切换衔接,这就是异步系统能保持正确性的原因。它再次印证了架构哲学:清晰的状态边界,是异步系统不出错的根基。
内存域与磁盘域不是对立的,是流水线
很多初学者把"内存"和"磁盘"理解成"二选一",其实在 LevelDB 里它们是流水线的两端。数据不会"存在内存里"或"存在磁盘里",而是"正在从内存流向磁盘"。理解了这个流水线视角,你就能解释许多看似矛盾的现象:
- 为什么刚写入的数据立即就能读到?因为它在 MemTable 里,读取第一站就是内存
- 为什么重启后刚写入的数据还在?因为 WAL 里记着账,恢复时重放
- 为什么删除后空间不立刻释放?因为墓碑要等它从 L0 流到深层,Compaction 才能清除
整个 LevelDB 就像一条传送带:写入在头部进料(内存),整理在中间分拣(Compaction),最终在尾部入库(深层 SSTable)。读操作是这条传送带上的"抽查员",元数据是传送带的"调度图"。
架构上最容易被低估的角色:元数据
在三大域里,元数据域最不起眼,却承担着"没有它系统就失忆"的重任。没有 Manifest,系统不知道磁盘上有哪些文件、各管哪些键;没有 Current,系统重启时不知道从哪个 Manifest 开始恢复;没有 WAL,内存里的最新数据在崩溃后无从重建。
从工程角度看,元数据是"状态持久化"的核心:文件数据本身是结果,元数据是"这个结果是如何一步步到达的"记录。把元数据设计成日志(Manifest),比设计成"当前状态快照"更优雅——因为快照更新需要覆盖写,而日志只需要追加。这正是"只追加"哲学在元数据层的又一次贯彻。
一个架构视角的进阶问题
有人会问:为什么不把 Manifest 也做成"不可变文件 + 版本切换"?实际上它已经是了——Manifest 本质是记录版本变更的日志,Current 就是"指向当前版本"的指针,这跟 SSTable + Version 的模式如出一辙。你会发现 LevelDB 的设计有一个强烈的自相似性:无论数据层还是元数据层,都用"追加日志 + 当前指针 + 不可变快照"这三件套。识别出这种自相似模式,比记住每个组件的名字有用得多——它能帮你快速理解任何 LSM 系系统的结构。
常见问题
问:LevelDB 只有一个后台线程做 Compaction 吗? 标准实现里是的——一个后台压缩线程负责 Immutable 落盘和层级合并。这是"单写者模型"的自然延伸,换来实现简单,代价是 Compaction 吞吐有上限。这也是 RocksDB 引入多线程 Compaction 的动机。
问:如果磁盘写满了会怎样? 写入会失败并返回错误状态,这是可预期行为。但更隐蔽的风险是 Compaction 需要临时空间(新旧文件并存),如果空间不足,压缩会被卡住,进而触发写停顿。所以运维上建议预留至少一倍数据量的空闲空间,这是 LSM 系引擎的通用经验。
问:整体架构对理解读放大有什么帮助? 架构图就是读放大的说明书——读请求要依次经过 MemTable、Immutable、L0(可能多个文件)、L1+(每层一个文件),每多一站就多一次潜在 I/O。看到架构图,你就知道读放大的"站点"在哪里,也就知道该从哪个参数下手。
用架构回答一个实际问题:写入后立即读为什么快
理解整体架构后,一个常见困惑自然解开:为什么刚写入的数据,紧接着 Get 就能立刻读到、而且很快?因为在"由新到旧"的读取顺序里,第一步就查 MemTable——刚写入的数据就在那里,内存命中,纳秒级返回。数据甚至在它还没落盘的时候就已经可读。
这个特性的工程含义很直接:对于"写入后立即读回"的高频模式(比如会话状态、缓存回填),LevelDB 天然友好。反之,如果你的业务是"写一批、很久以后才读",内存缓冲的优势就体现不出来了,读取要深入磁盘,这才是读放大会显现的场景。同样一张架构图,换一个访问模式,结论完全不同——这就是"架构服务于访问模式"的实例。
架构视角下的一次故障演练
用一个故障场景把架构图"用起来":假设某个节点突然断电,重启后系统如何恢复?答案是三个组件依次接力:CURRENT 文件定位最新的 Manifest → 回放 Manifest 重建文件层级视图 → 回放 WAL 重建内存里尚未刷盘的数据。三个组件各管一段,缺一个都无法完整恢复。
这个演练说明:架构图的三个域不只是"静态分工",还是"故障恢复的接力链"。理解这条链,你就知道为什么 CURRENT、Manifest、WAL 一个都不能少,也知道为什么说"元数据域是系统的记忆"——记忆一旦缺失,磁盘上再多数据文件也只是一堆"失忆的档案"。把架构图当作故障演练的地图来用,比把它当成静态示意图理解得深得多。
要点串联
- 要点一:LevelDB 架构 = 内存域(写入入口)+ 磁盘域(持久归宿)+ 元数据域(全局记忆)。
- 要点二:异步数据沉降化解"内存易失 vs 磁盘持久"的矛盾。
- 要点三:L0 文件键范围重叠,L1+ 层内键范围不重叠且全局有序,这是读路径高效的关键。
- 要点四:写路径五步、读路径四站,核心原则是"由新到旧"的查找顺序。
- 要点五:Manifest 记录文件层级与键范围,Current 是定位当前 Manifest 的唯一入口。
- 要点六:层级数据量约 10 倍增长,塑造了读放大与写放大的量级。
下一节我们钻进内存域,看 MemTable 的双缓冲机制如何支撑写入不停顿。