第 2 章 核心架构与组件剖析
第 2 章 · 核心架构与组件剖析
章节摘要:这一章把 LevelDB 的引擎拆开,看四个核心部分如何啮合:内存组件(MemTable / Immutable MemTable)、磁盘组件(SSTable)、元数据与版本控制(Manifest / CURRENT)、以及把它们串起来的整体架构。读完你会建立一张完整的"零件图"——知道一次写操作的数据最终躺在哪个文件里,一次读操作要经过哪些关卡,系统重启时靠什么把状态重建出来。
读前必看
阅读完本章,你应当能够:
- 画出 LevelDB 的整体架构分层图(内存域 / 磁盘域 / 元数据域)
- 说清 MemTable 与 Immutable MemTable 的"双缓冲"转换机制
- 描述 SSTable 文件内部结构:数据块、索引块、布隆过滤器、Footer
- 解释 Version、VersionSet、Manifest、CURRENT 四者如何配合完成版本管理与故障恢复
核心概念速览
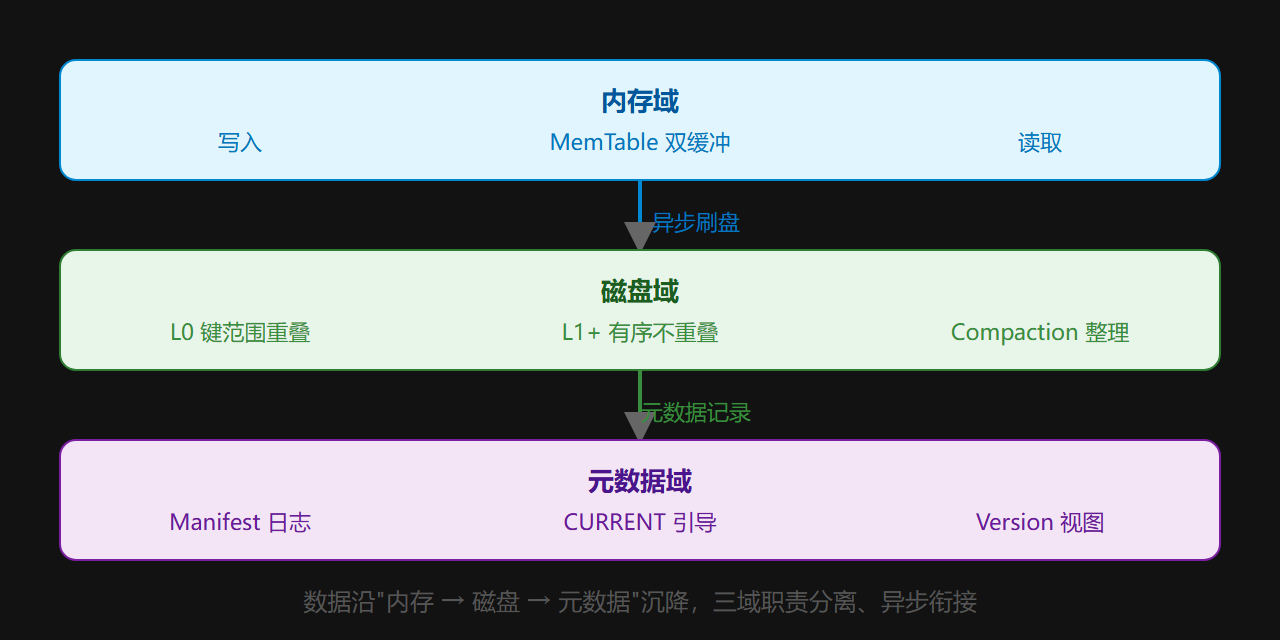
本章金句:LevelDB 的架构哲学是"职责分离"——内存管快、磁盘管久、元数据管记忆,三者通过异步流转和版本切换咬合,缺一不可。
图:数据在三大域间的沉降路径
子章节导航
2.1 整体架构:内存、磁盘与元数据的三角协同
先给全景:写入请求如何进 MemTable、刷成 SSTable、被 Manifest 记录;读取请求如何按"由新到旧"的顺序跨内存与多层磁盘查找。建立全书的架构坐标系。
2.2 内存组件:MemTable 与 Immutable 双缓冲
深入内存域:MemTable 为什么用跳表、条目如何编码序列号;写满后如何零停顿地切到 Immutable,后台线程如何异步刷盘。这是高写入吞吐的关键机制。
2.3 磁盘组件:SSTable 文件解剖
解剖磁盘上的数据文件:数据块、索引块、布隆过滤器块、Footer 各自的职责;为什么分块、为什么不可变。这是理解读路径和 Compaction 的前提。
2.4 元数据与版本控制:Manifest 与 CURRENT
回答三个问题:系统如何知道有哪些文件、每个文件管哪个键范围;重启时如何重建状态;并发读时如何拿到一致视图。Version / VersionSet / Manifest / CURRENT 四件套登场。
章节速览表
| 小节 | 核心组件 | 读完能掌握 |
|---|---|---|
| 2.1 整体架构 | 三层协同 | 写读两条路径的全景图 |
| 2.2 内存组件 | MemTable / Immutable | 双缓冲如何让写入不停顿 |
| 2.3 磁盘组件 | SSTable | 数据块/索引/过滤器/Footer 结构 |
| 2.4 元数据与版本 | Manifest / CURRENT | 视图管理与崩溃恢复机制 |
⚠️ 注意:2.4 是全章最难的一节,涉及版本链与引用计数,读不懂先放一放,回头结合第 3、5 章再读一遍。
💡 提示:读 2.2 时对比第 1.2 节的"延迟合并"哲学,你会看到哲学如何变成代码。
子章节之间的逻辑关系
2.1 整体架构(全景图) ├──► 2.2 内存组件(写入入口) ├──► 2.3 磁盘组件(数据归宿) └──► 2.4 元数据与版本(全局记忆)
2.1 先给坐标,2.2 和 2.3 分别展开坐标里的两片疆域(内存、磁盘),2.4 讲的是横跨两者的"记忆层"——没有它,系统不知道自己有什么、在哪、重启后是什么样。
为什么要把"零件"逐件讲清楚
第 1 章建立了哲学,但哲学是抽象的;本章要把哲学落到"看得见摸得着"的零件上。MemTable 是"写优化优先"的实现,SSTable 是"不可变 + 顺序写"的实现,Manifest 是"日志先行"的实现——每个零件都是哲学在工程上的化身。不把零件讲清楚,后面的写入流程、读取流程、Compaction 就没有"演员"。
这里也要提前打个预防针:本章信息密度较高,涉及多个组件、多个概念(双缓冲、文件结构、版本机制)。如果一次读不完,可以分两次:先读 2.1 建立全景,再逐个读 2.2-2.4。每个组件都不难,难的是把它们放在同一张图里理解——这正是 2.1 节存在的意义。
本章使用建议
读本章时,建议对照"一次写操作会碰到哪些组件"来走:写入 → MemTable(2.2)→ SSTable(2.3)→ Manifest 记录(2.4);再对照"一次读操作会碰到哪些组件"走一遍:MemTable → Immutable → SSTable → 版本定位(2.4)。用两条"旅程"串起所有零件,比孤立记忆每个组件有效得多。
本章在全书的位置
第 2 章是"静态架构"章:讲清系统由什么组成、各组件怎么咬合。第 3 章是"动态机制"章:讲清组件如何流转运转。建议把这两章当作一个整体来学——静态是动态的舞台,动态是静态的剧情。读第 3 章时如果觉得"某一步说不通",回头翻第 2 章找对应的组件,通常能豁然开朗。
本章自测
读完本章后,试着回答以下问题,检验掌握程度:
- 一次 Put 操作,数据会依次经过哪几个组件?(提示:WAL → MemTable → Immutable → L0 SSTable → Manifest 记录)
- 为什么 Level-1 及以上层级的点查"至多只查一个文件"?答案在第 2.1 节的层级化设计里。
- MemTable 切换成 Immutable 为什么能"瞬间完成"?对前台写入有什么意义?
- SSTable 的索引块和布隆过滤器各解决什么问题?它们如何配合?
- Manifest 和 WAL 都叫"日志",它们的记录对象有何不同?
- 如果 CURRENT 文件丢失,会发生什么?为什么它必须原子更新?
如果第 2 或第 5 题答不上来,建议回头重读对应小节。自测的目的不是"考倒你",而是帮你确认哪些概念还没真正"过脑"——能在不看正文的情况下讲清楚一个概念,才算真正掌握。
一张本章的地图
一次写入:WAL(持久承诺)→ MemTable(内存缓冲)→ Immutable(冻结)→ L0 SSTable(落盘) 一次读取:MemTable → Immutable → L0(可能多文件)→ L1+(每层一个文件) 全局记忆:Manifest(文件清单日志)→ CURRENT(指向最新清单)→ Version(内存视图)
这三行图概括了本章的全部内容:前两行是数据流经的路径(内存组件、磁盘组件),第三行是支撑两者的记忆层(元数据与版本)。把这张图记在脑子里,本章的四个小节就自然连成了一张网,而不是四个孤立的主题。
前置知识与后续延伸
- 前置知识:第 1 章的设计哲学(顺序写优先、延迟合并)是理解本章组件的钥匙;最好能回忆"三放大"的概念,本章会不断提到读放大与写放大。
- 后续延伸:第 3 章把本章的组件串成"写入流程、读取流程、Compaction"三条动态路径——届时你会看到静态架构如何在运行时运转。