第 3 章 读写路径与压缩机制
第 3 章 · 读写路径与压缩机制
章节摘要:这一章让 LevelDB 从静态架构"跑起来"。我们依次走过三条动态路径:写入流程(如何保证持久且高吞吐)、读取流程(如何在多层数据中快速定位)、压缩机制(如何在后台收拾残局)。读完你就能回答:一次 Put 到底经历了什么、一次 Get 为什么要查那么多地方、后台 Compaction 到底在干什么、以及"三放大"为什么是 LSM 系引擎绕不开的代价。
先说结论
阅读完本章,你应当能够:
- 画出写入流程的完整链路(WriteBatch -> WAL -> MemTable -> Flush)
- 解释组提交(Group Commit)如何提升高并发写入吞吐
- 说清读取路径"由新到旧"的查找顺序与布隆过滤器的配合
- 区分 Minor Compaction 与 Major Compaction 的触发与职责
- 用自己的话解释写放大、读放大、空间放大三者此消彼长的关系
核心概念速览
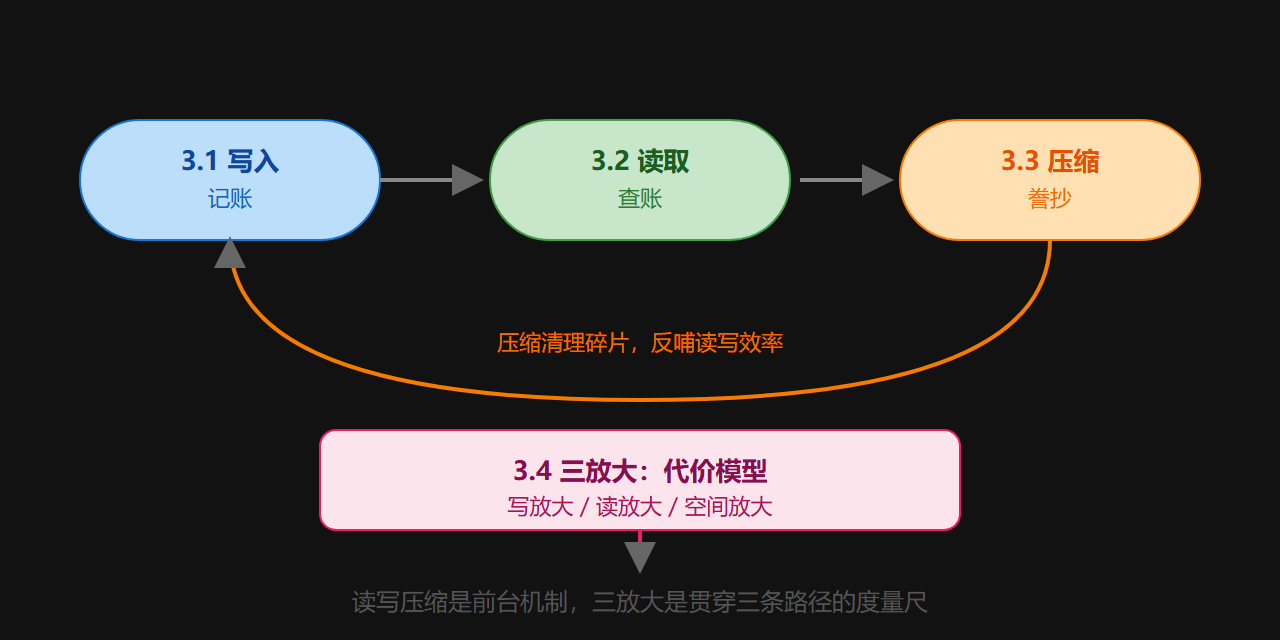
本章金句:写入是"把账先记下来",读取是"把账查清楚",压缩是"把账本定期誊抄一遍"——三件事各有各的节奏,LevelDB 的优雅在于让它们互相咬合而不互相踩脚。
图:数据生命周期循环
子章节导航
3.1 写入流程:WAL、WriteBatch 与组提交
从一次 Put 出发,走完"日志先行 + 内存写入 + 异步落盘"全链路;再拆解 WriteBatch 的原子性封装与高并发下的领导者-追随者组提交机制。
3.2 读取流程:从内存到多级磁盘的搜索
一个 Get 要经过 MemTable、Immutable、L0 全部文件、L1+ 每层一个文件的查找顺序,并全程受序列号(一致性视图)与布隆过滤器/块缓存(性能加速)的支配。
3.3 压缩机制:Minor 与 Major Compaction
讲清两级压缩体系:Minor 负责"内存固化",Major 负责"层级重组",以及多路归并时如何决定保留哪些版本、丢弃哪些墓碑。
3.4 读放大与写放大:理解代价的三个维度
本章的落点:把写放大、读放大、空间放大放进同一个框架里看,说明为什么"三放大"是 LSM 系引擎的宿命,以及它们在何时此消彼长。
章节速览表
| 小节 | 主题 | 读完能掌握 |
|---|---|---|
| 3.1 写入流程 | WAL / WriteBatch / 组提交 | 写路径全链路与高并发优化 |
| 3.2 读取流程 | 由新到旧分层查找 | 序列号、布隆过滤器、缓存的配合 |
| 3.3 压缩机制 | Minor / Major Compaction | 后台整理如何维持系统健康 |
| 3.4 三放大 | 代价模型 | 写/读/空间放大的此消彼长 |
⚠️ 注意:3.4 虽然放在本章末尾,但它是最值得先看的一节——先知道"代价是什么",再回头理解代价从哪来。
💡 提示:读 3.1 前复习第 2.2 节的 MemTable 双缓冲,写路径就是建立在它之上的。
子章节之间的逻辑关系
3.1 写入(记账) │ 产生数据碎片 ▼ 3.4 三放大(代价模型) ◄── 3.3 压缩(定期誊抄) ◄── 3.2 读取(查账) │ │ └──────── 贯穿三条路径的度量尺 ────────┘
3.1 和 3.2 是引擎的两条前台主路径;3.3 是后台整理机制,反过来决定前台的读写效率;3.4 把三者的代价统一到一个"三放大"模型里,是理解性能和调优的语言基础。
为什么把"写入、读取、压缩"放进同一章
这三个机制在教科书里常常被拆开讲,但它们在 LevelDB 里是纠缠在一起的:写入产生碎片,读取要忍受碎片,压缩清理碎片——三者互为因果。把它们放进同一章,是为了让你看到"一个动作牵动另外两个"的完整回路。只看写入流程,你会疑惑"为什么数据这么乱";只看压缩,你会疑惑"为什么非要这么折腾";合起来看,一切都有了答案。
这一章也是全书的"性能核心":三放大(3.4)是判断一切性能问题的语言,写入与读取(3.1、3.2)是调优的对象,压缩(3.3)是后台的发动机。第 6 章的调优,本质就是在操控本章的机制。
本章使用建议
建议按"先因果、再细节"的顺序读:先读 3.4 建立三放大模型(知道代价是什么),再回头读 3.1-3.3(理解代价从哪来)。先知道"结果",再看"原因",比从头到尾线性读更容易建立体系。读 3.3 压缩时,对照第 2 章的 SSTable 和 Manifest 组件,你会看到后台机制如何操作这些零件。
本章在全书的位置
第 2 章是静态架构,本章是动态机制——两者构成"系统如何工作"的完整答案。第 4 章的算法与数据结构是本章路径上使用的"武器",第 5 章的并发模型让本章的读写压缩在"单写多读"的舞台上运转,第 6 章的调优把本章的机制当操作对象。可以说,理解本章,你就理解了 LevelDB 的"日常行为";后续章节则是让这些行为更快、更稳、更能被理解。
本章自测
读完本章后,试着回答以下问题:
- 为什么写入要先写 WAL 再写 MemTable?这个顺序保证了什么?
- sync=true 和 sync=false 的区别是什么?各自牺牲了什么?
- 组提交(Group Commit)是怎么提升高并发写入吞吐的?
- 普通 Get 和快照读取的唯一区别是什么?
- Minor Compaction 和 Major Compaction 的触发条件分别是什么?
- 写放大、读放大、空间放大为什么此消彼长?
- L0 文件数为什么是"读写放大的共享预警指标"?
如果第 4 或第 6 题需要想很久,建议重读 3.2 和 3.4 节。这三道题的答案如果能脱口而出,说明你已建立起"读写压缩 + 三放大"的核心心智模型——它是后续调优(第 6 章)和选型(第 7 章)的共同基础。
本章的一条记忆线索
把本章四节串成一句话:写入负责"进账"(3.1),读取负责"查账"(3.2),Compaction 负责"理账"(3.3),三放大是"记账成本"(3.4)。 进账要快(WAL + 内存),查账要准(由新到旧 + 过滤),理账要勤(后台整理),成本要明白(写/读/空间放大)。这条线索帮你把四个看似独立的主题绑成一个整体,也让你在遇到性能问题时能快速定位"是哪一环的账出了问题"。
前置知识与后续延伸
- 前置知识:第 2 章的组件(MemTable、SSTable、Manifest)是本章的主角,建议先建立零件概念。
- 后续延伸:第 4 章的跳表、布隆过滤器、缓存是本条路径的"武器库";第 6 章的调优本质是操控本章的机制。