3.1 写入流程:WAL、WriteBatch 与组提交
3.1 写入流程:WAL、WriteBatch 与组提交
本节摘要:一次写入请求在 LevelDB 内部是一条精密接力赛:先写 WAL 确保崩溃可恢复,再写 MemTable 保证立即可见,最后由后台线程异步落盘。本节拆解这条链路的四个关键环节——WriteBatch 的原子封装、WAL 的持久化承诺、MakeRoomForWrite 的并发控制、以及高并发下提升吞吐的组提交机制,让你理解"写入快"到底快在哪、代价又是什么。
学习目标
阅读完本节,你应当能够:
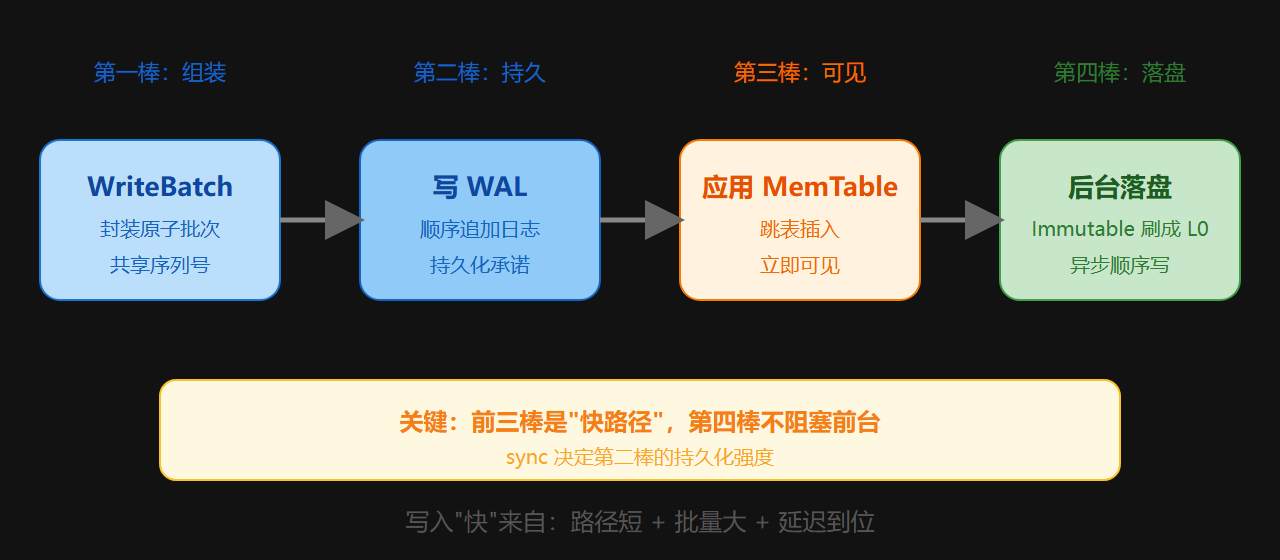
- 画出写入流程的四段链路(WriteBatch -> WAL -> MemTable -> Flush)
- 解释 WriteBatch 如何保证一批操作要么全成要么全不成
- 说清 sync 选项对持久性与性能的权衡
- 描述组提交(Group Commit)如何减少 fsync 次数
一、问题与直觉
先看一个冲突:用户想要"写进去了才返回成功",这叫持久性;但每次写都立刻落盘,性能会慢到没法用。怎么平衡?
LevelDB 用"日志先行"解决:写操作先追加到一个顺序日志(WAL),确认它进了日志就算持久化了;真正的数据整理(刷盘、合并)放后台慢慢做。这样,写入的慢活(磁盘同步)被压到最少,写入的路径变得极短。
另一个直觉问题:如果 100 个线程同时写,每次都拿锁、每次都会话同步,吞吐必然崩。LevelDB 的做法是让一个"领导者"线程把大家的写请求攒成一波,一次性持久化,再一起通知完成——这就是组提交。
二、核心原理
接力赛第一棒:WriteBatch 原子封装
用户的一次 Put 或一批操作,内部都被封装成 WriteBatch。它本质是一个字节序列,按序编码了操作类型和键值数据。
好处有三:减少锁粒度(一次锁保护一批)、提升 WAL 效率(一次 fsync 持久化多操作)、成为事务语义的基础。它是"待执行的蓝图",完整复制到 WAL 和应用到 MemTable,保证中间状态不会出现。
第二棒:WAL 持久化承诺
WriteBatch 准备好后,第一站是 WAL——顺序生成的日志文件。每个批次序列化后作为完整记录追加写入当前日志文件,记录格式含校验和、长度、批次数据。
关键的持久化点是 fsync。sync=false(默认)依赖操作系统定期刷盘,性能好但存在微小窗口的数据丢失风险;sync=true 每次写入都 fsync,持久性最强但性能损耗大。
核心价值:写入 WAL 成功 = 本次写入被系统"承诺"持久化。即使之后在写 MemTable 时崩溃,重启后重放 WAL 就能重建 MemTable 状态。
第三棒:MemTable 即时可见
WAL 成功落盘后,WriteBatch 中的每个操作依次应用到活跃 MemTable。Put 是插入或更新条目,Delete 是插入带删除标记的条目。这是纯内存指针操作,极快。
一旦应用到 MemTable,数据对后续读取立即可见——因为读取逻辑总是优先查最新的 MemTable。这就是写入低延迟的另一个来源。
第四棒:MakeRoomForWrite 与组提交
当活跃 MemTable 已满,写入流程进入"腾空间"的协调逻辑:
- 检查 L0 状态:L0 文件数超
level0_slowdown_writes_trigger时,写入线程主动触发/加速 Compaction 并短暂休眠(背压);超level0_stop_writes_trigger时完全阻塞写入。 - 切换 MemTable:活跃表转 Immutable,新建活跃表,把 Immutable 交给后台。
- 异步落盘:后台线程把 Immutable 有序刷成 L0 SSTable。
组提交的精髓:高并发时,只有一个队首写者承担领导责任,执行完整流程;其他写者排队等待。领导写完自己的批次后,把队列里其他批次"捎带"一次性写入 WAL 和应用到 MemTable,再通知大家完成。这把随机小写入合并成顺序大写入,显著降低 fsync 次数和锁竞争。
三、工程实践要点
写入权衡对照
| 决策 | 选项 | 收益 | 代价 |
|---|---|---|---|
| sync | false | 性能好 | 极端故障可能丢少量数据 |
| sync | true | 持久性最强 | 每次 fsync,吞吐下降 |
| WriteBatch | 批量提交 | 摊销锁与 fsync 开销 | 需应用层组织批次 |
| write_buffer_size | 调大 | 减少刷盘频率 | 内存涨、恢复慢 |
⚠️ 常见坑:把 sync=true 当默认值用。对绝大多数中间件场景,sync=false 配合 WAL 已足够——LevelDB 设计上接受"操作系统定期刷盘"的默认语义,频繁 fsync 会让写入吞吐暴跌到不可接受。
💡 关键直觉:把 WAL 想成"飞行记录仪"。飞机(写操作)落地(进 MemTable)之前,记录仪已经完整记下了这次飞行的指令。就算飞机坠毁(进程崩溃),黑匣子(WAL)也能还原它本来要干什么。这就是日志先行的本质。
SOURCE 独有事实
MakeRoomForWrite 是写入流程中最具技巧的部分。它不是一个简单函数,而是一个多阶段决策:先看是否有因 Immutable 过多导致的写停顿,再看 L0 文件数是否触发降速或停写,最后才执行 MemTable 切换。另外,WriteBatch 的二进制格式是"序列号(8 字节)+ 计数(4 字节)+ 记录列表",每条记录含操作类型、键长度、键内容、可选的值——这种紧凑自包含的编码让整个批次可以作为一条完整消息被原子处理。
四、深入展开:写入流程的工程权衡
图:写入接力赛四棒
sync 选项背后的"承诺语义"
sync=true 与 sync=false 的选择,本质是对"写入成功"这个承诺的严格程度的选择。仔细想一下两者的差别:
- sync=true:写入 WAL 后立即 fsync,数据真正落盘才返回成功。崩溃恢复万无一失,代价是每次写入都等待磁盘物理落盘,吞吐可以下降一个量级
- sync=false:写入 WAL 进入操作系统页缓存就返回成功,靠 OS 定期刷盘。正常运行时数据安全,但若在"返回成功"与"OS 实际落盘"之间的窗口发生断电,这部分写入会丢失
关键认知:LevelDB 的"成功返回"不等于"已落盘",只等于"已进日志缓冲"(sync=false 时)。对绝大多数业务这够用——因为丢失窗口只有几秒且概率极低。但如果是金融级对账、订单确认这类"丢一笔都出大事"的场景,就必须 sync=true。没有一种配置能同时给你极致吞吐和铁一般的持久性,这是物理定律,不是引擎缺陷。
组提交为什么能提升吞吐
高并发下,100 个写线程同时提交,如果各自为战,就是 100 次锁竞争 + 100 次 fsync(sync=true 时)。组提交把等待的写者排进队列,由队首"领导者"一次性把所有人的 WriteBatch 写进 WAL、应用进 MemTable,然后统一通知。这样 100 次请求只做 1 次锁竞争 + 1 次日志同步。
这个机制揭示了一个通用规律:批量操作是减少固定开销的最有效手段。固定开销(锁、fsync)不随数据量变化,摊到越多请求上,每个请求的边际成本越低。理解了组提交,你也就理解了为什么"把多个小写合并成一个大写"(第 5.1 节 WriteBatch)和"把多个小文件合并成大文件"(Compaction)遵循的是同一个道理。
写入流程里最容易被忽略的环节:背压
MakeRoomForWrite 里的降速/停写机制,本质是"背压"(Back-pressure)——当消费端(刷盘 + Compaction)跟不上生产端(写入)时,主动让生产端慢下来,而不是任其把系统拖垮。
这是很多系统设计里缺的一环。没有背压的写入,就像水龙头全开而排水口太细:水池(内存)迟早溢出来。LevelDB 的选择是宁可让写入线程短暂等待,也不让 L0 文件无限堆积导致读放大雪崩。对应用层来说,理解背压的含义是:写入延迟的尖峰不一定是引擎坏了,可能是它在自我保护。结合监控看 L0 文件数,你就能区分"引擎故障"与"引擎在背压"。
一个可以动手验证的观察
如果你用多个线程并发写,并开启 sync=false,会观察到吞吐远高于 sync=true 的配置;再对比"每次单写"与"每批 100 条写一次"两种方式的吞吐,后者的提升会非常明显。这个实验直观展示了组提交与批量操作的价值——不是靠听道理,而是靠数据说话。
常见问题
问:WriteBatch 里能混合 Put 和 Delete 吗? 可以。Delete 在批次里就是一条"带删除标记的操作记录",与应用 Put 的流程完全一致,只是应用到 MemTable 时插入的是墓碑条目。
问:WAL 文件什么时候删除? 当它所保护的 MemTable 刷盘完成、生成了对应的 SSTable 后,该 WAL 段就可以安全删除了。清理时机与 MemTable 刷盘进度绑定。
问:写入失败会怎样? 取决于失败点。WAL 写入失败 → 该批次不生效并返回错误;MemTable 应用失败 → 由于 WAL 已持久化,重启后重放仍能恢复,不影响正确性。这就是"先日志后内存"给的底气。
写入流程的"快"到底来自哪
把写入流程拆开看,"快"其实来自三处叠加:一是路径短——只有 WAL 顺序追加 + 内存插入两步,没有磁盘随机写;二是批量大——组提交和 WriteBatch 让单次开销被摊薄;三是延迟到位——刷盘和整理全被挪到后台,前台只做最轻的两步。
这三处叠加的效果是:写入延迟主要取决于"WAL 顺序追加的速度"(通常微秒到亚毫秒级),几乎不随数据总量增长。这正是 LSM 系引擎在写密集场景下的核心竞争力——它把"写快的路径"从数据结构里剥离出来,专门用顺序 I/O 喂饱。理解了这一点,你就能解释为什么同样是磁盘数据库,LevelDB 的写入能比传统的随机写模型快一个数量级。
一个容易被忽视的收益:批量写的连锁反应
批量写(WriteBatch)不只是省一次 fsync 那么简单。它还有三个连锁收益:一是减少锁竞争次数(一次锁保护一批);二是减少 WAL 日志的记录头开销占比;三是让 MemTable 的跳表插入更集中,利于缓存局部性。所以当你面对"写入吞吐上不去"的问题时,最先该检查的不是引擎参数,而是应用是否在用批量方式写入——很多性能问题,在调用层就解决了。
最后说一个容易混淆的细节:写入流程的"快"是有边界的——它快在"把数据安全地放进日志和内存",而"让数据真正整理到磁盘深层"是后台的事。所以写入延迟的承诺是"确认快",不是"落地快"。理解这个边界,你就不会在数据量大时对"写入变慢"感到意外——那是 Compaction 与写入竞争资源的正常现象,也是调优要关注的核心矛盾之一。
把写入流程的四步连起来再看一眼,你会发现它其实是一句口诀:先记账(WAL)、再上账(MemTable)、定时结账(Flush)、定期对账(Compaction)。 记账保证不赖账(持久性),上账保证及时可查(可见性),结账把账本固化(落盘),对账把旧账理清(整理)。这四步各自的节奏不同、职责不同,但共同构成了"写入"这件事的完整闭环。记住这句口诀,写入流程就不会再忘。
本节速览
- 要点一:写入链路 = WriteBatch 封装 -> WAL 持久化 -> MemTable 应用 -> 后台异步落盘。
- 要点二:WriteBatch 共享一个序列号,整批连续写 WAL,实现原子性。
- 要点三:WAL 写入成功是持久化承诺的标志,崩溃后靠重放恢复。
- 要点四:sync=false 靠 OS 刷盘,sync=true 每次 fsync,是性能与持久性的权衡。
- 要点五:MakeRoomForWrite 通过 L0 阈值触发背压,防止读性能雪崩。
- 要点六:组提交让领导线程捎带排队批次,减少 fsync 次数,提升高并发吞吐。
写进去了,接下来数据要被读出来。下一节看读取流程如何在多层数据里快速定位。