4.3 缓存机制:Table Cache 与 Block Cache
4.3 缓存机制:Table Cache 与 Block Cache
本节摘要:LevelDB 的缓存是双层的:Table Cache 缓存已打开文件的句柄与索引块,Block Cache 缓存解压后的数据块内容。这种分层不是巧合,而是对"钥匙"与"货物"访问特征差异的精准响应。本节拆解两层的职责、LRU 实现与并发处理,并解释缓存与 Compaction 的微妙互动——为什么后台合并读的数据不进缓存。
上手前先明确
阅读完本节,你应当能够:
- 区分 Table Cache 与 Block Cache 的缓存对象与职责
- 描述一次缓存未命中读请求经历的两级缓存路径
- 解释 LRU 在 Block Cache 中的实现(双向链表 + 哈希表)
- 说明 Compaction 读的数据为什么不能塞进 Block Cache
一、问题与直觉
先问一个根本问题:一个面向磁盘持久化的存储引擎,缓存的战略价值是什么?
答案藏在一条永恒的性能不等式里:内存访问延迟 << 磁盘 I/O 延迟。纳秒对毫秒,差了好几个数量级。如果没有缓存,一次 Get 哪怕定位到了目标 SSTable,也要经历"打开文件 -> 读索引块 -> 定位数据块 -> 读数据块 -> 解压"这整整一条昂贵链路。
缓存的任务,就是把这些高频访问或代价高昂的中间产物留在内存里,把后续访问"短路"掉。但缓存什么、怎么分层,大有讲究。
二、核心原理
双层架构:钥匙与货物
LevelDB 的缓存不是单一内存池,而是两层分工:
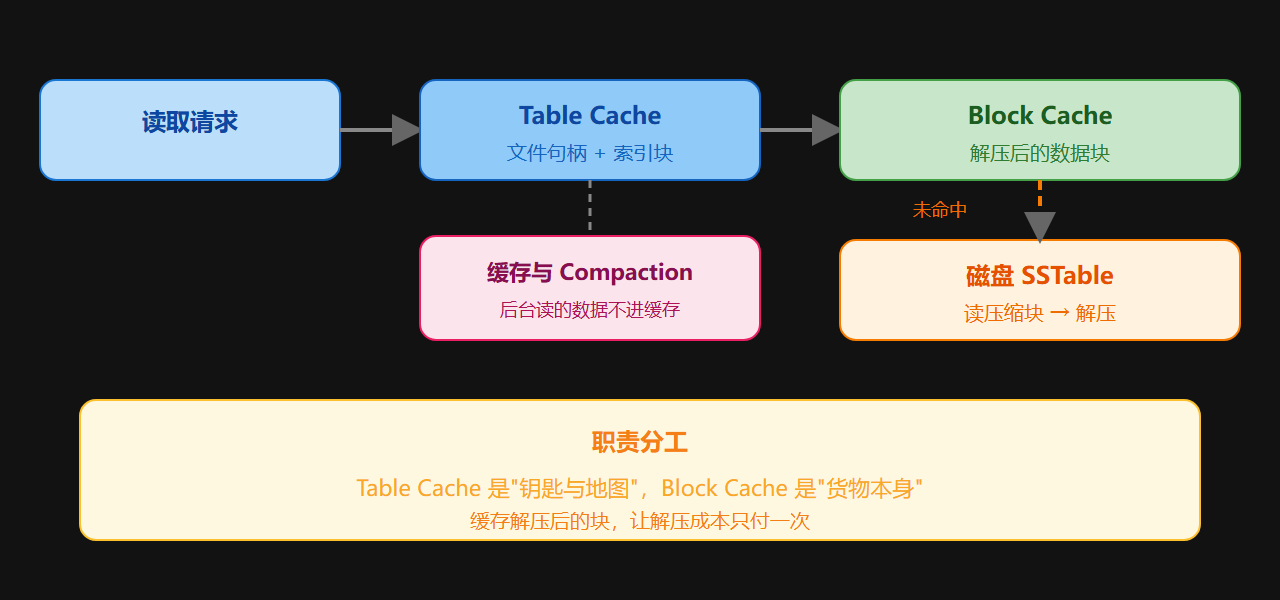
Table Cache(表缓存):缓存已打开 SSTable 文件的文件句柄及其索引块。相当于"文件目录管理器"。文件句柄避免重复打开文件(系统调用很贵),索引块避免重复读取解析索引。
Block Cache(块缓存):缓存从 SSTable 读取并解压后的数据块。相当于"内容加速层"。直接缓存解压后的数据,最彻底地避免磁盘 I/O 与解压开销。
为什么分开?因为两者访问特征不同:文件句柄和索引块体积小、缺失代价高(要重新打开文件);数据块体积大、访问频率高。分开管理就能用不同策略:钥匙几乎常驻(只要文件没删),货物按热度淘汰(LRU)。
Table Cache:元数据之门卫
Table Cache 的键是文件号,值是包含 RandomAccessFile 指针和 Table 对象(内部持有索引块)的封装。访问某文件时先查缓存:命中直接拿句柄和索引;未命中则打开文件、读 Footer、解析索引,再插入缓存。
缓存淘汰也遵循 LRU,但有一个关键联动:SSTable 被 Compaction 删除时,对应缓存项必须失效,否则会访问到已删文件。这要求 Table Cache 与版本系统紧密协作。
Block Cache:内容的高速公路
Block Cache 是经典的 LRU 实现:一个双向链表维护访问顺序(最新在头部、最旧沉向尾部),一个哈希表按块标识(文件号 + 块偏移)快速定位节点。
读取数据块:命中则节点移到链表头部并返回;未命中则读磁盘压缩块、解压、插入头部;容量超限则从尾部淘汰。LRU 抓住了"时间局部性"——最近访问的数据短期内再访问概率更高。
并发与内存细节
多线程环境下,LRU 缓存用分片锁(Sharding)减少争用:哈希表分成多个片段,各持一锁,访问不同键并行,同片段才竞争。每个条目除数据外还存键、哈希值、引用计数、链表指针,计算容量时把元数据也算进去,让配置的缓存大小更贴近真实内存。引用计数保证正在被使用的块不会被意外淘汰。
三、工程实践要点
参数与缓存表现
| 参数 | 控制的缓存 | 调大收益 | 代价 |
|---|---|---|---|
| Options.block_cache | Block Cache | 热数据命中率升 | 内存占用升 |
| Options.max_open_files | Table Cache | 减少文件开关 | 文件描述符占用 |
建议:热点访问负载(80% 请求集中在 20% 键)给 Block Cache 配大内存(系统内存 10%-30%),读性能接近内存数据库;均匀随机读或全表扫描场景,大缓存收益有限。
缓存与 Compaction 的互动
一个容易忽略的设计:Compaction 读取的数据通常不放入 Block Cache。原因很实际:Compaction 是后台任务,访问模式是顺序的、一次性的,塞进面向随机读优化的 LRU 缓存,会迅速淘汰真正有价值的热点数据,造成"缓存污染"。这个取舍保证了前台业务查询的缓存有效性不受后台维护任务影响。
⚠️ 常见坑:以为缓存越大越好。对全表扫描类负载,大缓存不仅收益有限,还可能因淘汰开销带来额外成本。先搞清楚业务是热点访问还是均匀随机读,再决定缓存预算。
💡 关键直觉:把两级缓存想成图书馆的两个环节。Table Cache 是"常开着的阅览室门牌记录"——不用每次都去行政处办借阅卡(打开文件);Block Cache 是"摊在桌面上的常用书页"——连书架都不用跑(读磁盘)。前者省"办手续",后者省"跑腿"。
SOURCE 独有事实
LevelDB 的缓存实现有一个值得注意的细节:缓存的是解压后的数据块。这意味着昂贵的解压操作只在第一次缓存未命中时发生一次,之后所有对该块的读取都直接享受内存速度。这个设计放大了压缩带来的空间节省,同时用缓存规避了压缩的主要性能代价(解压 CPU 开销)。另外,LevelDB 原生没有复杂的预读策略,数据读取是"按需"的,依靠 OS 页缓存辅助顺序扫描。
四、深入展开:缓存机制的系统级设计
图:两级缓存的分工与路径
"缓存解压后的块"是深思熟虑而非疏忽
有人会问:缓存解压后的块不是更占内存吗?为什么不缓存压缩块,等要用时再解压?答案在访问模式里:热数据会被反复读取,每次都解压等于反复付 CPU 代价;缓存解压后的块,CPU 代价只在首次未命中时付一次,之后的读取全是内存速度。
这里有一个"一次付清 vs 分期付款"的权衡:缓存压缩块内存省但每次读都解压(CPU 反复花),缓存解压块内存多花但 CPU 只花一次。对读密集负载,后者明显更优——因为内存可以扩容,而 CPU 解压会直接加到延迟上。理解了这一点,你就明白为什么 LevelDB 宁可多占内存也要缓存解压块:它把"高频的 CPU 开销"转换成了"一次性的内存开销"。
缓存与 Compaction 的微妙平衡
Compaction 读的数据不进 Block Cache,这个设计容易被人忽略,但它的意义重大。想想看:Compaction 是后台任务,会读取大量文件做归并——如果这些数据全塞进缓存,LRU 会迅速把它们"顶"到链表头部,把真正高频访问的热点数据挤出去。这就是"缓存污染"。
正确的做法是让 Compaction 的数据"路过缓存而不驻留":它用顺序读的方式一次性消费,用完整盘 I/O 就行,不需要缓存帮忙。这样前台业务查询的缓存命中率不受后台任务干扰。这个设计体现的工程智慧是:缓存资源要留给"重复访问"的数据,一次性消费的数据不配占缓存。判断一个数据该不该进缓存,标准就是"它会被访问几次"。
缓存大小的配置不是越大越好
"缓存越大越好"是直觉,但工程上不对。缓存大小超过一定阈值后,收益递减:热点数据早已命中,再大的缓存只是放着不用的闲置内存。而且缓存占用内存会挤压 MemTable 的空间(两者共享进程内存),可能导致写路径变慢。
正确的做法是:先监控缓存命中率,命中率已到 95% 以上,再加缓存收益很小;命中率低于 80%,说明缓存太小或访问模式太分散。配置缓存大小的依据是"命中率曲线的拐点",而不是"内存还够就多给"。这是"按需分配"原则在缓存上的应用——资源永远优先给边际收益最大的地方。
常见问题
问:Table Cache 和 Block Cache 哪个更重要? 没有固定答案,取决于数据模式。文件多而热:Table Cache 价值大(省文件开关);块重复访问多:Block Cache 价值大(省磁盘读)。两者是互补关系,评估时看各自的命中率。
问:缓存一致性怎么保证?文件被 Compaction 删了怎么办? Table Cache 与版本系统联动:文件被标记删除时,对应缓存项被失效或驱逐,防止读到已删文件。这是"缓存与系统状态管理的一致性要求"的典型实例。
问:LevelDB 缓存是线程安全的吗? 是,通过分片锁实现——哈希表分片,各持一锁,访问不同键可并行,同片竞争。这让高并发读场景下的缓存访问不会成为瓶颈。
缓存机制在全书中的位置
回顾全书会发现一个有趣的现象:缓存的"LRU + 分片 + 引用计数"这套实现,和跳表的"概率 + 原子指针"、版本的"日志 + 指针切换"一样,都是在用"简单可靠的机制"替代"复杂的全局锁"。LevelDB 的设计者在每个并发场景都选择了同样的策略:尽量把共享状态切小、把锁的范围缩小、用不可变和原子操作替代阻塞。
这个一致性很值得学习。它不是各组件偶然的相似,而是统一的工程价值观的体现。当你读源码时,你会不断看到这种"熟悉的模式"反复出现——识别出模式,你就能用第一性原理解释每个组件的设计,而不是孤立地记零件。缓存机制正是理解这个价值观的一个绝佳入口:它把"空间换时间"、"按需分配"、"污染隔离"三个原则浓缩在了一个组件里。
一个实用的缓存观察方法
想验证缓存是否配置合理,最简单的观察是:对比"冷启动"与"热运行"的点查延迟。冷启动(刚打开数据库)延迟高,因为缓存是空的;热运行(跑了一阵)延迟低,因为热数据进了缓存。两者差距越大,说明缓存价值越大;差距很小,说明访问模式太分散,加缓存也白搭。
这个"冷热对比"可以量化缓存的价值,也帮你决定该不该给缓存加内存。结合第 6.3 节的命中率监控,你就有了完整的"缓存体检"方法——先看命中率曲线,再决定是否调整容量,最后用冷热延迟对比验证效果。这是一套不需要源码也能做的工程实践,但它依赖你对缓存机制原理的理解。
核心回顾
- 要点一:Table Cache 缓存文件句柄与索引块,Block Cache 缓存解压后的数据块。
- 要点二:分层源于"钥匙"与"货物"访问特征差异,可差异化管理生命周期。
- 要点三:Block Cache 用双向链表 + 哈希表实现 LRU,分片锁支持高并发。
- 要点四:缓存容量计算把条目元数据也算入,配置更贴近真实内存。
- 要点五:Compaction 读的数据不进 Block Cache,避免污染热点缓存。
- 要点六:缓存解压后数据块,让解压成本只付一次。
缓存让热数据不出内存,但磁盘上的文件还是越来越大。下一节看压缩算法如何从源头减少存储与 I/O。