4.2 布隆过滤器:用误判换 I/O
4.2 布隆过滤器:用误判换 I/O
本节摘要:布隆过滤器是一种概率型数据结构,能确定地回答"键绝对不存在",也能含糊地回答"键可能存在"。LevelDB 给每个 SSTable 配一个,专门拦截"键不存在"的查询,避免大量无谓磁盘 I/O。本节讲透它的原理(位数组 + 哈希函数)、误判率公式、在 SSTable 中的集成方式,以及为什么说它是"以概率换确定性 I/O"的典范。
本节地图
阅读完本节,你应当能够:
- 解释布隆过滤器的插入与查询过程
- 推导误判率公式 p ≈ (1 - e^(-kn/m))^k,并说明三个参数的影响
- 说清布隆过滤器在 SSTable 中如何集成(Filter Block)
- 解释"无假阴性"对数据库正确性的意义
一、问题与直觉
先看读路径的现实:一个查询键到达,系统要查好多 SSTable 文件。如果目标键根本不存在(这在很多场景很常见),最坏情况要翻遍所有文件才确定"没有"。这无疑是一场性能灾难——大量磁盘 I/O 换来的结论只是一个"不存在"。
我们真正需要的是一个"摘要"或"指纹",能低成本地先回答:这个键绝对不在这个文件里吗? 如果答案是肯定的,就直接跳过该文件,不用做任何 I/O。
布隆过滤器就是为这个问题而生的工具。它用"可以接受小概率误判"换取了"空间极小 + 查询极快 + 绝不漏报"。
二、核心原理
位数组 + 哈希函数
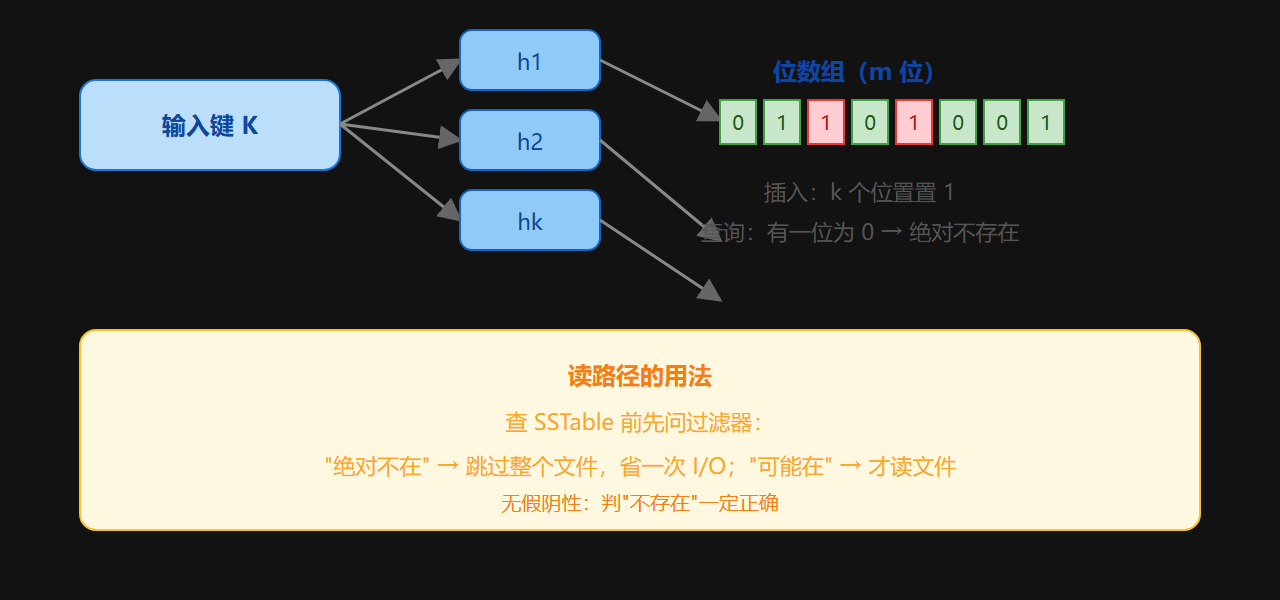
布隆过滤器由长度为 m 的位数组和 k 个独立的哈希函数构成:
插入键 x:用 k 个哈希函数算出 k 个位置,把位数组上这 k 个位置全置 1。
查询键 y:算 k 个位置,检查是否全为 1:
- 有任何一个位为 0 → "绝对不存在"(铁证,因为插入时必然全置 1)
- 全部为 1 → "可能存在"(可能是其他键的哈希碰撞覆盖了这些位)
误判率公式
假阳性概率 p ≈ (1 - e^(-kn/m))^k。其中 n 是已插入元素数,m 是位数组大小,k 是哈希函数数。工程结论:
- 增大 m → 降误判率,但增空间
- 增大 k → 初期更精细,但 k 过大位数组被填满反而升冲突,存在最优 k ≈ (m/n)·ln2
- n 增加 → p 上升
一个常用经验值:每键 10 比特时,假阳性率可低于 1%。
为什么"无假阴性"是关键
布隆过滤器只可能假阳性(误判存在),绝不可能假阴性(漏判存在)。这个单边性对数据库至关重要:假阴性意味着"键存在却说不存在",等于丢数据,不可接受;假阳性只是多读一次文件,浪费一次 I/O,正确性丝毫无损。这个不对称性正是它能上生产的原因。
在 SSTable 中的集成
LevelDB 把布隆过滤器作为每个 SSTable 的附属元数据,构建时同步生成,存为 Filter Block 追加在文件末尾。实现上是"每数据块一段过滤器"而非整文件一个——这样只需加载目标数据块对应的那一段,内存更省、过滤更精准。
读路径中的协作:
- 查询键 K,先问该文件对应的布隆过滤器(常驻内存)
- 返回"绝对不存在" → 跳过文件,I/O 终止
- 返回"可能存在" → 读索引、定位数据块、加载查询
三、工程实践要点
参数权衡
| 每键比特数 | 误判率量级 | 内存开销 | 建议场景 |
|---|---|---|---|
| 6-8 | 几个百分点 | 低 | 内存紧张 |
| 10 | 约 1% | 中 | 默认均衡 |
| 15-20 | 远低于 1% | 较高 | 点查密集、键不存在多 |
适用边界
布隆过滤器只对点查有效,范围扫描是顺序遍历,过滤器帮不上忙。对于纯顺序扫描或批量加载场景,关闭过滤器(bits_per_key=0)可能是更经济的选择。
⚠️ 常见坑:给布隆过滤器配了很高精度,却发现业务全是范围扫描,内存白花了。反过来,点查密集的键不存在场景,舍不得给 bits_per_key 又会平白多吃很多磁盘 I/O。先看业务查询模式再定参数。
💡 关键直觉:把布隆过滤器想成机场安检的"预检名单"。名单只能确定地说"这人在不在嫌疑人名单上"(不存在则放行),但不能确定"是不是无辜群众碰巧撞名"(存在需复核)。绝大多数无辜者被预检直接放行(键不存在被跳过),只有少数撞名的要排队复核(误判多读一次)。
SOURCE 独有事实
LevelDB 的布隆过滤器通过抽象的 FilterPolicy 接口定义行为,默认实现 BloomFilterPolicy 允许用户在创建数据库时指定 bits_per_key 参数。在实现中,多个哈希函数通常由一个种子哈希配合不同算法模拟出来。另外,过滤器块本身也是可缓存的单元,与数据块的定位方式协同工作——先通过索引定位可能的数据块,再加载并查询该块对应的那一段过滤器。
四、深入展开:把布隆过滤器用对
图:位数组与哈希函数的协作
"每数据块一段"的过滤器设计,妙在哪
LevelDB 的布隆过滤器不是"每个文件一个大过滤器",而是按数据块分段——每个数据块对应一小段过滤器位数组。这个设计的精妙在于内存与命中的双赢:
- 内存更省:查询时只需加载目标数据块对应的那一段过滤器,而不是整个文件的过滤器
- 过滤更准:每个小过滤器只覆盖一个块内的有限键,局部误判率更低,整体过滤效果更好
- 与索引协同:先用索引定位数据块,再加载该块的过滤器段,顺序天然契合
它把"过滤"从文件级细化到了块级,让"守卫"更精准。这也解释了为什么说 LevelDB 的布隆过滤器是"系统级优化组件"——它不是挂在外面的工具,而是深度嵌入文件格式与查询流程的零件。
误判率公式的工程直觉
公式 p ≈ (1 - e^(-kn/m))^k 看起来唬人,但工程上只需要记住三个趋势:m 越大(位数组越大)误判越低,n 越大(元素越多)误判越高,k 存在最优值。最优 k 约为 (m/n)·ln2,即"每个键的比特数 × 0.69"。经验上每键 10 比特时误判率约 1%,这是很多系统的默认平衡点。
当你想要更低误判(比如点查极密集、键不存在比例高),就加 bits_per_key;当你内存紧张,就降。值得注意的是:误判率是"随着插入量增长而恶化"的——所以估算 m 时要用"预期的最大数据量",而不是当前数据量。这个"按峰值设计"的原则,是配置过滤器最容易踩的坑。
一个冷门但重要的点:过滤器对"空查询"的威力
很多人评估布隆过滤器时只想到"加速命中查询",忽略了对"键不存在"查询的拦截价值。在真实系统里,"探活型查询"(查一个很可能不存在的键)占比往往很高——比如判断用户是否订阅过、设备是否已注册。这类查询如果没有过滤器,最坏要翻遍所有 SSTable 才确认"没有";有了过滤器,几乎全部在内存里就被拦截。
这让布隆过滤器成为"点查成本模型"的隐藏变量:一个业务若大量查询不存在的键,LevelDB 的实际读性能会比"按文件数估算"乐观得多。选型评估时把这一点算进去,结论可能完全不同(第 1.4 节提到过这个加分项,这里展开原理)。
常见问题
问:布隆过滤器能删除键吗? 标准布隆过滤器不能删除——因为位数组里的 1 可能是多个键共享的,清除一个键的位可能误伤其他键。有可删除的变体(计数布隆过滤器),但 LevelDB 用不到:过滤器与不可变的 SSTable 绑定,文件建成后键集合固定,无需删除。
问:为什么 LevelDB 不把过滤器做成全局的? 局部化是"分治与局部性优化"思想的体现:每个文件的过滤器只服务本文件的查询,避免全局结构带来的同步与放大问题。这也是为什么它作为元数据附加在每个 SSTable 上,而不是独立维护一份全局索引。
问:过滤器会显著增加文件大小吗? 会,但可控。每键 10 比特意味着 1 亿个键的过滤器约 125MB 空间,对绝大多数场景可接受。它换来的是点查时避免大量磁盘 I/O——这笔交易通常非常划算。
布隆过滤器的适用边界
任何工具都有边界,布隆过滤器也不例外。它的"存在性判断"能力只适用于点查(按键精确判断);对范围查询(Iterator 扫描一段区间),过滤器完全无用——扫描本来就要顺序读,不存在"这个范围在不在文件里"的单一判断。
还有一类场景要主动关闭过滤器:当数据本身已经是"全扫描型"负载,或者键的重复率极低、误判造成的额外 I/O 已经很少时,过滤器的内存开销就不值了。工程上"不是每个优化都要开",关掉不适用的优化,把内存留给更需要的缓存,往往更聪明。判断标准依然是那句话:先看业务查询模式,再决定工具用不用、用多狠。
把布隆过滤器的思维带走
布隆过滤器教给我们的通用思维是:面对高代价的确定性操作(如磁盘 I/O),可以先用低代价的概率判断做预筛选——用可以接受的"小概率多做一次"换取"大概率少做一次"。这个模式在系统设计里无处不在:路由表的模糊匹配、网络包的快速过滤、数据库的索引预判,本质都是同一类思想。
对存储引擎学习者来说,理解布隆过滤器不只是记住一个数据结构,而是理解"概率预筛选"这个通用武器。当你以后设计自己的系统,遇到"高代价操作前能不能先低成本排除大部分"的问题时,你自然会想到它——这就是把知识点变成思维方式的标志。
布隆过滤器与键设计的一个联动
布隆过滤器看似与键设计无关,实则存在微妙的联动:过滤器对"键不存在"的判断效率,与键的分布质量有关。如果键集中(比如都带同一前缀),哈希后的位置容易碰撞,误判率会高于均匀分布的预期;如果键均匀(比如带随机后缀),哈希分布更散,过滤器效果更好。
这带来一个实用的设计提示:当你既要"键有序"(利于 Compaction 与范围扫描)又要"布隆过滤器高效"时,可以在键里做"前缀有序 + 后缀随机"的组合——前缀保证顺序性,后缀引入多样性。这个组合是 LSM 系引擎键设计里的常见技巧,它说明"键设计"与"过滤器配置"不是两个独立话题,而是要在同一份键结构里一起权衡的。
一节小结
- 要点一:布隆过滤器用 k 个哈希 + 位数组,确定回答"不存在",含糊回答"可能存在"。
- 要点二:误判率 p ≈ (1 - e^(-kn/m))^k,受 m、n、k 三参数控制。
- 要点三:无假阴性是上生产的底线——假阴性等于丢数据,假阳性只浪费一次 I/O。
- 要点四:过滤器以 Filter Block 形式存于 SSTable 末尾,按数据块分段。
- 要点五:只对点查有效,范围扫描场景应关闭或降配。
- 要点六:bits_per_key 是控制误判率与内存开销的主要旋钮。
读路径有守门员了,但通过了守门员的查询还要真正读数据。下一节看两层缓存如何让"热"数据不出内存。