第 5 章 并发控制与一致性
第 5 章 · 并发控制与一致性
章节摘要:这一章回答 LevelDB 如何在高并发下保证数据正确性。核心设计是一句话:"写串行,读并行"——所有写入通过单写者模型序列化,读取靠快照与版本机制实现近乎无锁的并发。我们依次拆解原子性操作(WriteBatch 与日志先行)、快照机制(序列号定格时间)、并发模型(单写多读与后台线程),最后用一张对照表说明它的适用边界。
你能学到什么
阅读完本章,你应当能够:
- 解释"单写者 + 多版本快照"的并发模型与动机
- 说清 WriteBatch 如何保证一组操作的原子性
- 用序列号机制解释快照为什么能提供稳定视图
- 描述 LevelDB 如何用锁与原子指针协调读写与后台压缩
- 判断什么场景适合 LevelDB 的并发模型
核心概念速览
本章金句:LevelDB 不用复杂的锁管理器,而是把"时间"抽象成单调递增的序列号,用"数据不可变 + 版本切换"把并发问题变成了"读者看哪个版本"的问题——这是它最优雅也最容易被低估的设计。
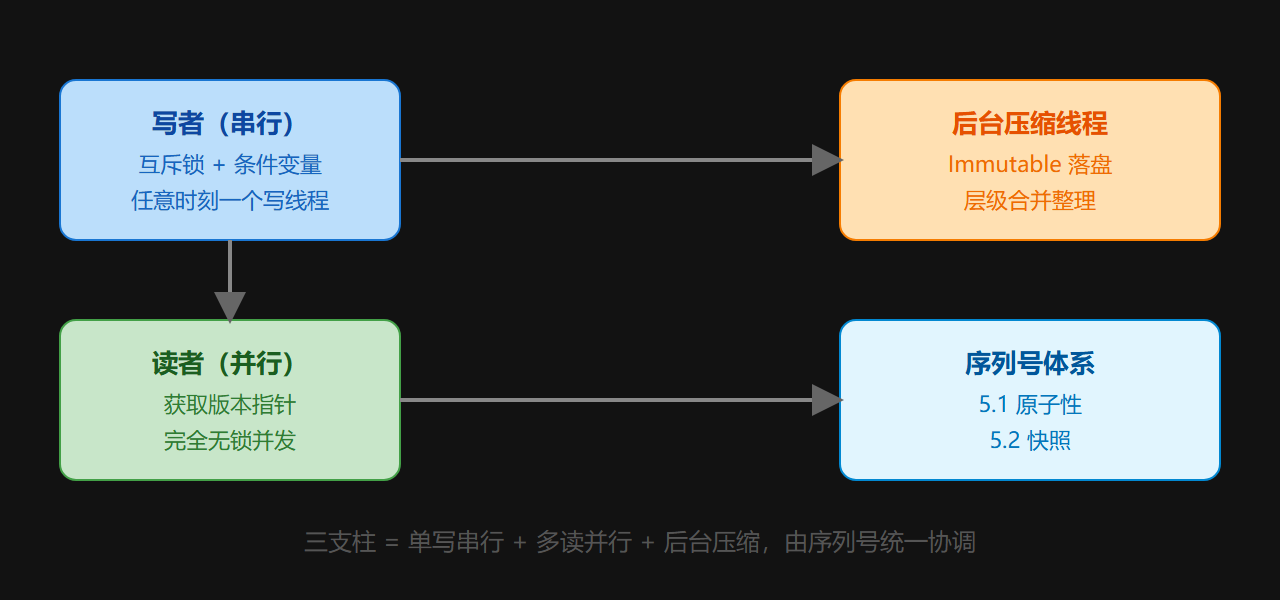
图:写串行、读并行、后台干活
子章节导航
5.1 原子性:WriteBatch 与日志先行
讲 WriteBatch 的编码格式、WAL 的持久化承诺、以及"整批写日志 + 共享序列号"如何实现原子性。附带讨论 WriteBatch 在性能上的副产品。
5.2 快照:以序列号定格时间
讲快照的 O(1) 创建、基于序列号的读取过滤、以及快照与 Compaction 的博弈——活跃快照会阻止旧版本被物理删除,这是空间放大的一个来源。
5.3 并发模型:单写多读与后台线程
讲 LevelDB 的三大支柱:单线程写、多线程读、单线程后台压缩。拆解互斥锁与条件变量如何序列化写入、原子指针如何让读者无锁并发、后台线程如何通过版本切换与前台协作。
子章节之间的逻辑关系
5.1 原子性(单个操作正确) │ 提供基础原语 ▼ 5.2 快照(读者视图稳定)── 依赖序列号 ──► 5.3 并发模型(整体协作)
5.1 保证"写下去是对的"(原子性),5.2 保证"读出来是一致的"(隔离性),5.3 把两者放进多线程的舞台,协调写者、读者与后台压缩三方的调度。三者的共同语言是序列号。
章节速览表
| 小节 | 主题 | 核心机制 |
|---|---|---|
| 5.1 原子性 | WriteBatch 与日志先行 | 整批写 WAL + 共享序列号 |
| 5.2 快照 | 以序列号定格时间 | 逻辑时间切片 + 版本保留 |
| 5.3 并发模型 | 单写多读 | 互斥锁序列化 + 原子指针无锁读 |
⚠️ 注意:本章最容易读晕,因为三个机制共用"序列号"这个隐藏支点——先把序列号想清楚,全章就通了。
💡 提示:读 5.3 前复习第 2.4 节的 Version 机制,并发模型就是建立在其上的。
为什么并发章节最容易读晕
并发控制的难点在于"抽象层次":原子性、隔离性、单写者、快照,这些概念互相纠缠,而且都建立在"序列号"这一个隐藏的支点上。如果你没抓住"序列号是全局逻辑时钟"这条线,就会觉得每个机制都是孤立的、需要分别记忆。抓不住主线,自然读得晕。
破解方法很简单:先把 5.2(快照)读明白——因为它最直接地展示了"序列号如何定义一致性"。一旦理解了"读取 = 锚定一个序列号 + 只看该号以前的记录",5.1 的原子性(批次共享序列号)和 5.3 的并发模型(序列号在单写者下严格递增)就都顺理成章了。序列号是解开本章所有谜团的钥匙。
本章使用建议
本章建议"慢读":并发正确性是最容易出理解偏差的部分,不值得为赶进度跳过推理。每读完一节,试着用自己的话复述"这个机制保证什么、代价是什么"。尤其注意 5.2 节快照与 Compaction 的博弈——它是理解"删除后空间回收延迟"的关键,也是面试高频考点。读 5.3 时,对照第 2.4 节的 Version 机制,你会看到它们如何合体。
本章在全书的位置
第 5 章是"正确性"章:它回答"并发下数据凭什么不错"。前面的章节关注"性能怎么来",本章关注"正确性怎么保",两者在 LevelDB 里高度统一——正是因为它把并发模型设计得简单(单写者 + 快照),才既保证了正确性,又留出了性能空间。第 6 章调优时理解的"写停顿",其机制根源就在本章的并发模型里;第 7 章对比 RocksDB 时,单写者也是核心参照系。
本章自测
读完本章后,试着回答以下问题:
- WriteBatch 的原子性边界在哪里?它为什么不覆盖"读-改-写"?
- WAL 记录里的校验和有什么作用?没有它崩溃恢复会怎样?
- 快照创建为什么是 O(1)?它凭什么能"冻结"一个视图?
- 活跃快照为什么会阻止旧版本被 Compaction 清理?
- 读者的"无锁"依赖哪两个前提?它们如何保证读者拿到的视图一致?
- 单写者模型为什么反而被多数场景接受?它简化了什么?
如果第 4 或第 5 题需要翻书,建议重读 5.2 和 5.3 节。并发一致性是面试高频区,也是实际系统最容易出隐性 bug 的领域——本章的"慢读"投入是值得的。
本章的一句话坐标
用一句话概括本章的设计哲学:"写串行、读并行、后台干活、时间仲裁。" 写串行指单写者模型(简单正确),读并行指版本不可变下的无锁读(高效),后台干活指压缩线程异步整理(不阻塞前台),时间仲裁指用序列号定义一致性与快照(统一正确性机制)。这十六个字浓缩了 LevelDB 并发模型的全部骨架,也是你评估任何 LSM 系引擎并发设计时的参照坐标。
前置知识与后续延伸
- 前置知识:第 2.4 节的 Version/VersionSet 是本节的底层设施;第 3.2 节的序列号是快照的基石;第 4.1 节的跳表无锁读是并发模型的支撑。
- 后续延伸:第 6 章的调优中,理解写停顿(stall)需要用到本节并发模型;第 7 章的 RocksDB 对比会以 LevelDB 的单写者为参照系。