第 6 章 性能调优与最佳实践
第 6 章 · 性能调优与最佳实践
章节摘要:这一章把前面所有的原理兑现成可操作的调优手段,分三条线:参数配置(write_buffer_size、max_open_files、block_size 等关键旋钮)、键值设计(顺序性是写性能的圣杯、大值怎么办)、性能监控(停顿、读写放大、缓存命中率怎么看)。读完你就有了一套"监控洞察 -> 设计干预 -> 配置调控"的闭环方法,而不是拿着参数表瞎试。
上手前先明确
阅读完本章,你应当能够:
- 说出五个核心参数的作用、权衡与调整方向
- 解释键顺序性为什么直接决定 Compaction 的局部性
- 给出大 Value 的三种处理策略及适用场景
- 用写停顿、L0 文件数、读写放大、缓存命中率诊断性能问题
- 执行一次"建基线 -> 调参 -> 复测"的完整调优循环
核心概念速览
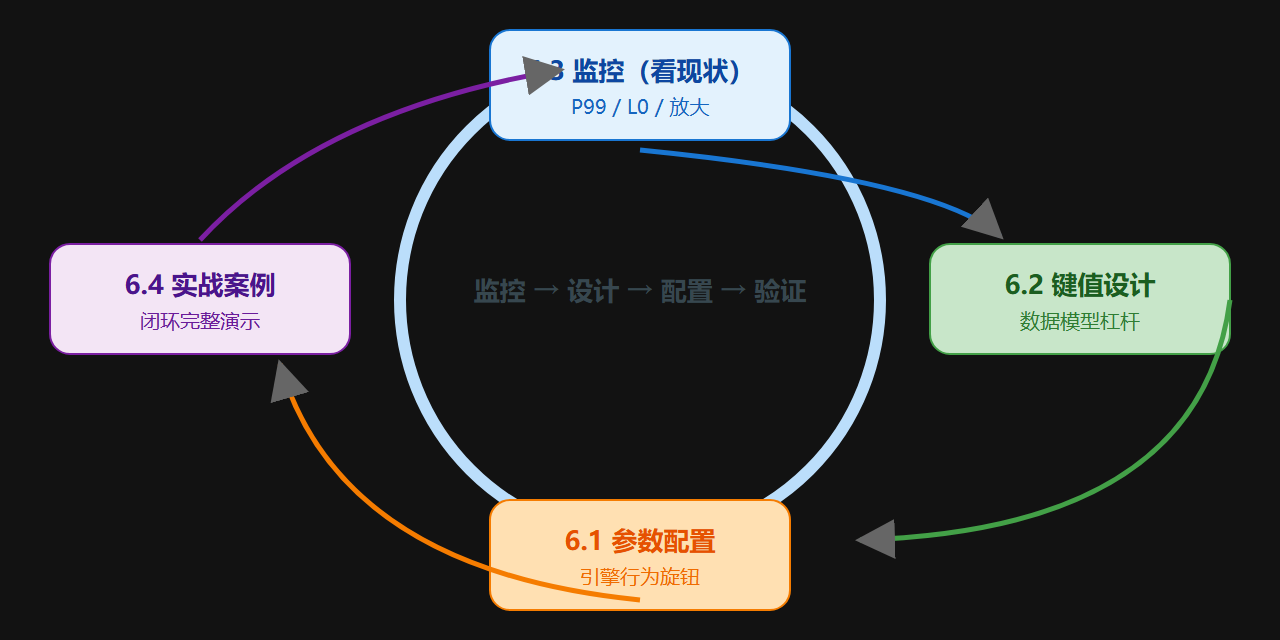
本章金句:调优不是背参数,是"先看监控找到痛点,再从键设计和参数两个维度动手,最后用数据验证"——一个由监控、设计、配置驱动的闭环飞轮。
图:调优闭环飞轮
子章节导航
6.1 参数配置:write_buffer_size 等关键旋钮
拆解 write_buffer_size(内存与吞吐的杠杆)、max_open_files(句柄与稳态性能)、block_size(I/O 对齐智慧),以及"建基线、理解负载、监控瓶颈、关联调整、迭代验证"的五步调优方法论。
6.2 键值设计:顺序性是大写性能的圣杯
讲键的顺序性如何决定写放大与 Compaction 局部性、大 Value 的三种处理策略(指针化/碎片化/压缩)、以及组合键与前缀设计对范围查询的塑造。
6.3 监控指标:从停顿到读写放大
讲三组核心指标:Compaction 延迟与节奏、读写放大倍数、资源利用率与队列深度,以及如何做关联分析、建基线与趋势、设置分层告警。
6.4 实战调优:一个写密集场景的完整案例
把本章三条线串起来:一个日志型负载从监控定位写停顿 -> 键值设计改造 -> 参数调整 -> 复测验证的完整过程,给出可照搬的决策顺序。
章节速览表
| 小节 | 维度 | 核心价值 |
|---|---|---|
| 6.1 参数配置 | 引擎行为 | 关键旋钮的原理与权衡 |
| 6.2 键值设计 | 数据模型 | 顺序性是写性能的第一杠杆 |
| 6.3 监控指标 | 观测 | 从停顿到读写放大的诊断语言 |
| 6.4 实战案例 | 方法 | 完整闭环的示范 |
⚠️ 注意:调优的杠杆顺序是"先改键、再调参"——顺序颠倒会让问题反复复发。
💡 提示:读 6.4 前先看 6.3 的监控指标,因为案例的每一步都靠监控数据驱动。
子章节之间的逻辑关系
6.1 参数(旋钮) ──┐ ├──► 6.3 监控(眼睛)── 反馈 ──┐ 6.2 键值设计(底盘)─┘ │ ▲ │ └──────────── 6.4 实战(闭环演示)─────────┘
6.1 和 6.2 是两个干预维度(引擎行为 vs 数据模型),6.3 是观察维度,6.4 把三者合成一次完整闭环,展示"数据驱动"的调优流程。
为什么调优是"闭环"而不是"调参"
很多人把调优理解成"找到一组最佳参数填进去",这是危险的误解。参数的最佳值随负载、硬件、数据模型变化,昨天的"最佳"明天可能就失效。正确的调优是"闭环":监控(观察现状)→ 分析(定位痛点)→ 干预(改键值或参数)→ 验证(复测对比)→ 回到监控。每一次循环都在当前事实上前进一步,而不是赌一套静态配置。
这个闭环的本质是"用数据说话":不靠感觉、不靠传闻,靠基准测试和监控指标判断每一步。理解了这个方法论,你就不会再把调优当成"抄答案"——每个参数、每次改动,都是一次有假设、有验证的实验。
本章使用建议
本章前三节(6.1-6.3)是"知识",6.4 是"方法"的完整演示。建议先读 6.4 建立全局印象(调优到底长什么样),再回头细读 6.1-6.3 补细节。读 6.1 时对照第 3 章的三放大模型,你会看到每个参数都在挪动某个放大指标;读 6.2 时对照第 4 章的压缩与布隆过滤器,理解键设计如何影响它们;读 6.3 时把这些指标串成"结果→原因"的排查链。最后回到 6.4,用案例验证你的理解。
本章在全书的位置
第 6 章是"应用"章:前面五章建立原理,本章教你把原理变成性能。它既是前五章的"验收"(原理学得越好,调优越顺),也是第 7 章选型的"输入"(能调好的引擎才是好选择)。第 8 章源码阅读则让你看到"参数在代码里如何生效"。建议把本章当作"从原理到实践"的桥梁——读完它,你就不再只是"知道 LevelDB",而是"会用 LevelDB"。
本章自测
读完本章后,试着回答以下问题:
- write_buffer_size 调大会带来哪三个连锁后果?哪一个是隐患?
- 为什么"先改键再调参"的顺序不可颠倒?
- 随机 UUID 键为什么会导致 Compaction 爆炸?标准解法是什么?
- 写放大的度量公式是什么?读放大点查的最坏公式是什么?
- 为什么看延迟要看 P99 而不是平均值?
- 调优前为什么必须先建基线和明确目标?
如果第 2 或第 4 题答不上来,建议重读 6.4 和 6.3 节。调优的能力不在于"记住参数",而在于"能用数据诊断、用结构解决问题、用复测验证"——本章的实战案例(6.4)就是这套能力的完整演示,值得反复体会。
本章的一句话坐标
调优的完整闭环可以浓缩为"监控看现状、键值定结构、参数调行为、复测验效果"。监控告诉你问题在哪,键值设计从根上优化(杠杆最大),参数配置在引擎层微调,复测用数据确认每一步。四个环节循环往复,就是"数据驱动调优"的全部。抓住这个闭环,你就不会再陷入"乱试参数"的泥潭。
前置知识与后续延伸
- 前置知识:第 3 章的三放大模型和第 3.3 节 Compaction 是本节的物理基础;第 4 章的缓存与布隆过滤器参数也是调优对象。
- 后续延伸:第 7 章选型对比中,RocksDB 的多线程压缩与更细参数正是为了缓解 LevelDB 单后台线程的瓶颈;第 8 章源码中能看参数如何生效。