3.2 K-quants 与重要性矩阵:量化兵器谱
3.2 K-quants 与重要性矩阵:量化兵器谱
本节摘要:上一节的块量化是通用骨架,llama.cpp 在其上造了两代兵器:K 系量化用超块结构与「按层分配精度」把 4 比特档位的质量推向实用;重要性矩阵路线则让校准数据说话,把 2 到 3 比特的极端压缩变成可选项。本节讲清两代兵器的机制与适用边界,让你面对文件名里的 K、I、S、M 后缀时能精确决策。
承上启下:从均匀到分级
3.1 节的块量化有个隐含假设:一个张量里所有权重同等重要。2023 年的实践很快推翻了这个假设——注意力层的投影矩阵与前馈层的降维矩阵对量化远比其他张量敏感,把它们与其余张量一视同仁,整体质量就会被短板拖垮。K 系量化的全部设计围绕一个念头展开:位宽预算是稀缺资源,要按重要性分配。
一、K 系量化:超块与按层分级
K 系的第一步创新在块结构。它把 3.1 节的 32 权重小块向上打包:若干个小块组成一个超块,超块内共享一个高精度的总缩放因子,每个小块再各自带低精度的子缩放因子。以 Q4_K 为例:超块含 256 个权重(8 个小块),子缩放因子用 6 位整数,超块因子用 16 位浮点。两级缩放的好处是等效位宽只涨到约 4.5 比特,但对分布变化的适应能力大幅增强——小块刻度粗了不要紧,超块因子负责大尺度校准。
图 3-1 超块两级缩放结构与按层精度分配
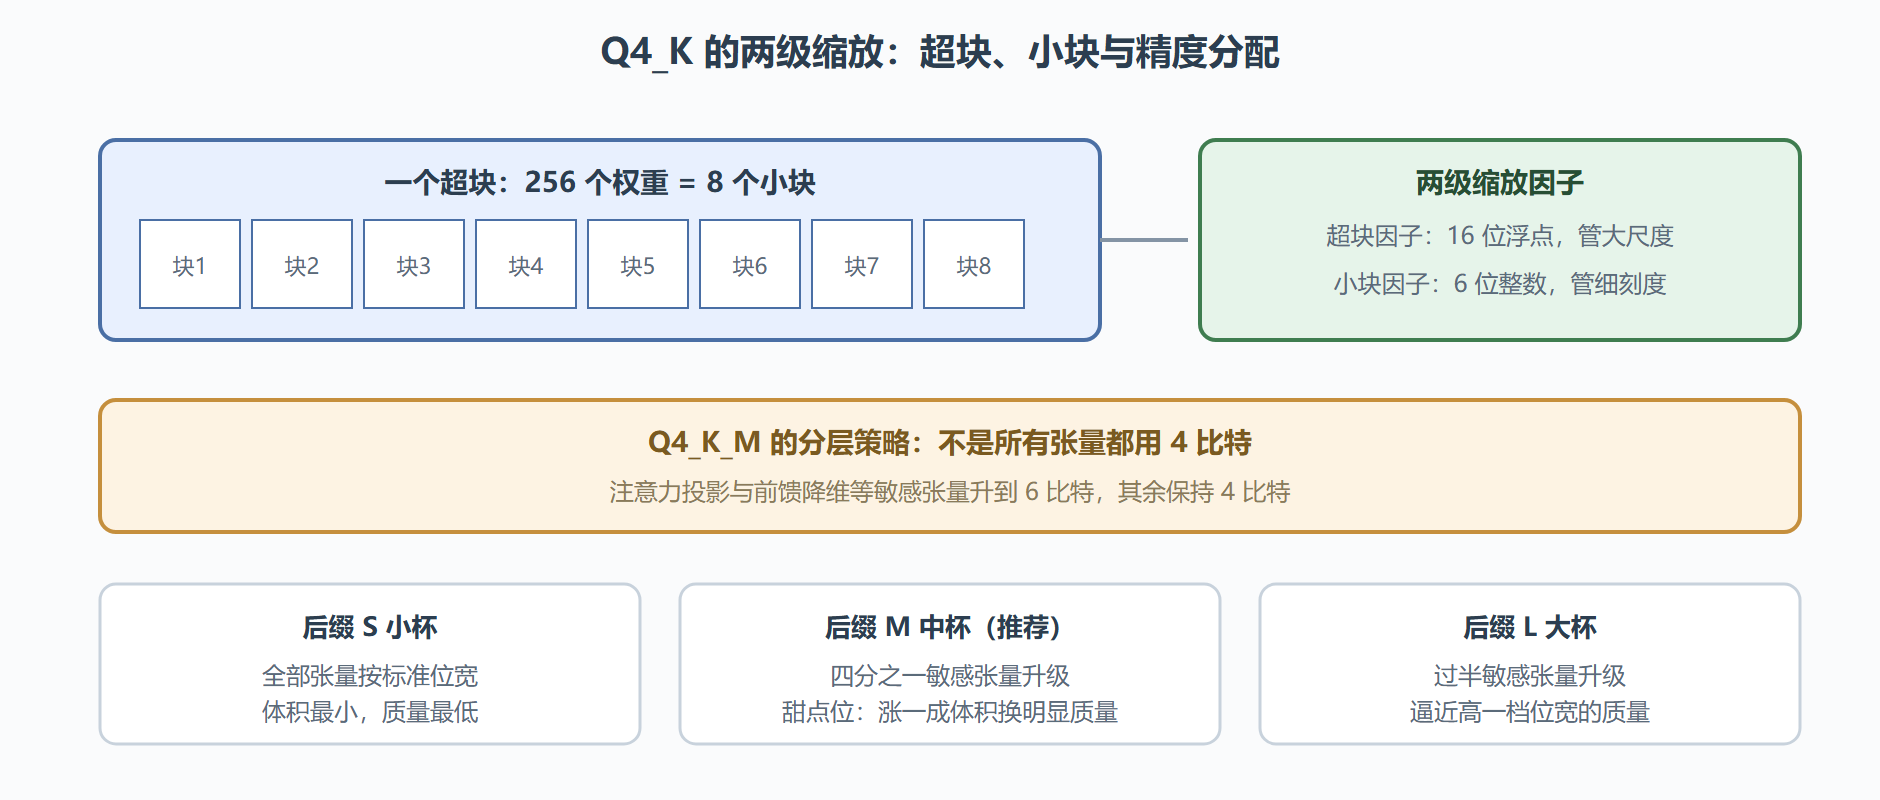
第二步创新是按层分配精度,文件名后缀 M、S、L 的由来。以 Q4_K_M 为例:注意力层的投影张量与前馈层的降维张量——这两类对量化最敏感——按比例升到 6 比特,其余张量维持 4 比特。结果是体积只比纯 4 比特多约一成,困惑度却显著更接近 6 比特整档。这就是第 2 章文件名解剖表里「q4_k_m 是甜点位」的机制注脚:甜点不是玄学,是精算过的资源分配。
二、重要性矩阵:让校准数据说话
K 系的精度分配靠的是对架构的经验认知(哪些层敏感是已知规律),而重要性矩阵路线把「谁重要」的判断交给数据。流程分两步:先拿一批有代表性的校准文本跑一遍模型,记录每个权重在真实推理中的贡献强度,形成重要性矩阵文件;再执行量化时把这个矩阵喂给量化工具,让误差预算向高重要性权重倾斜。
# 第一步:用校准文本生成重要性矩阵(拿几百 KB 与目标用途相近的文本即可) llama-imatrix -m 基线模型.gguf -f 校准语料.txt -o imatrix.dat # 第二步:带着重要性矩阵执行量化 llama-quantize --imatrix imatrix.dat 基线模型.gguf 输出-q4_k_m.gguf Q4_K_M
重要性矩阵的价值在极端位宽上最明显:IQ 系列把位宽压到 2 到 3 比特,靠传统均匀刻度早已不可用,但配合重要性加权与非常数量化编码,能把小模型的质量维持在「笨但能用」的水平。3B 以下的小模型、想在 4GB 内存设备上硬塞 7B 模型的场景,都是它的主场。代价是量化耗时明显更长,且校准语料与目标用途的匹配度直接影响效果——拿代码仓库语料校准的模型去写散文,可能不如不用矩阵。
三、兵器谱的使用建议
把两代兵器放进同一张决策框架:4 比特及以上,选 K 系(Q4_K_M、Q5_K_M、Q6_K),它们是速度与质量的标准答案,重要性矩阵可有可无;3 比特及以下,选 I 系(IQ3_XXS、IQ2_XS 等),必须配重要性矩阵,否则质量崩塌;同一系列的 S、M、L 后缀按显存余量选,M 是默认起点。另一个实用规则:小模型(3B 以下)建议位宽整体上探一档——3.1 节说过小模型更扛不住量化,与其用 3B 的 IQ2 不如用 1.5B 的 Q4。
兵器谱速查对照
把本节出场过的格式放进一张表,选型时按图索骥:
| 格式名 | 家族 | 等效位宽 | 适用判断 |
|---|---|---|---|
| Q4_0 / Q4_1 | 旧系 | 约 4.5 | 老工具兼容场景,新项目不推荐 |
| Q4_K_S | K 系小杯 | 约 4.5 | 极限压体积,接受可感知退化 |
| Q4_K_M | K 系中杯 | 约 4.5 到 4.8 | 默认甜点,大多数机器的主力 |
| Q5_K_M / Q6_K | K 系上探 | 约 5.5 / 6.6 | 显存富余时上探,质量显著更稳 |
| IQ3 / IQ2 系 | I 系 | 约 2 到 3.5 | 极限压缩,必须配重要性矩阵 |
| IQ4_XS | I 系 | 约 4.3 | 比 Q4_K_M 略小,质量接近 |
表里最值得停留的一行是 IQ4_XS 与 Q4_K_M 的对比:两者体积相差约一成,质量在多数任务上难分高下,选哪个更多取决于「有没有现成的带矩阵产物」而非原理优劣。不要为了零点几 GB 的差异反复横跳,量化的选择自由度远小于显存账本的约束力——这个大小关系的倒置,是量化选型的成熟标志。
低比特生存指南
如果你确实被逼到 3 比特以下(4GB 内存的旧设备、想塞 14B 模型的小显卡),按优先级执行四条:第一,务必用带重要性矩阵的 I 系产物,裸低比特是质量悬崖;第二,校准语料与目标用途对齐,代码助手用代码语料校准的产物;第三,模型规模宁可降一档,小模型配高位宽几乎总比大模型配低比特划算(3.1 节的规模-位宽互惠律);第四,把质量验收做实——固定一组验收题,量化产物上线前全对一遍。低比特不是不能用,是必须更精细地用。
快问快答
问:Q4_K_M 比 Q4_0 大一成,贵在哪?答:敏感张量升到 6 比特,用体积换质量,这是 M 杯的全部秘密。问:重要性矩阵没有会怎样?答:4 比特以上没大差别,3 比特以下质量断崖,I 系格式离开它基本不可用。问:量化产物能再量化一次吗?答:不能,量化是有损映射,二次量化等于对误差再做误差,正确路径是从 F16 基线重新转。
常见问题
M 杯的「敏感张量清单」是固定的吗?
不是。不同架构的敏感层分布不同,量化工具按架构内置了各自的分配方案。这就是为什么同是 Q4_K_M,不同模型家族的体积比与质量表现略有差异——「中杯」是策略名,不是统一配方。
重要性矩阵文件可以复用吗?
同一模型家族、相近规模、相同训练来源的产物有时可以借用,但质量收益会打折扣。正式使用请用与目标用途匹配的语料现场生成一次,生成成本不过几分钟,不值得省。
量化工具还能挑哪些细节?
进阶旋钮包括分层张量的逐层覆盖、输出层强制高精度等。它们的价值集中在极限位宽的精细调优上,4 比特及以上档位用默认参数已是充分优的解。
一个动手验证:亲眼看超块
超块结构不必停留在示意图——用第 2 章的头部分析工具把同一模型的 Q4_0 与 Q4_K_M 两份产物各转储一遍,对比同名张量的大小:Q4_K_M 的注意力投影张量会明显更大(6 比特升级的直接证据),而普通前馈张量两者相近。数据对上了本节的机制叙述,量化格式从「背下来的名词」变成「看得见的字节」。这个对比实验五分钟可做,是量化章与格式章之间最好的桥梁练习。
本节要点回顾
- K 系的两级缩放:超块浮点因子管大尺度、小块整数因子管细刻度,4.5 比特等效位宽换来更强的适应性;
- M、S、L 是精度分配方案:敏感张量升位宽,M 档「一成体积换显著质量」是甜点的机制本质;
- 重要性矩阵让校准数据主导误差分配,在 2 到 3 比特区间是必需品而非可选项;
- 选型口诀:4 比特以上用 K 系,3 比特以下用 I 系加矩阵,小模型位宽上探一档;
- 下一节把这套理论放上真机:五个档位全部实测,让数据验证上面的每一条论断。