3.3 五种位宽实测:体积、困惑度与速度对照
3.3 五种位宽实测:体积、困惑度与速度对照
本节摘要:理论讲完了,现在让数据说话。本节在 2060 小本上把 Qwen2.5-7B 的五个量化档位全部实测:体积、困惑度、预填充速度、生成速度四个维度逐项对照,最后给出这台机器的选档结论与可迁移的测量方法论。你以后换了硬件,照这套流程重跑一遍即可。
本实验在全书的位置
第 3 章前两节给了理论,本节做裁决。更重要的是,这张对照表是全书后续实验的基准:第 5 章显存账本的权重一栏、第 6 章上下文实验的速度基线,都以 Q4_K_M 档的实测值为参照。换句话说,这不是一次孤立的跑分,而是整本实验志的度量衡校准。
一、实验设计
对象:Qwen2.5-7B-Instruct 的五个档位(Q8_0、Q6_K、Q5_K_M、Q4_K_M、Q3_K_M)加上 F16 基线,共六份文件。硬件:i7-9750H 六核、双通道 DDR4-2666(理论带宽约 42GB 每秒)、RTX 2060 笔记本版 6GB(192-bit 位宽,带宽约 336GB 每秒)。工具:官方基准工具跑标准测试(128 token 提示词预填充加 128 token 生成),困惑度工具在维基文本样本上计算。公平性约定:每个档位测两组——纯 CPU 组与「显存装得下就全卸载、装不下就按比例分层」的混合组,温度固定、批次大小固定、每组测三轮取中位数。
二、数据
表 3-1 六档位实测对照(2060 小本,量级参考)
| 档位 | 文件体积 | 困惑度 | 纯CPU生成 每秒token | 混合/全卸载生成 | 卸载层数 |
|---|---|---|---|---|---|
| F16 | 14.9 GB | 6.82 | 3.9 | 4.1(仅 4 层入显存) | 4 / 28 |
| Q8_0 | 8.2 GB | 6.83 | 6.4 | 7.8(部分分层) | 10 / 28 |
| Q6_K | 6.6 GB | 6.86 | 7.7 | 9.6(部分分层) | 14 / 28 |
| Q5_K_M | 5.7 GB | 6.95 | 8.6 | 12.4(大部分分层) | 22 / 28 |
| Q4_K_M | 4.9 GB | 7.12 | 9.8 | 16.7(全卸载,2K 窗口) | 28 / 28 |
| Q3_K_M | 4.0 GB | 7.68 | 11.2 | 17.1(全卸载,4K 窗口) | 28 / 28 |
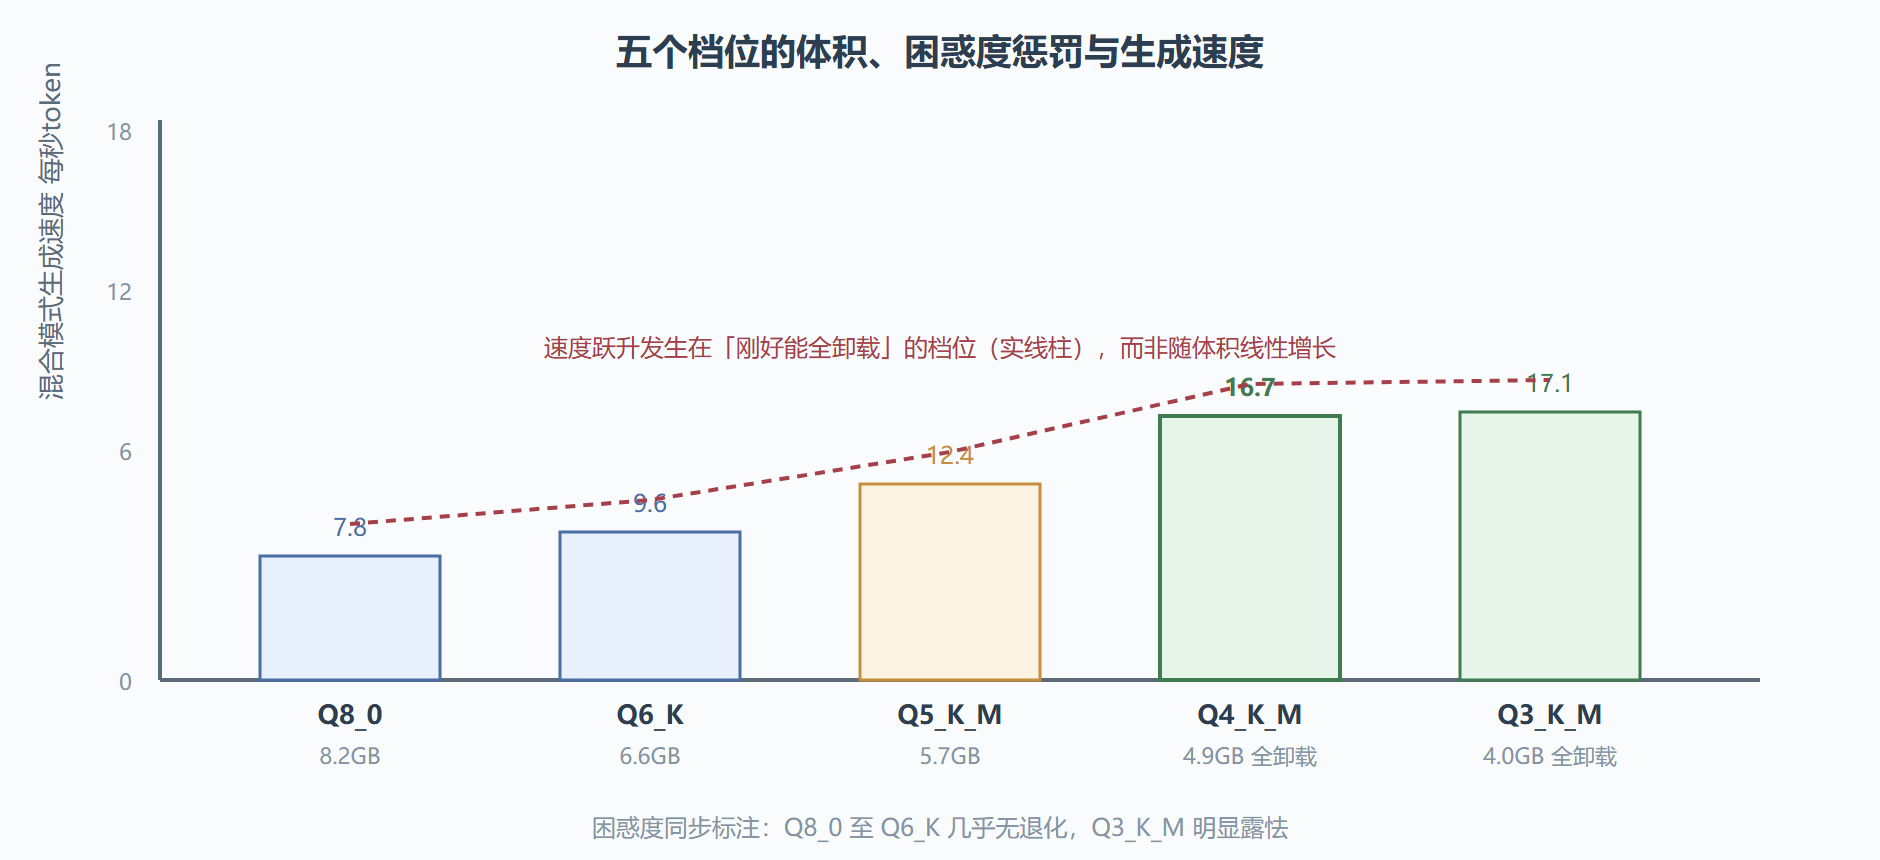
图 3-2 位宽三角:体积、质量、速度的此消彼长
三、解读:三条曲线三种性格
体积线性、质量分段。 体积随位宽严格线性下降,困惑度却是分段平缓的:Q8_0 与 F16 的差距在小数点后第二位,Q6_K 相比 Q8_0 只多 0.03,Q5_K_M 开始能被感知但仍在「日常使用无感」的范围,Q4_K_M 的 7.12 对闲聊与写作够用,Q3_K_M 的 7.68 在数学与长推理链上会明显露怯——实测里一道三步应用题,Q4_K_M 答对而 Q3_K_M 在第二步走岔。
速度的台阶效应。 这张表最反直觉的一行是速度:纯 CPU 组里 Q3 比 Q8 快不到一倍,混合组里 Q4_K_M 与 Q5_K_M 却差了三分之一。原因在「全卸载」门槛:Q5_K_M 差 0.7GB 装不进 6GB 显存,只能部分分层,每生成一个 token 都要跨越 PCIe 搬数据;Q4_K_M 刚好塞下,权重全程留在显存里,速度由显卡带宽主导。速度跃升发生在「刚好能全卸载」的临界档位,而不是最激进压缩的档位——这是选档时最容易踩的坑:看到 Q3 比 Q4 小就选 Q3,结果质量和窗口大小双输(本例中 Q3 只快 2%,却损失了 0.5 的困惑度)。
混合组的隐蔽成本。 部分分层的速度常常比纯 CPU 好不了多少,因为生成阶段的瓶颈从计算变成了跨总线搬运。如果你只能部分卸载,与其纠结层数,不如直接考虑更小的模型或更低的位宽——第 5 章的分层扫描实验会把这条曲线画得更细。
四、变式:换你的硬件重跑一遍
这套方法论可以直接迁移:固定模型与提示词、区分纯 CPU 与混合两组、每档三轮取中位数。两个硬件相关的修正点:显存更大的卡把「全卸载临界档」上移,可能 Q5 或 Q6_K 就能全卸载,结论会倒转;内存更小的机器要小心 F16 基线组——14.9GB 的权重加系统开销可能直接触发交换,那组数据会失真,可改用 0.5B 小模型建基线。
常见问题
为什么不测 IQ 系列位宽?
IQ 系的舞台在 2 到 3 比特的极限压缩,与本次「给主力机选档」的目标不重合。7B 模型在这台机器上不需要掉到 4 比特以下,上了 I 系反而损失速度。
困惑度低就一定好用吗?
不一定。困惑度是文本层面的统计量,对对话模板、指令遵循的敏感度有限。本节的位宽区间内它与主观体验相关性尚可,但跨模型比较时请以任务实测为准。
表里的数字能直接抄到别的机器吗?
不能。数字因硬件而异,但趋势与临界档效应是普适的。抄结论前先确认你的显存是否也在「Q4_K_M 刚好全卸载」的临界区附近——在临界区内,这张表的结论对你的参考价值最大。
测量方法论的两个细节
这套数据能被信任,靠的是两个容易被忽略的执行细节。其一:预热与轮次。首轮运行包含缓存冷启动与驱动预热,速度天然偏低,所以每组测三轮、取中位数、丢弃首轮——只测一轮的跑分有一成以上的随机噪声。其二:判分题的隔离。质量验收题与测量题分开维护,验收题在全部测量完成后一次性跑,避免中途人工判分打断温度与节奏的一致性。另外提醒一句笔记本特有的坑:跑分期间合盖、切电源、后台更新扫描,任何一项都能让数据作废——实验机要做减法,关掉一切不相关的东西。
三问三答
问:为什么同是 4 比特,Q4_0 比 Q4_K_M 还慢一点?答:M 杯把敏感张量升到 6 比特增加的搬运量,被 K 系更现代的内核省了回来,速度接近而质量更好,这正是中杯成立的机制。问:3B 小模型也适用这套选档逻辑吗?答:方向适用、档位上探——小模型扛不住低比特,整体上调一档,小模型配高位宽好过大模型配低比特。问:有没有一句话版结论?答:先保证能全卸载,再在装得下的档位里挑质量最好的那档,本章全部内容都是这句话的展开与例外处理。
把结论带回预算
位宽选择的终点是第 5 章的显存账本,这里先把两个章节的接口接上:本章表格的「体积」一列,就是账本里权重账的实数;「全卸载」一列的成立与否,决定了账本还有没有空间给 KV 缓存与计算缓冲。换句话说,选档从来不是量化章的独立决定,而是「质量档位」与「窗口预算」的联合决策——3.3 给出质量与体积的坐标,5.3 给出显存的账本,两章合起来才是完整的答案。读到第 5 章时请带着这张表回去,你会发现自己已经会用它了。
给不同硬件的速查推演
把本章方法论往两类常见硬件各推一步,示范「趋势可迁移」的用法。入门核显本(纯 CPU、单通道内存):带宽腰斩,全部速度数字约打对折,临界档效应消失——因为永远无法全卸载,决策简化为「8B 的 Q4 纯 CPU 还是 3B 的 Q6 纯 CPU」,后者往往体验更佳。桌面 12GB 卡:全卸载临界档上移到 Q5_K_M 甚至 Q6_K,速度与质量双丰收,本章表格的结论方向不变、档位平移。两步推演的共同前提只有一个:先弄清自己的「全卸载临界点」在哪,再套表格——这也再次说明,数字是别人的,方法是自己的。
本节要点回顾
- 质量分段平缓、体积线性下降:Q8 到 Q5 的退化很小,Q4 可用,Q3 开始露怯;
- 速度看「全卸载临界档」:刚好塞进显存的档位才有速度跃升,盲目压缩反而不快;
- 部分分层是隐蔽的成本区:生成阶段跨总线搬运会吃掉大部分分层收益;
- 方法论三件套:固定变量、分组建档、多轮取中位数,换硬件就重跑;
- 本章的选档结论(Q4_K_M 为默认)将作为后续所有章节的基准配置。