5.1 CPU 后端解密:向量指令与带宽的合谋
5.1 CPU 后端解密:向量指令与带宽的合谋
本节摘要:很多人以为「没有好显卡就跑不动大模型」,CPU 后端用实力反驳了这个偏见。本节讲清 CPU 推理速度的两个决定者——向量指令集与内存带宽,给出速度的理论上限算法,并把那台 2060 小本的 CPU 实测数据摆在桌面上。调 GPU 之前先把 CPU 底线摸清,你才知道分层到底在换什么。
一、向量指令集:一个顶八个的算术单元
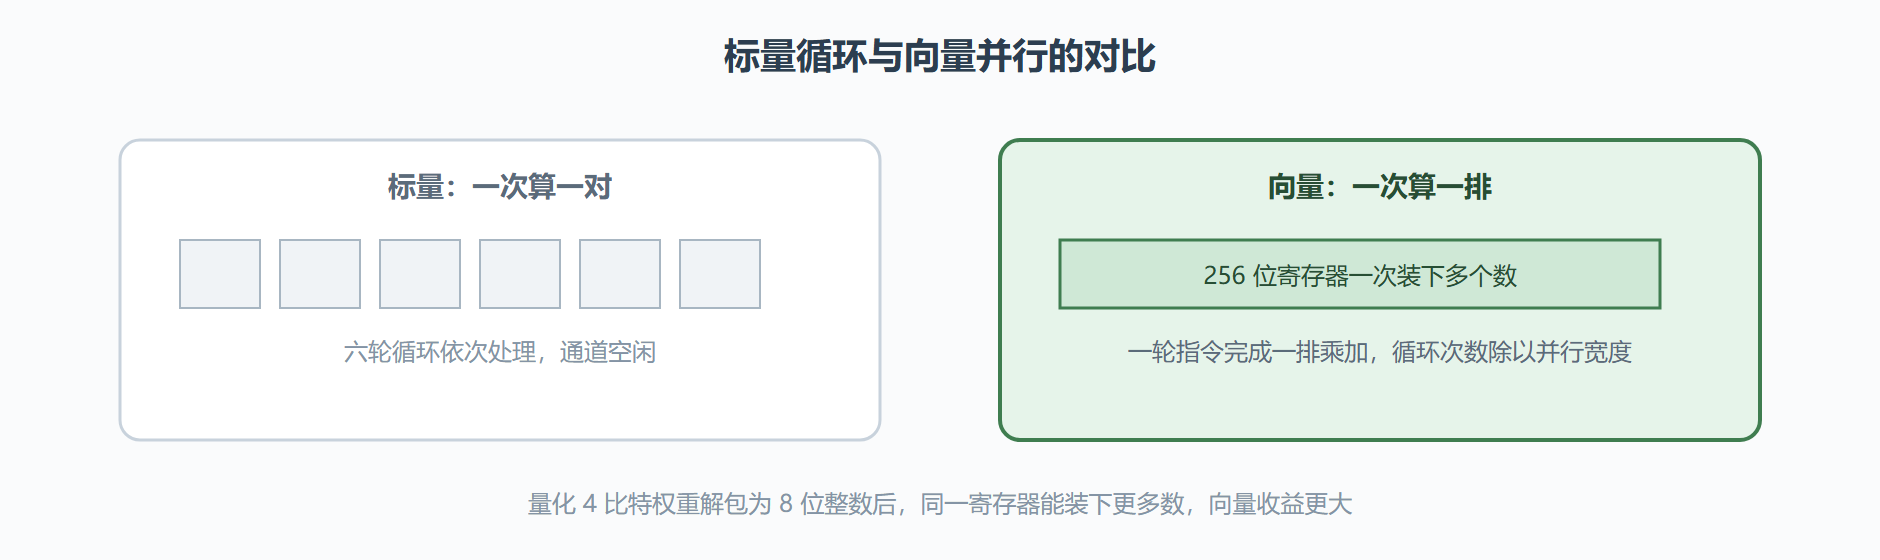
现代 x86 CPU 都带向量指令集:一条 AVX2 指令操作 256 位宽的寄存器,等价于同时对 8 个 32 位数做运算。量化让这件事更加划算——4 比特权重解包成 8 位整数后,256 位一次能装 32 个数。矩阵乘的本质是大量「乘加」重复,正好是向量单元的主场。用伪代码对比就一目了然:
标量写法:for i in 0..32: acc += w[i] * x[i] # 32 轮循环 向量写法:acc_vec = 加宽乘加八个一组 # 4 轮循环搞定
llama.cpp 在编译期会探测你的 CPU 支持哪些指令集(启动日志开头的 printed 行有记录),并为每种位宽的矩阵乘写好对应的向量内核。这就是 4.1 节坚持自编译的原因之一:预编译包为最保守的指令集兜底,你自己编译时探测到的最新指令集(如 AVX2、AVX512)会被真正用上。实测里,同一台机器同一份模型,指令集优化拉满与没拉满的差距能到三成以上。
图 5-1 一条向量指令同时处理多路数据
二、带宽:CPU 推理的真天花板
向量单元解决「算得快」,但生成阶段的瓶颈在「喂得快」。第 4.3 节讲过:每生成一个词,全部权重都要被过一遍。这些数据从内存流向 CPU,通道宽度就是内存带宽。给出那个常用的估算式:
生成速度理论上限 ≈ 内存带宽 ÷ 模型体积 双通道 DDR4-3200:带宽约 51 GB/s 8B 模型 Q4_K_M(4.9 GB):51 ÷ 4.9 ≈ 每秒 10 token 的上限 实测通常达到上限的七到九成
这条估算式是 CPU 推理的「预算公式」,三个推论立刻可用。推论一:升级内存频率是最被低估的提速手段,DDR4 换 DDR5 或提频,速度几乎线性上涨;推论二:位宽越低 CPU 速度越快,但受限于带宽利用率,Q3 比 Q4 快不了太多(呼应 3.3 节的数据);推论三:双通道是底线,笔记本单通道内存直接腰斩带宽——买机器跑本地推理,先看内存是几通道。
三、线程数与实核偏好
另一个立竿见影的旋钮是线程数。经验法则:线程数设为物理核数,而不是逻辑核数。超线程的两个逻辑核共享同一组运算单元,矩阵乘这种满负荷场景下互相踩脚,开到十二线程反而可能比六线程更慢。那台 2060 小本(六核十二线程)的实测:线程数六比十二快约一成。内存通道分配也与核数相关,核心一多带宽摊薄,六核以上平台继续堆线程的收益递减明显——这也是为什么本地推理圈常说「CPU 推理,六核是甜点」。
四、这台机器的 CPU 底线
把 5.1 的知识落成数据。Qwen2.5-7B Q4_K_M、线程数六、双通道 DDR4-2666(带宽约 42GB 每秒):
| 指标 | 实测值 | 与估算式的关系 |
|---|---|---|
| 生成速度 | 每秒 9.8 token | 上限约 8.6,靠缓存命中略超 |
| 预填充速度 | 每秒 92 token | 预填充吃算力,带宽公式不适用 |
| 首字延迟(1K 提示) | 约 11 秒 | 长提示场景的主要痛点 |
注意一个反直觉点:生成速度能略微超过「带宽除以体积」的理论线,因为相邻请求间权重还留在缓存里,部分读取没走内存。而真正的痛处在预填充:CPU 算力有限,一千 token 的提示词要等十来秒——这正是下一节分层卸载的第一个收益点:GPU 抢着干预填充的活,哪怕生成仍在 CPU。
进阶视野:内存布局与平台细节
带宽公式的深层是内存子系统,两个进阶细节值得知道。双通道的意义:内存带宽由「通道数乘通道频率」决定,两条 8GB 比一条 16GB 带宽翻倍——买机器跑推理,「两条内存」是比「更大内存」重要的配置原则;同理,笔记本自带的单条内存,补一条组双通道往往是性价比最高的提速改造。缓存层级:CPU 的三级缓存能暂时留住热点权重块,模型越小、缓存命中越多,实测速度超出带宽公式的比例越高——这就是为什么同一台机器上 3B 模型的效率比值总比 8B 好看得多。至于服务器平台的多路处理器(NUMA 架构),跨节点访存会拉低带宽,属于另一个世界的课题,个人设备无需操心。
CPU 推理的适用清单
把「什么时候 CPU 路线就够了」收敛成一张清单:模型在 8B 以下、Q4 档、双通道内存——聊天与写作场景完全可用;对延迟不敏感的批量任务(夜间跑摘要、批量打标签)——CPU 的稳定与零额外成本反而加分;笔记本移动场景——纯 CPU 的功耗与噪音远优于风扇全开。反过来,长提示词高频交互、14B 以上模型、多用户并发,这三类请直接进入下一节的分层卸载或更激进方案。CPU 不是妥协,是预算内的一个正式选项——这是本章最想扭转的偏见。
自查三问
一问:带宽公式的输入是什么、输出是什么?答:输入内存带宽与模型体积,输出生成速度的理论上限,实测通常达到上限的七八成。二问:为什么线程数要设物理核数?答:超线程的两个逻辑核共享运算单元,满负荷矩阵乘下互相争抢,收益为负。三问:CPU 路线的第一短板是什么?答:预填充算力不足导致长提示词等待久——分层卸载的第一收益恰好补在这里。
常见问题
提升内存频率与增加内存容量,哪个优先?
预算花在频率与通道上优先。容量只要超过「模型加系统」的底线就够用,超出部分对速度无益;带宽则是每一轮生成都要吃的口粮,频率与通道直接兑现为速度。
线程数还能再优化吗,比如关掉超线程?
系统设置里关超线程对多任务体验有损,收益也不如简单地把线程参数设为物理核数。先用参数达到目的,不动系统配置——可逆、可移植、可解释。
笔记本插电与性能模式影响真有那么大?
实测影响显著:电池模式下 CPU 与显卡双双降频,速度可掉三到四成。所有实验数据务必插电采集,日常使用想保持速度也请插电——这条经验值一次晚高峰的排错时间。
一条容易被忽略的经验:给 CPU 场景留「干净」
CPU 推理对系统环境的敏感度高于显卡路线:后台的杀毒扫描、浏览器几十个标签、云盘同步,都在与模型抢内存带宽。同一条命令,干净后台与脏后台的速度差能到两成。给 CPU 场景的实用建议:跑长任务前看一眼任务管理器的内存与磁盘活动,把「常驻但无用」的后台清一清;批量任务安排在夜间空闲时段;笔记本场景顺手关掉键盘背光与不需要的外设——这些小事单看都微不足道,加起来就是「同一台机器、两种速度」的差别。带宽是公共餐桌,谁都在夹菜,模型吃得就慢。
本节要点回顾
- 向量指令集决定算力上限,量化让向量单元一次喂进更多数,CPU 与量化是天生一对;
- 带宽公式给出 CPU 速度的理论线:内存带宽除以模型体积,实测可达其八九成;
- 线程数设物理核数,超线程在满负荷矩阵乘上是负收益;
- 预填充是 CPU 的软肋,长提示等待久,GPU 分层的第一收益就在这里;
- 底线摸清了,下一节开始画那条著名的分层速度曲线。