5.2 offload 分层扫描实验:画出你的速度曲线
5.2 offload 分层扫描实验:画出你的速度曲线
本节摘要:-ngl 参数决定把模型的前多少层放进显存。本节用它做一次完整的扫描实验:层数从零到全满逐档实测,产出预填充与生成两条曲线。曲线会揭示本章最重要的结论——生成速度的收益集中在「刚好全卸载」的临界点,部分卸载对生成几乎无效。附完整的实验命令与数据表,你可以原样搬到自己机器上。
实验要回答的两个问题
问题一:GPU 分层的收益到底长什么样,线性增长还是台阶跃升?问题二:如果显存装不下全部层,还值得部分卸载吗?社区对这两个问题的答案众说纷纭,原因在于多数人只测过一两个点,看不到曲线全貌。扫描实验就是把点连成线。
一、实验设计
方法:用官方基准工具一次扫过全部层数档位,每个档位自动执行「128 token 预填充加 128 token 生成」的标准动作,输出两段速度。变量控制:模型固定为 Qwen2.5-7B 的 Q4_K_M(全卸载需约 5.6GB 含小窗口缓存,临界档),上下文窗口 2048,温度与批次固定,插电运行、性能模式、风扇全开——笔记本温控降频是本实验最大的噪声源,务必排除。
# 一条命令扫完八档;逗号分隔的层数列表是官方基准工具的原生能力 llama-bench -m qwen2.5-7b-instruct-q4_k_m.gguf \ -ngl 0,4,8,12,16,20,24,28 -p 128 -n 128 -c 2048
二、数据
表 5-1 分层扫描实测(2060 小本,量级参考)
| 卸载层数(共28) | 预填充 每秒token | 生成 每秒token | 备注 |
|---|---|---|---|
| 0 | 92 | 9.8 | 纯 CPU 基线 |
| 4 | 161 | 9.9 | 生成几乎没动 |
| 8 | 253 | 10.0 | |
| 12 | 386 | 10.2 | |
| 16 | 571 | 10.5 | |
| 20 | 838 | 11.0 | |
| 24 | 1147 | 11.9 | 显存接近装满 |
| 28(全卸载) | 1463 | 16.7 | 生成速度跃升 |
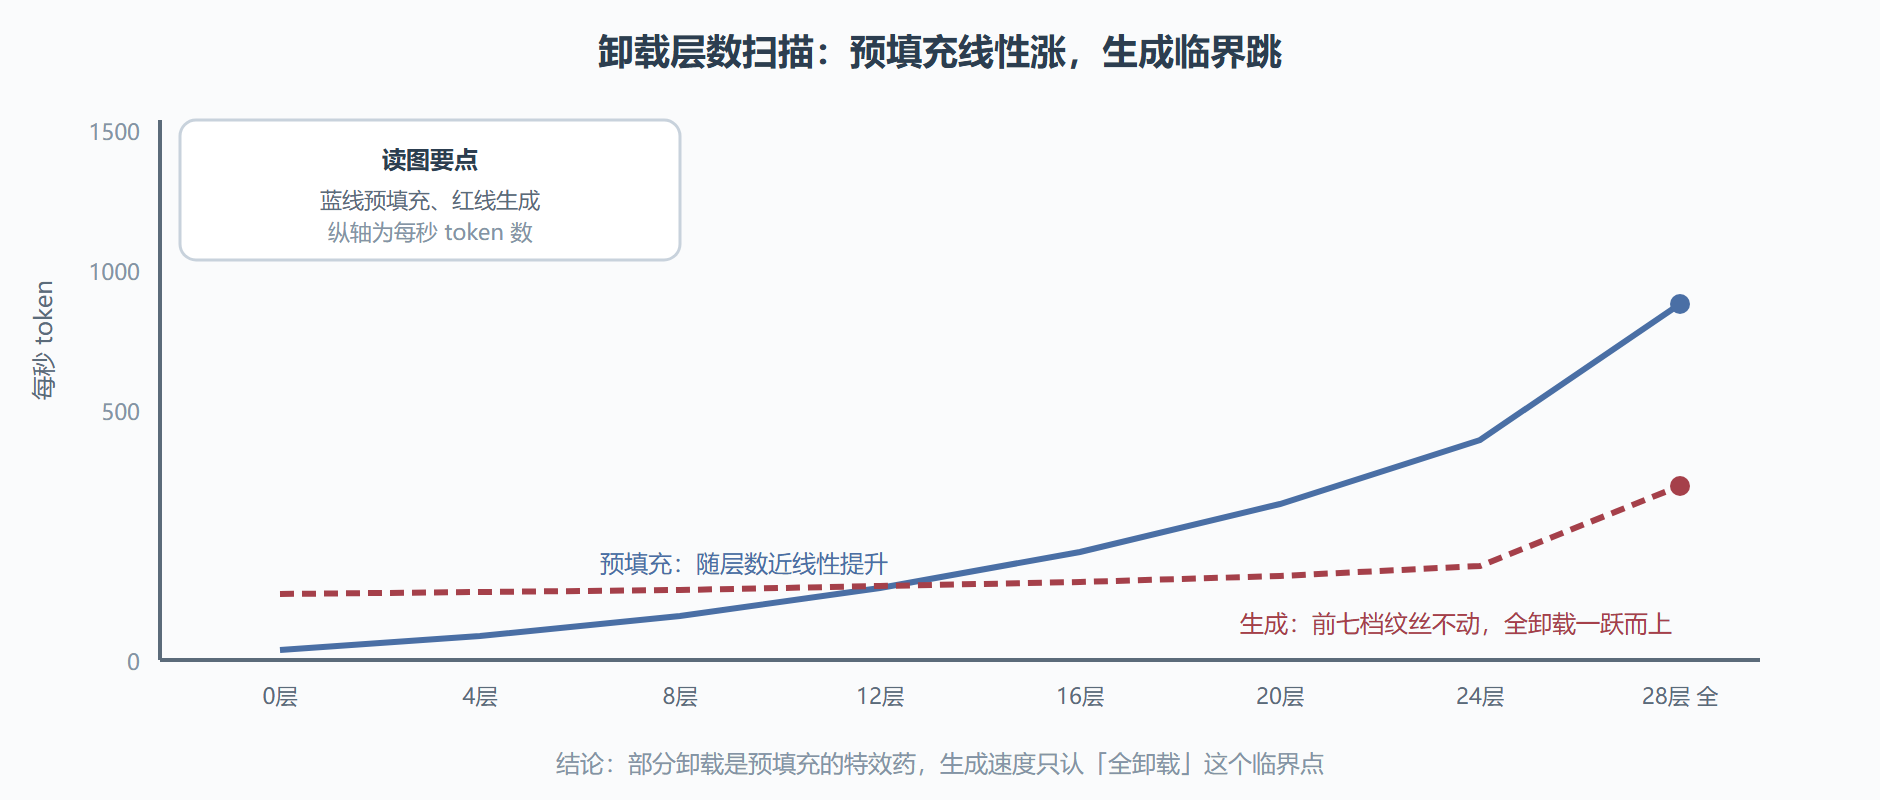
图 5-2 两条速度曲线的形状差异
三、解读:为什么两条曲线性格迥异
预填充近似线性:它并行处理整段提示词,GPU 承担的层越多,CPU 的工作越少,两块设备还能流水线接力。每多卸载四层,预填充速度稳定上台阶,与层数成正比——这就是为什么长文档问答哪怕只能部分卸载,也值得把能塞的都塞进去。
生成只认临界点:生成阶段每产出一个词都要把全部 28 层过一遍。只要还有一层留在 CPU,中间激活就要在层间跨总线往返一次,PCIe 的延迟与带宽同时作梗;28 层全进显存后,往返消失,权重读取全走显卡带宽,速度一步到位。这条曲线是 5.1 节带宽公式的 GPU 版印证:生成速度由「权重待在哪条总线上」决定,而不是由「多少计算在 GPU 上」决定。
由此得出配置决策树:显存够全卸载 → 全卸载,剩余空间给窗口(5.3 教你怎么分);不够全卸载 → 看场景——长文档问答用部分卸载吃预填充收益,纯聊天场景不如降位宽换全卸载,或干脆接受纯 CPU 并把省下的电与噪声留着。
四、变式与坑
变式一:更激进的模型。换 14B 模型重跑,曲线形状不变、临界点上移——你的显卡永远差那么一两层。此时 3.3 节的结论与本章汇合:降一档位宽换全卸载,几乎总是正确的。
坑一:温控降频污染数据。笔记本连续跑分时后半程速度下滑不是玄学,是热保护。扫完一轮歇两分钟,或者对比首末档位复测确认。
坑二:把预填充收益误当生成收益。有人部分卸载后感觉「快多了」,其实是首字等待变短(预填充提速),流式输出的节奏(生成速度)纹丝未动。两个指标分开看,是本书反复强调的纪律。
数据解读的三个进阶视角
拿到自己的曲线后,三个视角能读出更多东西。效率比视角:把每档的生成速度除以显存占用量,「每 GB 显存换来多少 token」在临界档出现峰值——显存预算紧张时,效率比最高的档位就是性价比之王。分段收益视角:把扫描范围拆成「纯 CPU 到半卸载」与「半卸载到全卸载」两段,前段的速度斜率属于预填充收益,后段的跳变属于总线消除收益,两段收益的来源不同,预算应优先投给后者。温度视角:连续扫描的末档数据若比中档还慢,是降频作祟而非真实拐点,复测确认后再下结论。这三个视角共同指向一个实验素养:曲线上的每个点都有物理来历,解释不了的点不要采用。
自查三问
一问:部分卸载十二层后生成速度几乎没变,钱花哪儿了?答:花在预填充上——并行计算提前完成,首字等待缩短;生成速度的收益要等全卸载才兑现。二问:为什么不能只卸载「最重要的层」?答:生成时每个词都要走完全部层,缺哪层哪层就是瓶颈,分层不是择优而是整链搬运。三问:扫描时哪一档最值得重点复测?答:临界档及其下一档——「差一层能不能全卸载」的对比直接决定你选模型位宽的决策。
常见问题
扫描要测多少个点才够?
临界点附近加密、两端稀疏即可。本节的八档是示范配置,实操时先粗扫四档(零、四分之一、四分之三、全满)定位临界区,再在临界区内逐层加密——用最少的时间拿到有决策力的曲线。
显存比模型大很多时还有必要扫吗?
有必要但可简答:能全卸载且窗口充裕,答案就是全满,扫描用于确认「全满后还有多少余量给窗口」。真正需要精细扫描的是临界区机型——6GB 到 12GB 显存的用户是本节实验的主要受众。
分层参数之外,卸载策略还有别的形态吗?
有进阶玩法:把部分层常驻显存、其余按需调度的混合策略在实验性分支出现过;更实用的是把不同模型分别整份卸载、多模型共存的编排(5.3 节末尾的扩展账本会展开)。层级的粒度已经够用,编排的粒度是下一层乐趣。
实验记录模板
把扫描结果沉淀成可复用的记录,一张卡就够:顶部写明日期、引擎版本、模型文件哈希前八位、电源与温控状态;中部抄录基准工具的原始输出;底部画两条手绘曲线并标注临界档与三条结论(全卸载是否可行、临界档是哪层、效率比峰值在哪档)。这张卡的价值在「下次对照」:引擎升级、驱动更新、换了硅脂之后重扫一遍,两张卡一对比,任何性能回退都无处遁形。本书的实验志方法论,最终就落在这一张张卡片上——数据会过时,记录与对照的习惯不会。
与第 6 章的一次握手
扫描的结论还影响窗口决策,这里提前埋一个接口:全卸载成立后,省下的显存给谁用?第 6 章的答案是窗口与 KV 缓存——每多留 500MB 余量,窗口就能多开约 8K(16 位缓存口径)。也就是说,本节的扫描不只是速度实验,还是第 6 章窗口预算的前置输入:先扫出「全卸载后的剩余空间」,再去第 6 章决定怎么花。全书章节间的这种接力,正是实验主线「每章回答上一章遗留问题」的具体形态。
本节要点回顾
- 扫描实验三要素:基准工具、层数列表、变量控制(尤其温控);
- 预填充收益近线性,部分卸载对长文档问答仍然超值;
- 生成收益是阶跃函数,只在全卸载点兑现,中间层数基本白搭;
- 决策树一句话版:够就全卸载,不够就按场景二选一——吃预填充或降位宽;
- 曲线解释完了,下一节算账:显存里那三本账到底怎么记。