6.1 KV 缓存与上下文扩展:长文本的内存博弈
6.1 KV 缓存与上下文扩展:长文本的内存博弈
本节摘要:KV 缓存是推理引擎最精妙的一笔空间换时间交易:把历史 token 的注意力中间状态存下来,生成才能从重复计算变成增量计算。本节讲清它的机制、它如何随窗口增长、窗口满了之后发生什么,以及 RoPE 缩放这类扩展技术的位置。它是 5.3 节显存账本的理论注脚,也是 6.3 节 KV 量化的铺垫。
一、没有缓存的世界:不可承受的重复计算
注意力机制的天性是「每个词都要看全部历史」。按最朴素的实现,生成第 1000 个词时,前 999 个词的键与值都要重新算一遍——生成第 1001 个词时再算一遍前 1000 个。整个生成的计算量随长度平方增长,一千 token 的回答就能把最快的显卡拖进泥潭。
KV 缓存的解法直白而有效:每个 token 的键与值算一次就存下来,后续所有轮次直接查表。生成第 1001 个词时,只需要计算这一个新词的键值对追加进缓存,历史部分全部复用。计算量从平方级降回线性级,代价是这块缓存要常驻内存——5.3 节账本里的第二本账由此而来。
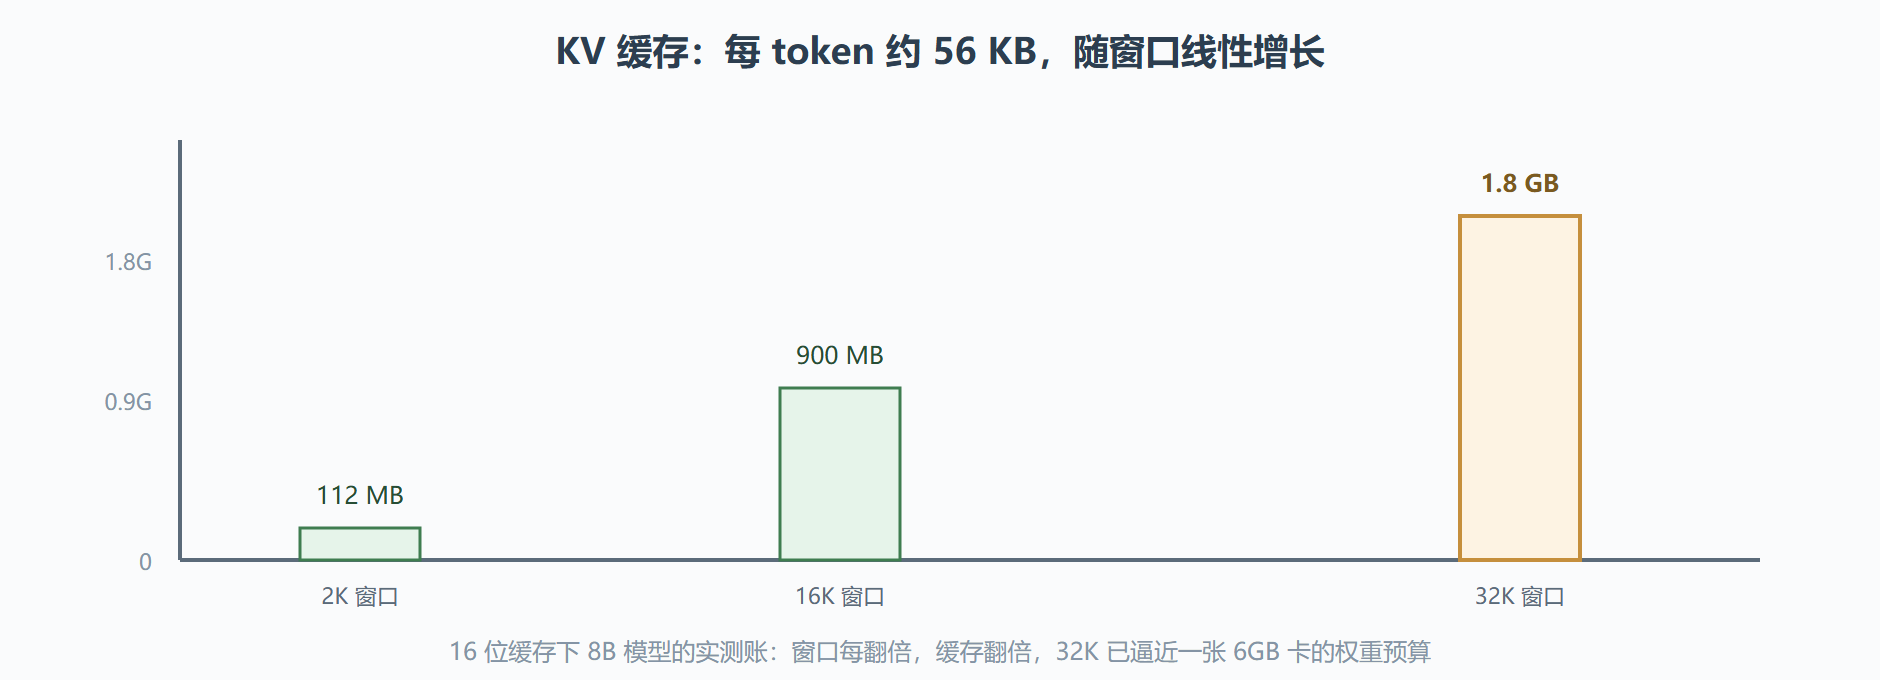
图 6-1 KV 缓存占用随窗口长度的增长
二、缓存的内部构造与「记忆挤出」
缓存的账目结构在 5.3 节已经拆过:层数乘 KV 维度乘窗口。这里补上它随时间推移的行为——窗口是定长滑槽。新 token 追加进来,超过窗口容量的最早数据从槽口挤出。interactive 模式下你会看到日志提示上下文发生位移(context shift),指的就是这个挤出动作。
理解滑槽机制能解开两个常见误解。误解一:「模型聊久了变笨是 bug」。不是,最早被挤出的正是对话开头的设定与约束,模型「忘了」自己的人设——治理办法是把关键约束重新复述,或用更大的窗口。误解二:「窗口设多大生成速度就按多大算」。缓存按窗口上限预分配,但生成速度只取决于实际累积的长度——2K 上限的对话在开头几百词时,速度与 32K 上限配置毫无区别。窗口是预付的房租,不是按用计费的水电。
三、窗口上限从哪来:训练值与扩展技术
模型的窗口上限写在它的出生证明里——训练时见过的最长序列长度。直接把窗口设到训练值之上,输出质量会明显劣化,因为模型没学过在更长的相对距离上做注意力。
要在训练值之上再扩,主流路线是 RoPE 缩放(旋转位置编码的外推调整),llama.cpp 里对应的参数家族以 rope-scaling 命名,其中 YaRN 是目前社区常用的一档:它对注意力做按距离分频的缩放,让模型在「没见过」的距离上维持合理行为。实用建议分三档:窗口在训练值内,什么都不用做;超出训练值一到两倍,开 YaRN 并接受一定的质量折损;需要数十倍扩展,那是专门的长上下文模型的领地,通用模型硬扩得不偿失。第 8.3 节的本地 RAG 会给出另一条思路:与其无限扩窗,不如只把最相关的片段装进窗口。
四、实操:观察你的缓存
理论讲完,用两条命令亲眼验证。第一条看预分配:启动时把窗口设大,日志里的 KV self size 会精确给出缓存开销;第二条看行为:同窗口下分别用 200 与 2000 token 的提示词跑生成,比较生成速度——你会发现生成速度几乎不变(缓存查表不贵),而预填充时间显著不同(并行算一遍很贵)。这两条观察合起来就是本章前两节的全部门道。
# 观察 1:缓存按窗口预分配(8B 模型,16K 窗口) llama-cli -m qwen2.5-7b-instruct-q4_k_m.gguf -c 16384 -ngl 99 -p "hi" -n 1 # 日志:llama_kv_cache: KV self size = 900.00 MiB # 观察 2:窗口是预付房租,短对话时速度与 32K 配置无异 llama-bench -m qwen2.5-7b-instruct-q4_k_m.gguf -ngl 99 -c 16384 -n 64 -p 512
深一层:GQA 为什么是账本救星
老一代模型的缓存账比本节公式算出的更大,差别在注意力的构造。原始多头注意力里,「头数」决定键值向量的宽度:三十二个头就存三十二份键值,缓存维度等于隐藏维度,每 token 的缓存开销高达数百 KB。分组查询注意力(GQA)的改法是让多个查询头共享一组键值头——比如八个查询头共用四组键值,键值宽度缩到隐藏维度的零点几倍,缓存开销直落一个数量级。质量损失极小而账本收益巨大,这是近年新架构不约而同采用它的原因,也是「同一窗口,新模型就是比老模型省」的机制根源。查询你的模型是否用了 GQA:看元数据里键值头数与查询头数是否不等——这一个小检查,直接决定你窗口预算的宽松程度。
上下文使用的三条纪律
机制讲完,落到使用侧的三条纪律。给窗口留两成余量:系统提示、对话模板、安全边界的隐性 token 都在挤占额度,按「需要的内容长度乘一点二」设窗口。长会话主动续写式收敛:与其让滑槽默默挤出开头,不如每隔一段把关键结论让模型自行小结后重开会话——主动的收敛优于被动的遗忘。监控上下文水位:服务模式(第 7 章)的指标端点能看每槽用量,命令行场景则从日志读当前序列长度,水位过半就该有计划地收敛或清理。三条都不难,难的是养成习惯——窗口机制的坑几乎全部源于「假装它不存在」。
快问快答
问:KV 缓存省了什么计算?答:历史 token 的键值计算,让每步生成从「重算全部历史」变成「只算新增一个」。问:窗口 8K 的模型跑 4K 会话,缓存按多少分配?答:按 8K 全额预分配——窗口是预付房租,与实际用量无关。问:对话久了模型忘了系统设定,是缓存坏了吗?答:不是,是滑槽挤出了最早的记忆,治理办法是复述关键约束或扩窗或主动收敛会话。
常见问题
窗口设得比训练值小,质量会更好吗?
不会更好,只是省显存。注意力在短距离上的行为与窗口上限无关(滑槽只影响「保留多少」),质量取决于模型本身。按需设窗口即可,小窗口换不来小模型。
「中途改窗口」可以吗?
重启进程才能改。缓存在启动时按窗口预分配,运行期不可伸缩——这也是服务模式要把窗口一次规划好的原因(第 7 章的「总额制」正源于此)。
判断词表里的 token 与窗口里的 token 是一回事吗?
是同一个概念的两端:词表定义「一个 token 长什么样」,窗口计量「一次能放多少个」。分词器把文本切成词表条目,窗口为切出来的序列分配槽位——理解这两层的分工,中文容量换算(1.2 节)就不再神秘。
一个常见场景:会话应该多长
把窗口知识落到日常使用的会话管理上。对话场景的实测经验:单会话在窗口四分之一以内时质量最稳,过半后开始出现轻微的「顾此失彼」,逼近上限前就该收敛。以 4K 窗口为例,大约十到十五轮问答是一条会话的舒适上限。收敛建一个仪式感:让模型用三句话总结当前讨论的关键结论,带着这段总结开启新会话——既保住了上下文的连续性,又把窗口水位清零。这个「总结接力」的小习惯,是窗口机制知识最直接的日常回报。
本节要点回顾
- 缓存把生成从平方级拉回线性级,代价是一块随窗口线性增长的常驻内存;
- 窗口是定长滑槽:挤出最早记忆是机制不是缺陷,人设丢失靠复述或扩窗治理;
- 窗口是预付房租:缓存按上限预分配,生成速度只看实际累积长度;
- 扩窗三档论:训练值内免动作、超一到两倍用 YaRN、数十倍换专门模型或 RAG;
- 缓存的账算清了,下一节转去质量侧:采样参数才是「答得好不好」的日常变量。