6.2 采样参数实验:温度、截断与惩罚的调参手记
6.2 采样参数实验:温度、截断与惩罚的调参手记
本节摘要:模型每一步输出的不是一句话,而是一张几万行的概率表;采样参数决定从这张表里怎么抽签。本节拆解采样链的每个环节——温度塑形、截断去尾、惩罚防复读——然后用四个任务做实测对照,产出一份按场景取用的参数档案。这是「模型答得差」问题里最常被冤枉的一环。
先纠正一个归因偏差
本地模型圈流传着大量「7B 就是笨」的断言。其中相当一部分,实测后真相是采样错配:温度 1.0 加无截断去写代码,产出程序自然是胡言乱语;温度 0.1 去写散文,产出必然干瘪复读。权重决定模型「会什么」,采样决定模型「这次拿出什么」。调参之前,先把归因搞对。
一、采样链:一步输出的流水线
每个 token 生成前,采样链按固定顺序处理概率分布:
原始概率表(词表宽度) → 温度塑形:除以 temp,小于 1 更陡(保守),大于 1 更平(冒险) → 重复惩罚:压低已出现 token 的概率,打断复读循环 → Top-K 截断:只留概率最高的 K 个候选 → Top-P 截断:只留累积概率达到 P 的最小候选集 → Min-P 截断:丢掉相对峰值太小的候选(与温度联动的现代方案) → 按剩余概率抽签,产出本步 token
图 6-2 温度对概率分布的塑形与两级截断
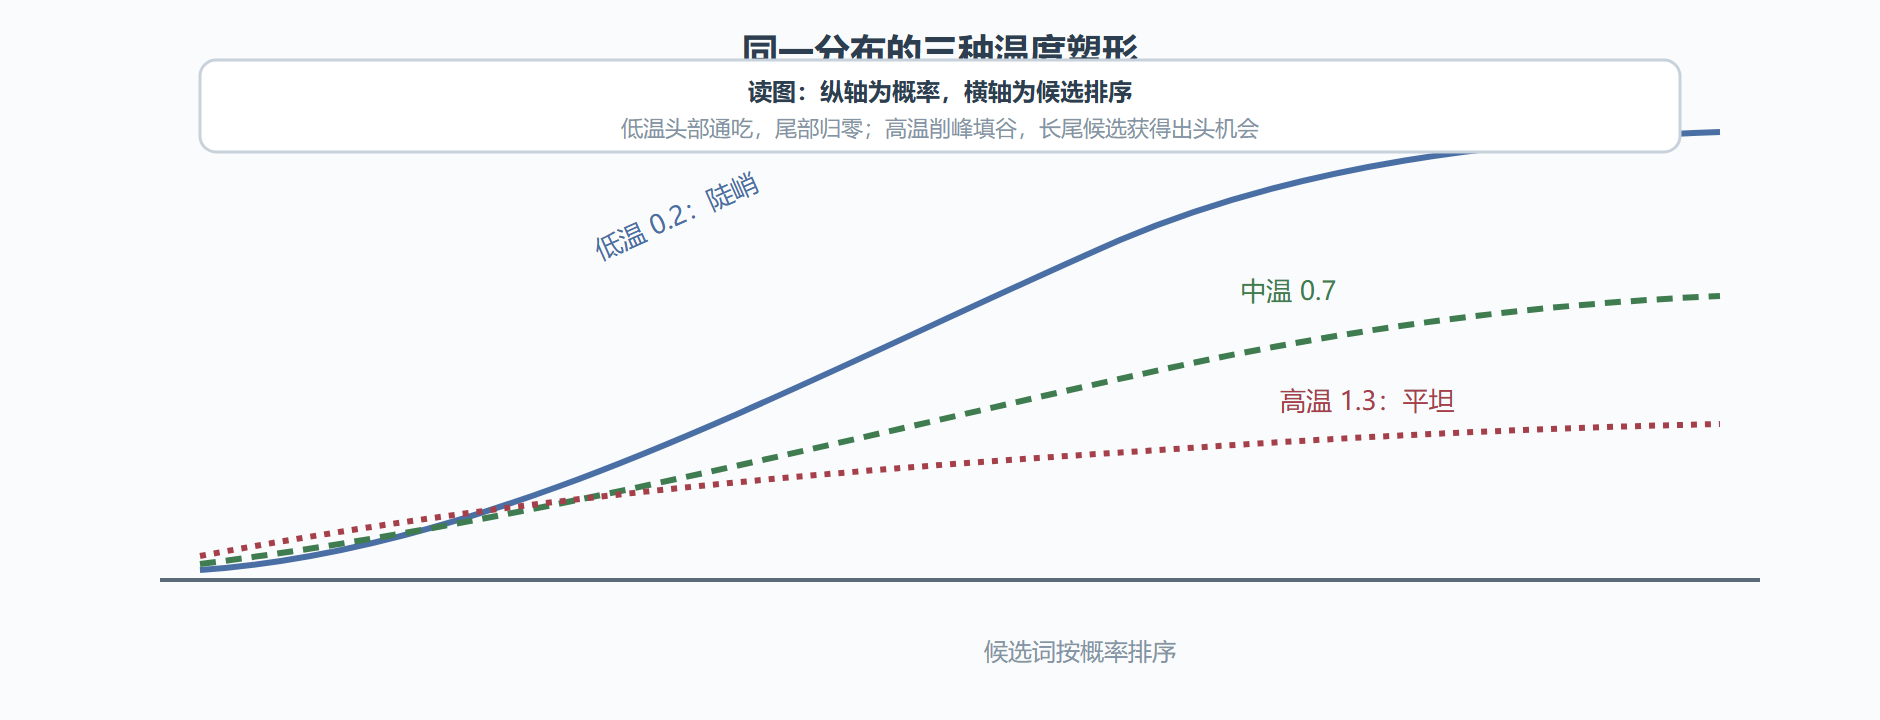
温度是整条链的性格旋钮:0.2 的分布里头部候选占九成,输出稳定可预期;1.3 的分布削峰填谷,冷门词也有出场机会——创造力与胡言乱语是同一枚旋钮的两面。截断家族负责保险丝:Top-K 按名额、Top-P 按累积概率、Min-P 按相对峰值,三者目的相同——无论温度多高,都不给垃圾候选翻盘的机会。惩罚家族专治复读:频率惩罚按出现次数线性压制,存在惩罚只看出现与否,重复惩罚按最近窗口内的出现打折。惩罚过重有后遗症:代码里的括号引号这类合法高频 token 会被误伤,输出变得畸形。
二、四个任务的实测对照
方法:固定模型(Q4_K_M 全卸载)、固定提示词模板、固定种子,只动采样参数,每个组合生成二十条样本,人工评定可用率并统计重复率。数据(量级结论,非绝对值):
| 任务 | 温度 | Top-P | 重复惩罚 | 实测观感 |
|---|---|---|---|---|
| 代码生成 | 0.2 | 0.95 | 1.0(不加) | 可用率最高;加惩罚反伤语法符号 |
| 技术问答 | 0.3 | 0.9 | 1.05 | 稳定少废话,偶有复读可用惩罚压制 |
| 中文写作 | 0.85 | 0.9 | 1.1 | 句式多变;1.0 以上开始失控 |
| 摘要翻译 | 0.1 | 0.8 | 1.0 | 几乎确定性输出,忠于原文 |
三组值得展开的观察。其一,代码任务别加惩罚——括号、换行、缩进这类 token 天生高频,惩罚会让模型刻意回避它们,产出在语法层面就坏了。这是我见过的最常见的一处「自作聪明」。其二,温度与截断要联动:高温必须配紧截断(Top-P 0.9 以内),低温可以放宽;Min-P 在高温场景下比 Top-P 更稳,因为它锚定的是相对峰值。其三,确定性不是越高越好:温度 0.05 的「翻译任务」实测偶尔陷入死循环,留 0.1 的余量反而更稳。
三、一份可抄的参数档案
把上面的实测收束成启动参数。建议按任务存成几个脚本别名,用时调取:
# 代码任务:低温、紧截断、无惩罚 --temp 0.2 --top-p 0.95 --min-p 0.05 # 技术问答:中低温、常规截断、轻惩罚 --temp 0.3 --top-p 0.9 --repeat-penalty 1.05 # 中文写作:中高温、紧截断、中惩罚 --temp 0.85 --top-p 0.9 --repeat-penalty 1.1 # 摘要翻译:近确定性 --temp 0.1 --top-p 0.8
常见问题
固定种子加低温,能当「确定性模式」用吗?
接近但不能画等号。浮点运算的并行归约顺序不保证逐位一致,跨硬件与跨版本都可能出现个别 token 分歧。要求严格可复现的工程场景,请在业务层做哈希校验而不是依赖采样确定性。
参数之间要不要一个一个试?
先抄档案再微调,别从零扫参数。采样参数的交互效应复杂,无方向的全组合扫描性价比极低——档案是别人替你走过的弯路。
为什么官方示例的温度各不相同?
因为任务不同。看到任何参数建议时先问「这是给什么任务用的」,脱离任务谈参数都是耍流氓。
深一层:Min-P 为什么更懂温度
截断家族里最年轻的方法值得单独讲。Top-P 的截断线是「累积概率」——分布越平(温度越高),同样的累积额度要装下越多的候选,截断线随温度漂移,高温时保不住底线。Min-P 的思路是把线画在「相对峰值」上:低于峰值概率某个比例的候选一律出局。峰值是分布自身的锚点,温度升高、峰值下降,截断线跟着下移,但「垃圾候选永不入围」的底线始终守住。用开车比喻:Top-P 是固定里程保养,Min-P 是看路况自适应。实测建议:低温场景两者差异可忽略;高温创作场景 Min-P 明显更稳,参数取 0.05 到 0.1 之间起步。
实验记录的两个坏习惯
调参实验的无效循环,多半源于两个坏习惯。坏习惯一:改参数不固定种子。样本间的差异混入了随机性与参数效应,你判断的「变好」可能只是抽签运气。固定种子、逐参数动,才是对照实验。坏习惯二:用单一题目验收。一道题的优劣不代表任务面的表现,判分题组至少覆盖任务的典型变体(本节的二十条样本配置是底线)。把两组习惯纠过来,采样调参从玄学变回实验——这也是全册反复出现的测量纪律在质量维度的应用。
快问快答
问:采样参数影响生成速度吗?答:占比极小可忽略,瓶颈在权重搬运,放心调参。问:惩罚与截断谁先起作用?答:温度塑形、惩罚调整、截断收口、最后抽签——过重惩罚配紧截断会让候选池枯竭,输出退路变窄。问:模型自带的推荐参数可信吗?答:可信但别迷信,那是按发布者测试任务调的;以推荐值为起点、以自己的验收题组为准绳。
一个容易误判的现象:长回答的「越写越差」
长回答的后半段质量下降,常被归罪于采样参数,实测归因要更细。参与因素有三:上下文越长,注意力对开头的指令约束越稀释(6.1 节的机制);重复惩罚的窗口随文本推进不断积累,后期误伤合法表达的几率上升;温度不变的条件下,候选分布的尾部随着生成推进更容易被反复选中。对策按因下药:超长输出拆段生成、惩罚系数对长回答调低一档、或用「先列提纲再分段展开」的两段式提示。把「越写越差」拆成三个可分别干预的因子,调参就从玄学变成了对症下药。
把档案变成团队资产
个人调好的参数档案,往团队推时要补三样东西:一份「为什么是这些值」的说明(否则下次有人好心改掉)、一套固定的验收题组(新参数上线前统一过题)、以及版本意识(模型换了,档案要重新校准,别拿旧档案硬套新模型)。三样补齐后,采样参数从「某人的手艺」变成「团队的配置」——这条小路走通的意义超出采样本身:第 5 章的账本、第 3 章的选档,都可以用同样的方式沉淀为团队资产。教程教的从来不只是参数,是把经验制度化的方法。
本节要点回顾
- 采样链五道工序:温度塑形、惩罚压制、三级截断、概率抽签,顺序固定各司其职;
- 归因纪律:答得差先查采样再怀疑权重,温度错配是「模型笨」的最大假象来源;
- 代码任务禁用重复惩罚,合法高频符号会被误伤到语法层面;
- 温度与截断必须联动,高温配紧截断是安全带;
- 质量调好了,下一节回到 5.3 节留下的那道矛盾:显存不够,窗口怎么上 32K。