7.2 llama-server 实战:OpenAI 兼容接口与并发槽位
7.2 llama-server 实战:OpenAI 兼容接口与并发槽位
本节摘要:llama-server 把模型变成一个 HTTP 服务:内置与主流云端服务兼容的接口、自带网页对话界面、支持多槽位并发。本节从一条启动命令开始,逐端点验证接口兼容性,再用压测数据讲清槽位机制——这是判断你的用户规模该不该升级方案的关键依据。
从命令行到服务的惊险一跃
命令行工具(第 4 章)每次调用都要重新加载模型,几十秒的启动成本注定它只能是单机玩具。llama-server 的加载策略不同:模型常驻显存或内存,每个请求只做增量计算,首字延迟从分钟级降到秒级。更关键的是接口形态——它实现了一套主流云端服务兼容的协议,你给现有代码换个地址就能切到本地模型。工程上的意义:本地推理从「换个玩法」变成了「换个部署选项」。
一、启动与配置
一条命令启动服务,参数分三组:模型与硬件组沿用第 5 章的全部知识,服务组新增,并发组是本节重点:
llama-server -m qwen2.5-7b-instruct-q4_k_m.gguf \ -ngl 99 -c 8192 \ --host 127.0.0.1 --port 8080 \ -np 2 --cont-batching on \ --metrics on # 日志关键行 # main: server is listening on 127.0.0.1:8080 # main: slots: 2
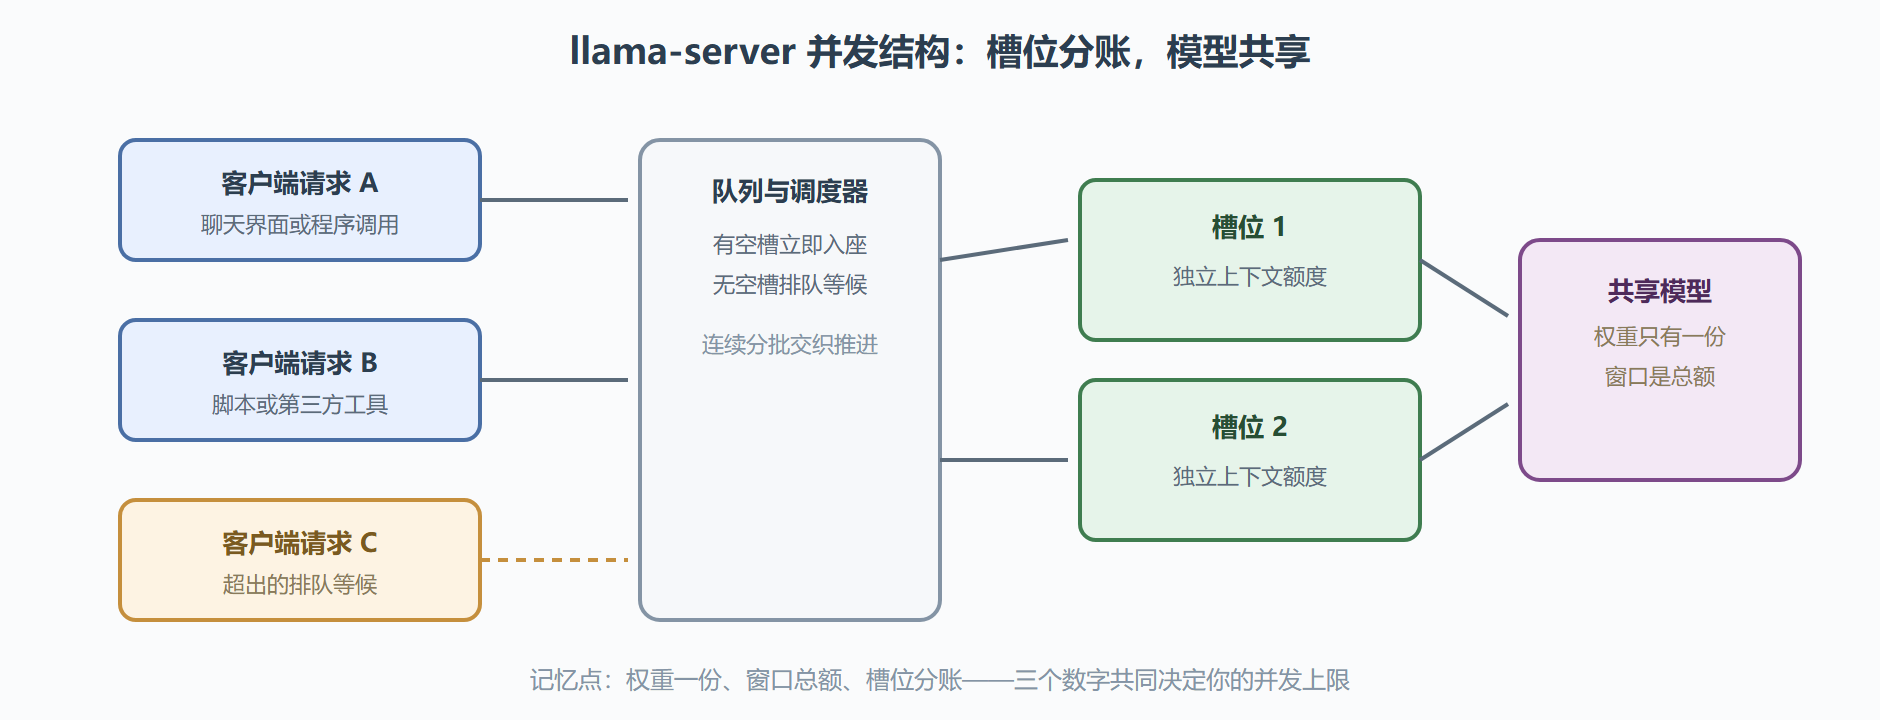
模型硬件组里只有一处新知识:服务模式下窗口 -c 是所有槽位共享的总额,两个槽位各分一半。并发组里 -np 指定槽位数,连续分批开关让多个请求交织调度而不是轮流整批处理——并发的两个核心开关就是它们。指标开关打开后,服务会暴露运行时指标端点,供外部监控抓取。启动成功的标志是监听日志,浏览器打开服务地址还能看到一个自带网页界面,适合随手验证。
图 7-1 服务进程的并发结构:槽位、共享窗口与队列
二、接口逐个验证
对话端点是与云端服务兼容的主接口,用请求工具验证:把「接口地址加对话端点」填进任何现成客户端,模型选服务启动时加载的那个,消息发出去,流式回答原样返回。补全端点服务裸文本补全场景,代码编辑器类工具多用它。向量端点把文本变成嵌入向量,是第 8.3 节本地检索的地基,值得现在就验证可用。属性端点返回服务的全部运行配置,排查「服务到底按什么参数在跑」时第一步就查它。指标端点输出槽位占用、请求计数与耗时分布,压测时盯它。
# 验证对话端点:与云端同构的请求体 curl 服务地址/v1/chat/completions -H "Content-Type: application/json" -d '{ "model": "qwen", "messages": [{"role": "user", "content": "一句话介绍 llama.cpp"}], "temperature": 0.3 }' # 验证向量端点(第 8.3 节要用) curl 服务地址/v1/embeddings -H "Content-Type: application/json" -d '{ "input": "量化是把权重映射成低比特整数" }'
三、槽位压测:并发到底能扛几个
方法:起两个槽位、8K 总窗口,用并发请求工具分别以 1、2、4、6 路并发打流式请求,统计每路的生成速度与排队时间。数据(量级参考):单路 16.7 token 每秒;两路各降到 9 到 10,总算力接近翻倍——连续分批让两个请求交织吃满硬件;四路时超出的请求排队,平均等待约等于前序请求的剩余时长,已入座请求速度进一步摊薄到 6 上下;六路时队列排队时间开始超过生成时间,主观体验是「点了没反应」。
结论照槽位机制推演即可理解:总算力是常数,槽位只是分账方式——槽位少则单请求快、并发差;槽位多则并发好、单请求慢。配置准则:槽位数取「典型同时使用人数」,窗口总额除以槽位数必须满足单请求的最长输入。这台机器的落点:两到三槽、每人 4K 额度,服务三四个同事的日常问答绰绰有余;再多就该参考 7.1 的多实例方案分机部署,或迁往专业的高并发服务框架(1.3 节的 vLLM 位置正在那里)。
快问快答
问:两个槽位并发为什么总吞吐接近翻倍而单路只掉四成?答:连续分批让请求交织吃满算力空隙,硬件利用率上升,总账守恒、分配更满。问:窗口 8K 两个槽位,单请求上限多少?答:约 4K,窗口是槽位间共享的总额,配置前先做除法。问:什么时候该承认 llama-server 到顶了?答:排队时间持续超过生成时间、用户数还在涨——那就是多实例或专业并发框架的入场券。
对外监听的安全基线
局域网可用的下一步是对外暴露,安全基线四条必须一次配齐。访问密钥:服务支持请求侧密钥校验,开启后无密钥请求一律拒绝——这是暴露给非本机访问的前提条件而非可选项。监听范围收敛:只在内网可用就别监听公网地址,路由器端口转发更是想都不要想。资源上限:限制单请求生成长度与并发槽位,防止异常请求把显存账本挤爆。日志常开:谁在什么时候发了什么请求,日志是事后追责与异常发现的唯一线索。四条的共性是把服务当「对外门户」而不是「本机工具」来对待——权限、边界、限流、审计,门槛不高,缺一条都可能变成别人的免费算力。
日志与指标的日常巡检
服务跑起来后的运维动作很轻,每天两分钟。看一眼日志尾部:异常请求、加载告警、重启记录,三类事件值得多看一眼。扫一眼指标端点:槽位占用率长期贴顶说明该加槽或减用户,请求耗时的长尾突然拉长通常是硬件层(温度、降频)在报警。记一笔台账:重启原因、参数变更、异常事件,一行一条——服务化之后「稳定」不再是一次性达标,而是持续的小额维护,台账是维护的记忆。
常见问题
服务进程崩了会丢什么?
会丢槽位里的会话上下文(对话记忆),模型文件与向量库不受影响。长对话场景建议客户端侧保存关键内容——把服务当「无状态算力」来用,崩了重连即可,别把不可再生数据托付给进程内存。
需要配置成开机自启吗?
常驻服务值得,用系统的服务管理机制托管,配好崩溃自动拉起。托管后记得连日志轮转一起配,别让一年的日志写满磁盘——那是另一种排错噩梦。
升级引擎版本时服务怎么平滑切换?
新旧版本装在不同构建目录(7.1 节的矩阵),切换流程四步:旧服务停机、新版本冒烟、切端口、观察指标半小时。分钟级停机换版本,对小团队完全可接受。
上线前的最后检查单
服务对外之前五分钟过一遍:模型文件三关校验的记录还在不在台账;启动参数是否与基线一致(槽位、窗口、分层);访问密钥已设置且不是默认值;流式与非流式各打一发验证;断网重连一次看服务是否稳如老狗。这五条对应五类历史事故——文件损坏、参数漂移、裸奔监听、接口回归、进程假活。检查单不神秘,都是踩过的坑换来的,背下来的坑不必再踩一遍。
本节要点回顾
- 服务的本质收益:模型常驻免加载,接口兼容云端协议,现有工具零改造成本接入;
- 窗口是槽位间共享的总额,槽位数与单请求额度的乘积不能超账;
- 并发模型是按槽位串行、槽位间交织,总算力守恒,槽位只是分账方式;
- 压测准则:槽位取典型同时人数,排队时间超过生成时间就是该扩容的信号;
- 服务能扛了,下一节解决「程序怎么优雅地调它」:三种语言绑定的接入对比。