7.3 多语言绑定:Python、Go 与 Node 的接入对比
7.3 多语言绑定:Python、Go 与 Node 的接入对比
本节摘要:程序调用本地模型有两条路:走 7.2 节的 HTTP 接口当客户端,或用语言绑定把引擎嵌进自己进程。本节用三段可运行的真实代码对比 Python、Go、Node 三条绑定线的风格与取舍,并给出接入决策:默认走 HTTP,桌面离线应用与批量向量任务考虑进程内绑定。
两条路线先分清
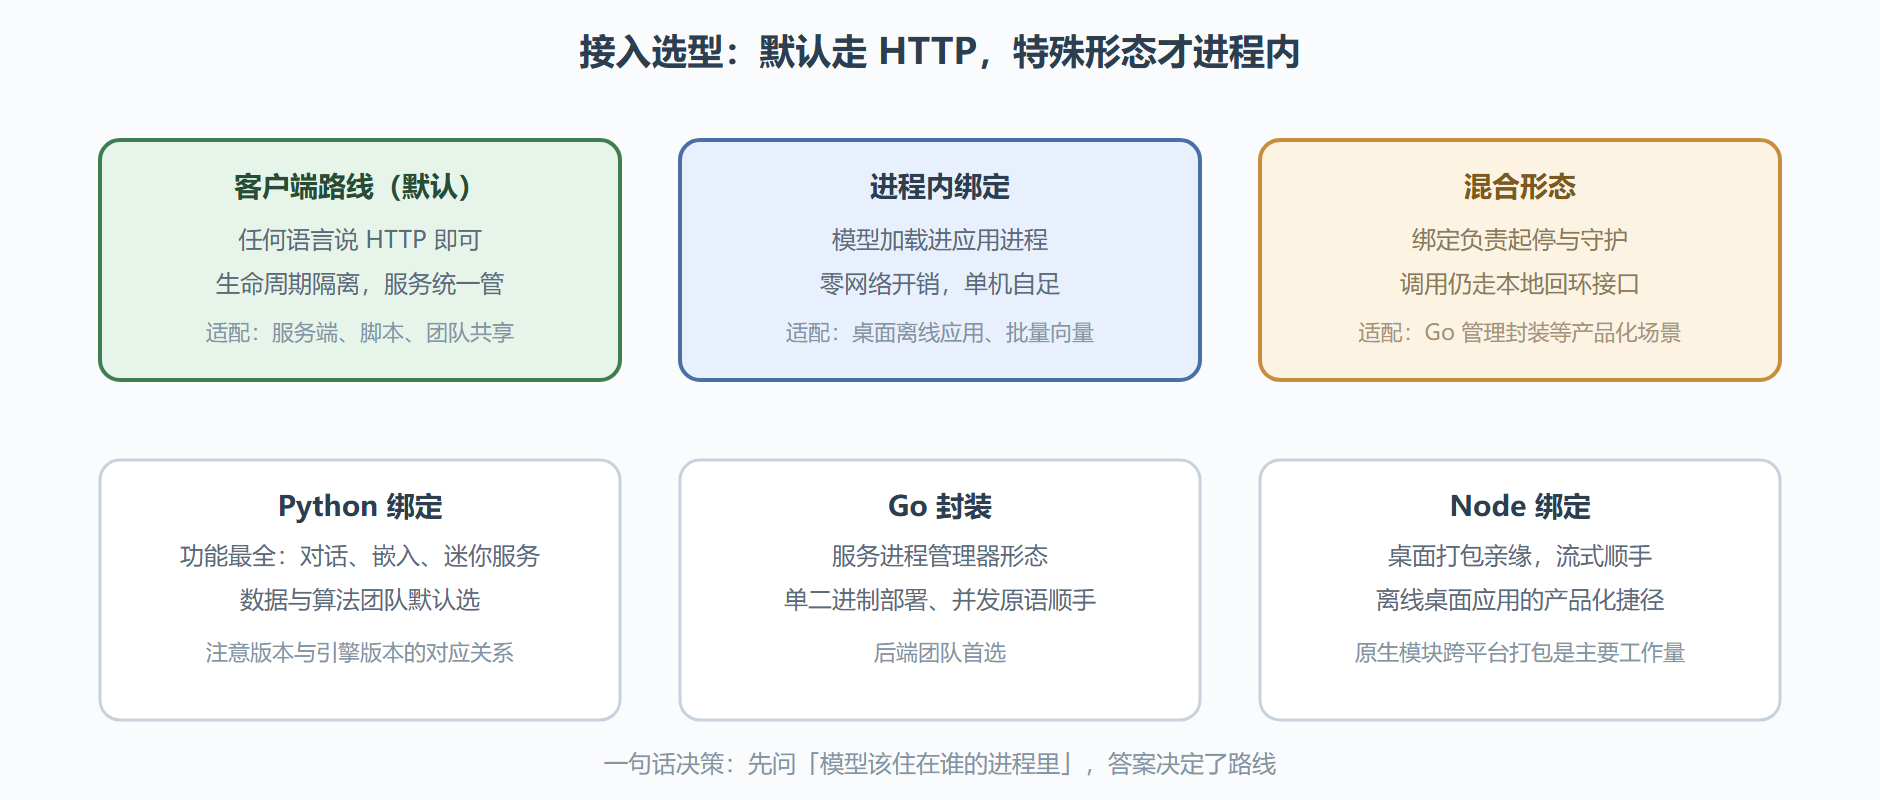
客户端路线:你的程序说 HTTP,llama-server 管模型。语言无关、生命周期隔离、崩互不牵连,7.2 节的接口兼容性红利全部继承。进程内绑定路线:社区维护的语言封装把引擎编译成扩展模块,模型直接加载进你的进程。省一层网络、函数调用级延迟,代价是绑定版本与引擎版本绑定、你的进程与推理进程共生死。两条路线不是竞争关系,是按应用形态分工:服务端与脚本走客户端,打包分发的桌面应用与高吞吐向量任务才值得进程内。
一、Python:生态最厚的一条线
Python 绑定是三条线里功能最全的:进程内推理、对话模板自动处理、向量嵌入、甚至内嵌一个迷你服务模式。典型用法几十行收工:
from llama_cpp import Llama # 进程内加载;n_gpu_layers 即第 5 章的分层旋钮,n_ctx 即窗口 llm = Llama( model_path="qwen2.5-7b-instruct-q4_k_m.gguf", n_gpu_layers=-1, # -1 表示尽量全卸载 n_ctx=4096, ) out = llm.create_chat_completion(messages=[ {"role": "system", "content": "你是严谨的技术助手。"}, {"role": "user", "content": "用两句话解释 KV 缓存"}, ], temperature=0.3, max_tokens=200) print(out["choices"][0]["message"]["content"])
配合向量端点或进程内嵌入接口,它能一条流水线完成第 8.3 节的本地检索:切块、向量化、入库存取全部不换工具。数据科学团队几乎是默认选它。
二、Go:部署友好的服务侧胶水
Go 社区的路线更侧重服务端集成:常见形态不是进程内推理,而是一套管理 llama-server 子进程的封装——启动、健康检查、优雅关闭、代理转发一把抓。Go 程序自己的代码则规规矩矩说 HTTP:
// Go 侧:以标准 HTTP 客户端调用 7.2 的对话端点 func ask(endpoint, prompt string) (string, error) { body := fmt.Sprintf(`{"messages":[{"role":"user","content":%q}]}`, prompt) resp, err := http.Post(endpoint+"/v1/chat/completions", "application/json", strings.NewReader(body)) if err != nil { return "", err } defer resp.Body.Close() // 解析 JSON 并抽取回答字段(略) return parseChoice(resp.Body) }
这条线的价值在运维形态:单个静态二进制丢上服务器就能跑,内建的并发原语天然适配「多请求排队打服务」的形态。后端团队的首选。
三、Node:前端亲缘与桌面打包
Node 绑定把引擎编译成本地扩展模块,桌面应用框架(如 Electron 系)里可以直接进程内跑模型——这是「做一个完全离线的桌面 AI 应用」这条产品路线的捷径。前端背景的团队还能顺手把流式输出接成打字机效果:
import { getLlama } from "node-llama-cpp"; const llama = await getLlama(); const model = await llama.loadModel({ modelPath: "qwen2.5-7b-instruct-q4_k_m.gguf" }); const context = await model.createContext({ contextSize: 4096 }); const session = new LlamaChatSession({ contextSequence: context.getSequence() }); // 流式输出:逐段回调,适合接进聊天界面 await session.prompt("用三句话讲清楚 GGUF", { onTextChunk(chunk) { process.stdout.write(chunk); } });
图 7-2 三条绑定线与两条路线的选型地图
四、并发与连接的工程细节
走客户端路线时,三个连接层细节决定稳定性。超时与流式:长回答务必用流式接口——首字节快、连接不易被中间层掐断,非流式长请求是超时重试 bug 的头号来源。重试语义:采样有随机性,失败重试前先决定「换不换种子」,否则可能重放出同一处失败。背压:客户端并发数不要超过服务槽位太多,排队该发生在你自己的任务队列里(7.2 节压测显示排队超过生成时间就该扩容),而不是堆在服务的监听队列里。
常见问题
绑定版本与引擎版本怎么对齐?
社区绑定通常以「支持的引擎版本区间」发布,装包时看说明对号入座。进程内绑定的版本敏感度远高于 HTTP 客户端——前者把引擎编进了你的依赖树,行为随版本整体冻结;后者只要求接口协议兼容,宽裕得多。这也是「默认走 HTTP」的又一条理由。
流式输出在各语言里实现难度差很多吗?
接口层面都提供了流式回调或迭代器,难度相当。真正的差异在前端形态:命令行打字机效果几行搞定,网页端要处理事件流,桌面端要处理线程与界面刷新——难度长在界面层,不长在绑定层。
调用层还要做重试与超时的统一封装吗?
值得,且建议封装在唯一的调用入口里:超时分级(连接快、生成慢)、流式中断的续传语义、并发闸门(客户端侧排队)。这层薄封装是客户端与服务之间的减震器,写一次,所有业务受益。
一个典型的接入选型复盘
把决策框架套在一个真实场景上走一遍。需求:给五人小团队做一个内部知识问答页。约束:模型已由 7.2 节的服务常驻;团队会 Python 与前端,没有 Go 经验;希望页面有打字机效果。决策走查:模型已在服务进程——不需要进程内绑定;前端展示为主——页面直连 HTTP 流式接口即可;团队语言匹配——后端胶水用 Python 快速成型。最终形态:Python 只做检索组装(第 8.3 节的管线),前端直接消费流式端点。复盘要点:决策的每一环都由既有事实推出——服务已在所以进程内无必要,技能已有所以语言已定,效果已定所以接口已选。选型不是选最好的,是选推得动的。
本节要点回顾
- 两条路线一个问题:模型该住在谁的进程里——服务端默认 HTTP,桌面离线才进程内;
- Python 功能最全,数据团队默认选;Go 胜在部署形态;Node 胜在桌面打包;
- 混合形态最工程化:绑定管生命周期、调用走回环接口;
- 连接三细节:长回答用流式、重试想清楚种子、背压放在自己的队列里;
- 接入层完备,第 8 章装上最后三件武器:多模态、LoRA 与本地检索。