8.1 多模态推理:在本地跑通看图问答
8.1 多模态推理:在本地跑通看图问答
本节摘要:模型看图的能力来自一个附加组件:视觉投影器把图片编码成模型认识的「视觉 token」,语言模型照常处理。llama.cpp 用双文件结构支持这一玩法——主模型加投影器文件。本节讲清机制,然后在那台 2060 小本上完整跑通「发图提问」的视觉问答。
看图的机制:图片也是一种外语
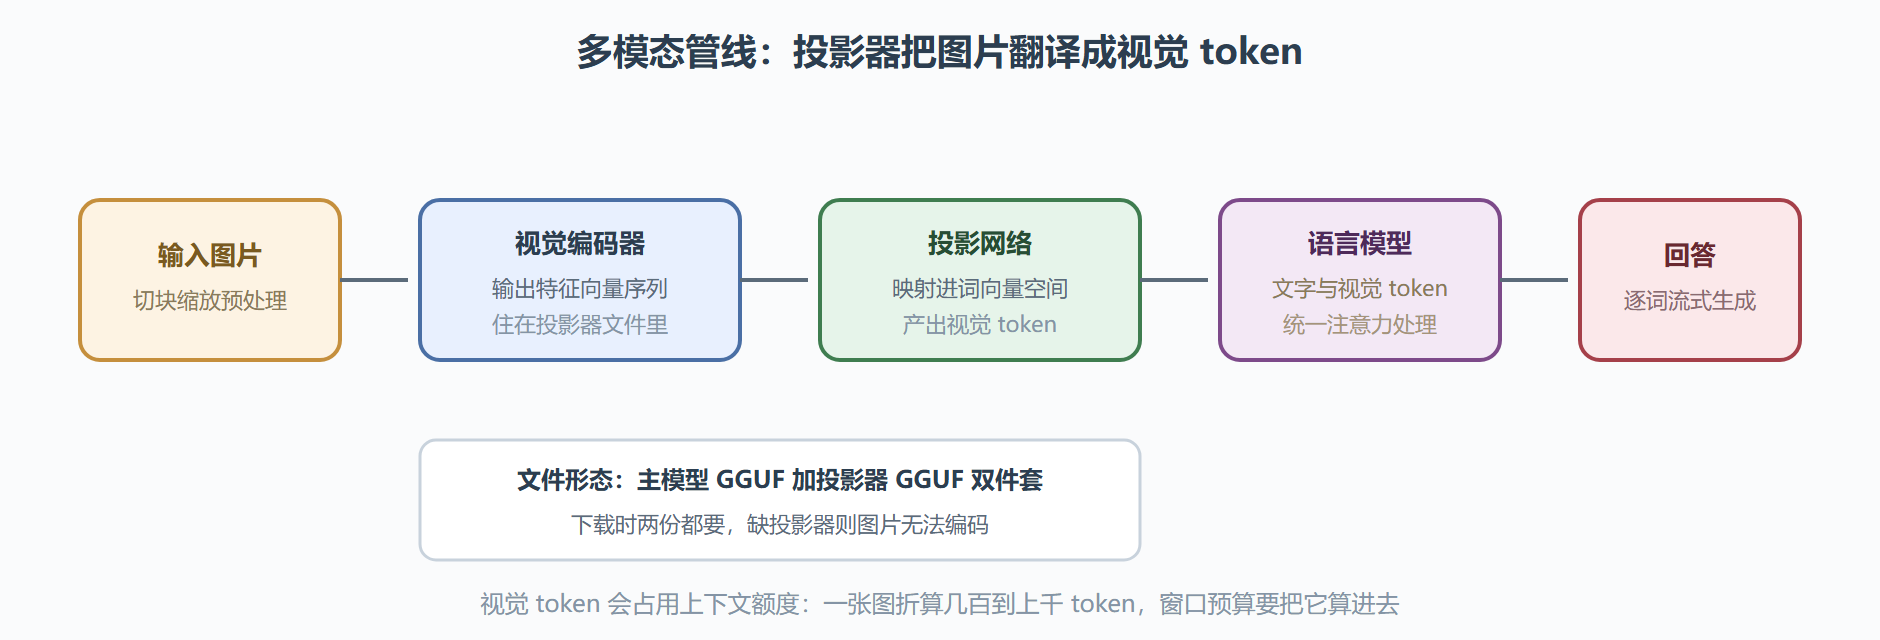
语言模型只认识 token,图片要进来就得先「翻译」。主流方案(LLaVA 一系开创)分两步:一个预训练的视觉编码器把图片切成若干图块、编码成一串特征向量;一个小巧的投影网络把这串向量映射进语言模型的词向量空间——映射之后,这些「视觉 token」在模型眼里与文字 token 平起平坐,注意力机制照常工作。于是「描述这张图」「图里的报错怎么修」与普通对话共用同一套生成管线,唯一的前置步骤是把图片翻译成视觉 token。
图 8-1 多模态推理管线:从图片到视觉 token 再到回答
一、双文件结构与下载
多模态模型在文件层面是「双件套」:语言主模型的 GGUF(前七章处理的就是它)加上视觉投影器的独立 GGUF。两份都要从模型页下载,且必须配套——不同版本的投影器与主模型不通用。第 2 章的三关校验对两份文件分别执行。
显存账本要更新两处:投影器本身通常几百 MB 到 1GB(16 位),随 -ngl 一起入显存;视觉 token 占用上下文额度,一张中分辨率图片折算几百到上千 token——第 6 章的窗口预算里,图片是比文字更贵的房客。这台机器跑 7B 级多模态的配置:Q4 主模型加投影器,2K 到 4K 窗口,账本依旧从容。
二、实录:发图提问
背景:验收目标是把第 4 章编译时画的架构示意图发给模型,让它检查图里的流程错误——一个真实工作流的原型。操作:命令行工具直接挂投影器与图片参数;服务模式下同样支持,接口的消息体里以图片内容字段传图:
# 命令行形态:--mmproj 指投影器文件,--image 指待理解的图片 llama-cli -m llava 类多模态主模型-q4_k_m.gguf \ --mmproj mmproj 投影器-f16.gguf \ --image 架构图.png \ -p "这张流程图里有一处逻辑错误,请指出并说明理由。" # 典型日志片段 # clip_model_loader: 加载视觉模型完成 # encode_image_with_clip: 图像编码完成,编码耗时约 1.2 s
结果:图片编码约一秒出头,模型准确指出了图中「校验放在持久化之后」的顺序问题,并用文字复述了修正后的流程。解读:编码耗时随图片分辨率线性增长,问答质量受视觉编码器能力主导——同一个投影器换更聪明的语言底盘,看图理解立刻提升;反过来只换投影器、语言底盘不动,改善有限。变式:批量场景(给相册写说明、给截图归档)走 7.2 的服务模式,把图片放进消息体循环调用,脚本二十行搞定。
三、常见问题
多模态模型能当纯文字模型用吗?
能。不给图片就是普通对话,质量与同底盘的纯文字版相当。但纯文字需求没有理由选多模态版——体积更大、账本更紧,各司其职才是正解。
为什么我的输出对图片答非所问?
按概率排查:投影器与主模型不配套、图片编码参数与训练时不一致(分辨率档位)、或窗口太小把视觉 token 挤掉了。先确认三件套配套,再查窗口账本。
中文场景识别效果不佳怎么办?
看图能力与语言底盘的中英能力相关,也受训练数据影响。优先选社区验证过中文视觉任务的模型组合,必要时把问题先用英文提问再要求中文作答,实测常有提升。
视觉 token 的账目明细
「一张图折算几百到上千 token」值得拆开算账,因为它直接影响窗口预算。图块切分的粒度决定基数:常用方案把一张中分辨率图片切成数百个图块,每块编码成一个视觉 token,另加若干全局摘要位——中图折算六百上下,高分辨率多图输入轻松破千。给窗口预算带来的实操规则:发图场景按「每图 800 token」预扣额度,多图请求把窗口上限定为「文字需求加图片数乘 800 再乘一点二」。账算细了,「图片一发窗口就爆」的现象就有了预算层面的解释与预防。另外注意编码耗时与 token 数同步增长——批量看图任务的预填充等待主要花在视觉编码上,把图片缩小到任务可接受的下限,是编码侧最有效的提速手段。
进阶玩法:图片流水线
单次看图之外,多模态与前面章节的组合能长出实用流水线。截图巡检:定时把监控截图发给服务模式的多模态端点,配合低温参数输出「是否异常」的结构化判断,一台旧机器就能值班。图文归档:批量给图片生成描述并入库——描述文本走 8.3 节的向量库,图片本身按文件名关联,检索时「以文搜图」零额外成本。表格转写:拍照的手写表格交给模型转成结构化文本,转写结果按 2.3 节的校验纪律人工抽验。三条流水线共享同一套底座:服务进程、窗口账本、验收纪律——多模态不是孤立技能,是全册方法论的又一处应用面。
自查三问
一问:多模态模型为什么需要两个文件?答:视觉编码器加投影器是独立训练的附加组件,与语言底盘分开分发,配套版本必须成对。二问:发三张图提问,窗口预算怎么扣?答:按每图约 800 token 预扣,三张图约 2400,加上文字需求再乘一点二余量。三问:为什么看图任务的提示词里图片应该放前面?答:视觉 token 编码后进缓存,同会话内重复提问不再重复编码,前置图片让多轮提问只做增量计算。
选型与验收:看图组合怎么挑
挑多模态组合的两步决策。第一步看视觉编码器的规格与训练数据——它决定了能看多细、认多广,社区评测里看图基准的成绩基本由它贡献;第二步看语言底盘与你的文字场景是否匹配——底盘决定表达质量与中文能力。验收用「三图一组」的小题组:一张信息密集图(考察细节读取)、一张需要推理的图(考察图上逻辑)、一张含文字的截图(考察文字识别),三题答稳再上线。多模态的坑多数不在「跑不起来」,而在「跑起来了但看不准」——验收前置,比事后返工便宜得多。
常见问题
视觉内容会被「量化」吗?
投影器文件通常是 16 位,少数发布提供量化版。视觉编码器的量化敏感度高于语言主干,追求稳定优先 16 位投影器——它体积不大,省这一块的收益远小于风险。
一张图反复提问,编码会重复进行吗?
同一次会话内不会——图片编码出的视觉 token 进入缓存后与文字 token 同等待遇,后续提问只做增量计算。这也是「多图长会话」场景把图片放前面、问题放后面的排布依据。
为什么描述图片细节比识别人物靠谱得多?
视觉编码器擅长局部特征与空间关系,弱于身份记忆与细粒度知识。任务设计顺应这一点:描述、比对、定位类任务放心用;识别具体人物、判断真伪类任务要么加外部工具,要么降低预期。
本节要点回顾
- 看图的机制是翻译而非融合:投影器把图片变成视觉 token,语言模型无感处理;
- 双文件配套:主模型加投影器,三关校验分别执行;
- 视觉 token 是窗口里的贵客:一张图几百到上千 token,账本要预留;
- 能力上限在视觉编码器、表达下限在语言底盘,升级组合先动底盘;
- 看图过关,下一节让这个底盘学会「换性格」:LoRA 适配器。