8.2 LoRA 适配器:加载、叠加与热切换实验
8.2 LoRA 适配器:加载、叠加与热切换实验
本节摘要:微调一个大模型要改它的全部权重,LoRA 只在旁边挂两片小小的低秩矩阵——训练便宜、分发轻巧、还能在推理时随挂随卸。本节讲清低秩适配为什么成立,然后在 2060 小本上完成一组「一个底盘多副面孔」的实验:不同领域适配器的加载、缩放与热切换,附自制适配器的完整产线流程。
一、原理:为什么两片小矩阵能改变性格
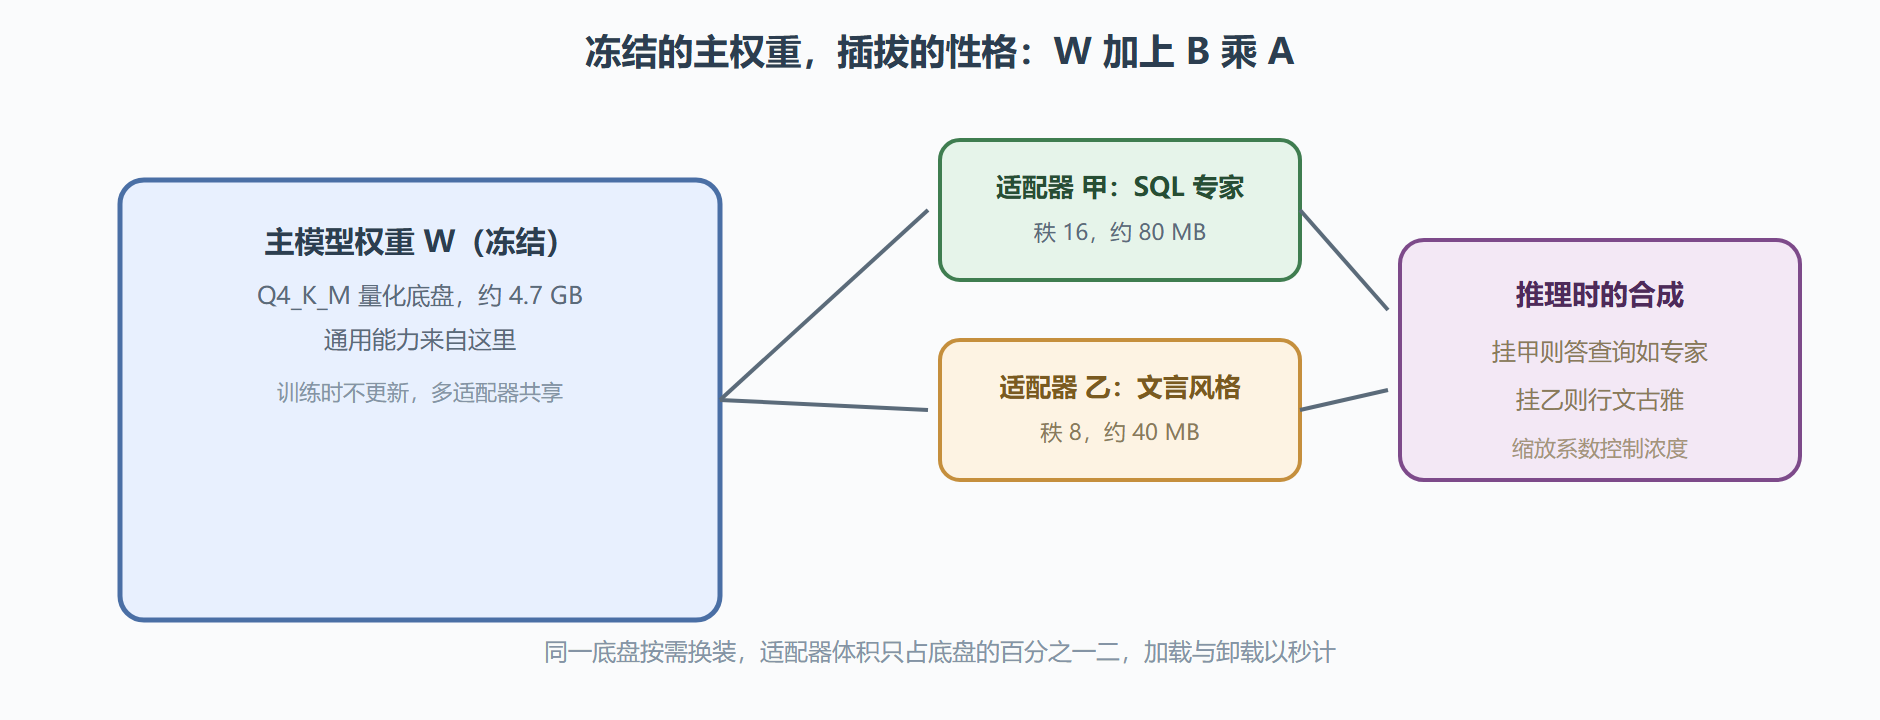
微调的本质是给每个权重矩阵算出一个更新量。LoRA 的观察是:这些更新量高度冗余,用两个瘦矩阵的乘积就能近似——原矩阵 W 保持冻结,旁边挂上 B(大而瘦)乘 A(小而胖),推理时实际使用 W 加 B 乘 A。秩 r 控制瘦矩阵的宽度,常用八到六十四,参数量随之骤降:7B 模型的全量微调要动几十 GB 权重,同规模 LoRA 适配器只有几十到几百 MB。
工程红利接踵而至。训练侧:显存大头是优化器状态与梯度,冻结主权重后这些开销跟着骤降,消费级显卡就能完成过去 workstation 级的活。分发侧:适配器是独立小文件,按领域、按风格自由组合。推理侧:适配器与主权重可以合并成一份新模型,也可以保持分离、运行时挂载——llama.cpp 支持后者,这正是本节实验的舞台。
图 8-2 LoRA 低秩适配:冻结底盘与可插拔性格层
二、实验:一个底盘,多副面孔
设计:准备两个社区适配器——面向结构化查询生成的 SQL 专家(秩十六,约 80MB)与面向中文文言风格的文风器(秩八,约 40MB)——挂在同一份 7B 量化底盘上,逐项测试加载、缩放、叠加与切换。
# 基线:裸底盘回答同一个数据问题 llama-cli -m 底盘.gguf -p "把这句话变成查询:统计上月订单金额前十的客户" -no-cnv -n 120 # 挂载:--lora 指定适配器,可带缩放系数(1.0 全量生效) llama-cli -m 底盘.gguf --lora sql-专家-r16.gguf --lora-scale 1.0 \ -p "把这句话变成查询:统计上月订单金额前十的客户" -no-cnv -n 120 # 叠加:多个适配器各自定浓度,风格与专长并行生效 llama-cli -m 底盘.gguf --lora sql-专家-r16.gguf --lora-scale 1.0 \ --lora 文言风格-r8.gguf --lora-scale 0.6 \ -p "以简练古文解释窗口函数" -no-cnv -n 150 # 服务模式热切换:适配器预载,按请求选用,无需重启进程 llama-server -m 底盘.gguf --lora sql-专家-r16.gguf --lora 文言风格-r8.gguf -ngl 99
结果:裸底盘给出了语法粗糙的伪查询;挂上 SQL 专家后产出可执行的规范查询,字段与聚合逻辑全部正确;两个适配器叠加时,输出以文言笔调解释技术概念,浓度系数 0.6 时古雅而不过度。加载每个适配器约一秒,显存增加量与文件体积相当——三本账里权重账几乎不动。解读:适配器改动的是输出分布的「倾向」,不是知识总量:SQL 专家让底盘「倾向」输出规范查询,但它无法让 7B 底盘答出它本来不懂的私有系统知识——那类需求是下一节 RAG 的领地。变式:缩放系数是连续旋钮,0.4 到 0.7 之间常能找到「专业但不偏执」的中间态,值得逐点试。
三、自制适配器的产线
社区货不敷使用时,自制流程四步。第一步训练:在训练框架里完成 LoRA 训练,样本几百到几千条即可见效,这台机器的 6GB 显存配合量化训练方案能处理 7B 底盘的小秩适配——训练侧的知识此处不展开,产出是一个适配器权重目录。第二步转换:用仓库工具把适配器转换成 GGUF 适配器文件,与底盘的架构必须匹配。第三步验证:固定提示词组跑「裸底盘、挂载后」对照,确认能力增益与副作用(通用能力回退是常见副作用)。第四步合并(可选):需要交付单一文件时,在训练框架侧把适配器合并进基础权重,再走第 2.3 节的转换管线出完整 GGUF;合并后体积回到底盘量级,且不能再热切换。
四、常见问题
适配器能补知识吗?
不能,它调的是行为倾向。知识注入靠继续预训练(成本高)或检索增强(下一节)。适配器最适合的是格式、风格、任务范式这类「怎么做」的调教。
多个适配器叠加会互相打架吗?
会。适配器各自假设自己是唯一修正量,深度叠加的合成效果难以预测。实用上限两到三个,且总浓度(缩放系数之和)控制在 1.5 以内,逐组实测再定。
适配器跨底盘通用吗?
不通用。适配器学习的是针对特定底盘认知结构的修正量,换底盘(换模型家族、甚至换量化版本)需重训或重新验证。
自制适配器的数据配方
训练数据的配方比训练技术更决定成品成色。三条配方原则:少而纯胜过多而杂——几百条高质量、格式一致的样本,效果普遍好过几千条混杂样本;覆盖任务的变体空间——样本要覆盖目标任务的输入多样性(不同长度、不同措辞、边界情况),否则模型学到的只是「这一种问法」的应答;留出验收集——总样本的一成不进训练,专门用于训练后验收,防止「越训越像训练集复读机」。格式上还有一个 llama.cpp 特有的注意点:训练框架产出的适配器与底盘对话模板要对齐,模板错位的适配器会表现出「能力下降」的假象——验收时若全面退化,先查模板再怀疑训练。
常见问题
秩与缩放这两个训练参数怎么起步?
经典起步组合是秩 16 配常规缩放;风格类轻任务可降秩 8,结构化重任务可升秩 32 至 64。秩越大适配容量越大、文件越大、过拟合风险越高——从经典组合起步,按验收集表现微调,比理论推演更可靠。
适配器与第 6 章采样参数会互相影响吗?
会,且常被忽略。适配器改变了输出分布的形状,原先调好的采样参数可能不再最优——换装适配器后,用验收题组把温度与截断快速复测一轮,是换装流程的最后一步。
多个适配器轮流用的运维成本高吗?
服务模式下预载多个适配器、按请求指定,运维成本接近零;命令行场景每条命令带一个 --lora 参数,成本也可忽略。真正的成本在「组合爆炸」:适配器一多,谁配谁、浓度多少的组合需要台账管理——回到本书的老原则,可配置性用台账来驯服。
适配器与 RAG 的分工速判
很多需求在适配器与检索之间摇摆,给出一条速判规则:把需求写成「模型应该___」,如果空格里填的是「怎么说、什么格式、什么风格」,适配器是答案;如果填的是「知道什么、记住什么」,检索是答案。举例:「应该用规范的 SQL 语法回答」是适配器;「应该知道我们公司的报销制度」是检索。「应该以文言文解释技术」是适配器;「应该引用最新的产品手册」是检索。填空测试五秒出结论,比翻比较文章快得多——两条路线在第 8.3 节的组合拳里还会再会师。
本节要点回顾
- 低秩近似让微调轻装化:冻结底盘、两片小矩阵,训练与分发成本骤降两个量级;
- 运行时挂载是 llama.cpp 的独特优势:加载、缩放、叠加、热切换全程不换底盘;
- 适配器调倾向不补知识,知识缺口交给下一节的检索增强;
- 自制产线四步:训练、转换、对照验证、可选合并,验证一步省不得;
- 性格可以换装了,收官一节解决最后一环:让底盘通晓你的私有文档。