8.3 本地 RAG:小窗口接上大知识库
8.3 本地 RAG:小窗口接上大知识库
本节摘要:私有知识的规模总是远超窗口容量,检索增强(RAG)给出的答案是「不把书搬进脑子,先查到那一页再读」。本节在 2060 小本上搭一条极简本地检索管线:文档切块、向量入库、按问检索、引用生成,全程离线运行。收官之际,本节兼作全册的生态瞭望:这个底座周围长出了什么,接下来会往哪里去。
一、为什么检索是「小模型加大知识」的正确姿势
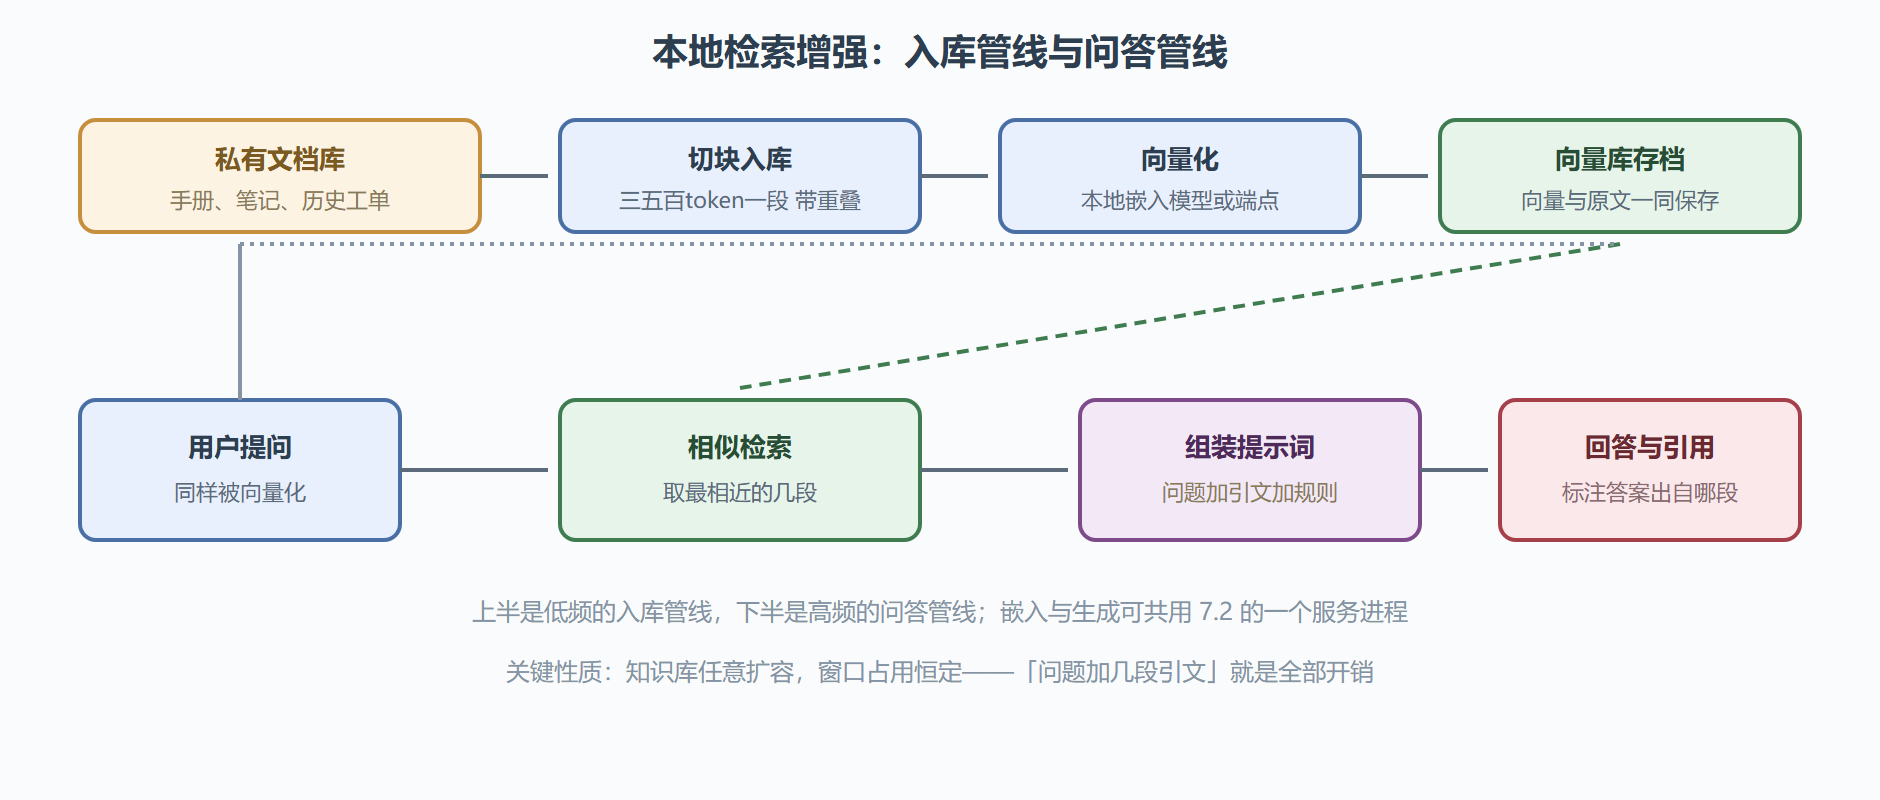
硬把三万字手册塞进窗口是第 6 章账本判过死刑的路。检索增强换了一种问法:每次回答真正需要的只是全文的几段。把文档切成片段,用嵌入模型把每个片段变成向量(第 7.2 节验证过的向量端点在此就位),按问题向量找最相似的几段,把它们连同问题一起装进窗口——窗口只需容纳「问题加几段引文」,知识库的规模却可以无限外扩。这正呼应 6.1 节的判断:扩窗有物理上限,检索没有。
图 8-3 本地 RAG 管线:全部环节都跑在你自己的机器上
二、实录:三万字团队手册的随问随答
背景:主线的收官验收——团队手册约三万字,散布配置规程与历史故障处置记录,要求完全离线可查、回答标注出处。操作分入库与问答两段:
# 入库段(离线批处理):切块后逐段调用向量端点,向量和原文写入本地向量库 # 切块参数:每段约 400 token,相邻段重叠 50 token # 嵌入:复用 7.2 服务进程的向量端点,嵌入模型选 0.5B 级的专用嵌入模型 # 问答段:检索取前四段,组装成带规则的提示词 # 规则模板要点:只依据给定引文作答;引文没有的内容直说不知道;每句结论标注来源编号 curl 本地服务/v1/chat/completions -d '{ "messages": [ {"role": "system", "content": "依据引文回答,逐条标注来源编号,引文不足时明确说明"}, {"role": "user", "content": "引文一:……引文二:……\n问题:误删的看板如何恢复?"} ], "temperature": 0.1 }'
结果:入库三万字约两分钟(嵌入速度数千 token 每秒),单次问答的检索耗时几十毫秒、生成两三秒,回答准确并带来源编号;把手册里不存在的事实拿去问,模型按规则老实回答「引文未涉及」。解读:低温加「只依据引文」规则是抑制幻觉的关键——模型没有被赋予自由发挥的余地;出处标注则把「信不信」的判断权还给了人。变式:手册更新时只对新增与改动的片段重新入库,向量库按文档版本管理;跨文档的表格类知识效果不佳时,入库前先做结构化转写。
三、生态瞭望:你的底座站在哪里
收官之处,把这台机器放回整个生态的地图上。上游是模型与格式的供给端:模型社区里的 GGUF 发布生态与第 2 章的格式标准共生——标准开放,供给就繁荣,这是 llama.cpp 系工具链共同的护城河。同层是各类封装与前端:聊天外壳、桌面应用、第 1.3 节的 Ollama 们,它们让不同门槛的用户各取所需;你在这本教程里学到的每个参数,都是它们幕后替人做过的决定。下游是你正在搭的这些应用形态:本地助手、私有知识库、离线多模态工具——这个生态过去数年从「极客玩具」长成「部署选项」,靠的正是上游标准、中层工具、下游应用的三层互相喂养。
趋势上值得你持续关注三条线:能效与异构(5.4 节的 NPU 与后端格局仍在演化,低功耗常驻推理是新战场)、多模态深化(8.1 节的双件套模式正在吸收更多模态,本地的语音视觉处理管线日益完整)、小型模型专业化(3B 级模型在领域适配后逼近大模型的特定能力,8.2 节的适配器玩法正是它的主力引擎)。这本教程教你的不是某个版本的用法,而是那套随时可以重新对账、重新编译、重新实验的方法——生态再快,方法不老。
常见问题
检索不到该找的内容怎么办?
按顺序查三处:切块是否把答案切散(调段长与重叠)、嵌入模型对领域词汇是否敏感(换模型或补同义词)、检索数量是否太少(前四段升到前八段再看)。多数「检索失败」是切块问题。
需要专业的检索框架吗?
入门阶段不需要,向量库用轻量本地方案即可。当文档量到百万段级、需要混合检索与权限隔离时,再引入专业检索组件——届时你已经清楚每一层在做什么,替换成本很低。
RAG、长窗口、微调,私有知识到底选哪条?
按知识的变化频率分:常变的知识用 RAG(更新即入库);稳定的任务范式用 LoRA(8.2 节);知识量小到窗口装得下就直接给上下文。三者可组合,但一次实验只动一个变量。
上线前的验收清单
检索管线交付前,一份十分钟的清单能把「感觉能用」升级成「确认能用」:入库完整性——文档数与片段数对得上台账,抽样核对三段原文与向量对应无误;检索命中率——备十道已知答案的问答题,命中预期片段的不低于八成;拒答正确性——备三道库外问题,模型按规则老实承认「引文未涉及」而非编造;引用可追溯——答案里的来源编号回查得到原文;更新演练——改一段文档、重跑增量入库、验证新答案生效。清单的价值不在发现多少问题,而在把「本地知识库」从演示品变成可信资产——可信,是私有知识库相对云端方案的真正卖点。
收官三问
问:中文文档切块有什么特殊考虑?答:语义单元更细,粒度略小、重叠略增,入库前对术语做归一,命中率立竿见影。问:隐私场景下这条管线真的滴水不漏吗?答:管线内计算全部本机,但嵌入与生成模型必须来自可信来源、对外监听必须按安全基线配置——隐私是架构属性,不是默认属性。问:全册学完,最值得投入的延伸是什么?答:把本章组合产品化、跟进新架构与位宽玩法、把你的排错实录分享回社区——方法论的复利来自持续使用与持续分享。
检索质量的一手体检法
日常维护中给检索管线做体检,不需要完整评测,三个随手动作就够:随手一问——每天真用的时候留意「答案引用的段落对不对」,错引即体检报警;月末盲测——从最近一个月的真实提问里抽五条重放,看命中率有没有被新入库内容稀释;季度清库——删掉过期文档的向量并重放几条相关问题,确认「知识的退役」同样生效。知识库是活的,体检要跟着节奏走——这套动作的成本每月不到半小时,换来的是团队对库的持续信任,而信任正是私有知识库存在的全部意义。
与前章的一次总装
本节管线是全册知识的一次总装,逐处回收伏笔:嵌入调用用的是 7.2 节验证过的向量端点;提示词组装的窗口预算来自第 5 章账本;低温加规则的生成配置是 6.2 节采样纪律的落地;回答的可复现依赖 4.3 节的种子管理;入库模型的可信由 2.3 节三关校验背书。看到这里你会发现,检索增强没有引入任何「新知识」,它只是把前七章的能力按一个新问题(私有知识问答)重新编排了一遍——这种「旧能力的新编排」,正是工程与炫技的分界线。
本节要点回顾
- 检索换问题表述:不求把书装进脑子,先查到那页再读,知识库规模与窗口占用解耦;
- 管线五环节:切块、向量化、检索、组装、引用生成,嵌入与生成可共用一个服务进程;
- 防幻觉双保险:只依据引文作答的规则加低温采样,出处标注交还判断权;
- 生态三层喂养:格式标准、封装工具、应用形态,你此刻站在应用层向全栈延伸;
- 全册主线至此收官:那台旧笔记本已是多模态、可换装、通晓私知的常驻助手,而你已经握有让一切随时重跑的方法。