2.1 整体架构设计
2.1 整体架构设计
本节摘要:在终端里敲下一行
ollama run的背后,是一套"客户端—守护进程—推理后端"的三段式结构。本节沿一条请求的完整路径走一遍:CLI 如何与本地服务通信、server 如何管理模型与并发、llama.cpp 如何承担真正的张量运算,以及这套切分方式给二次开发带来了什么便利与限制。
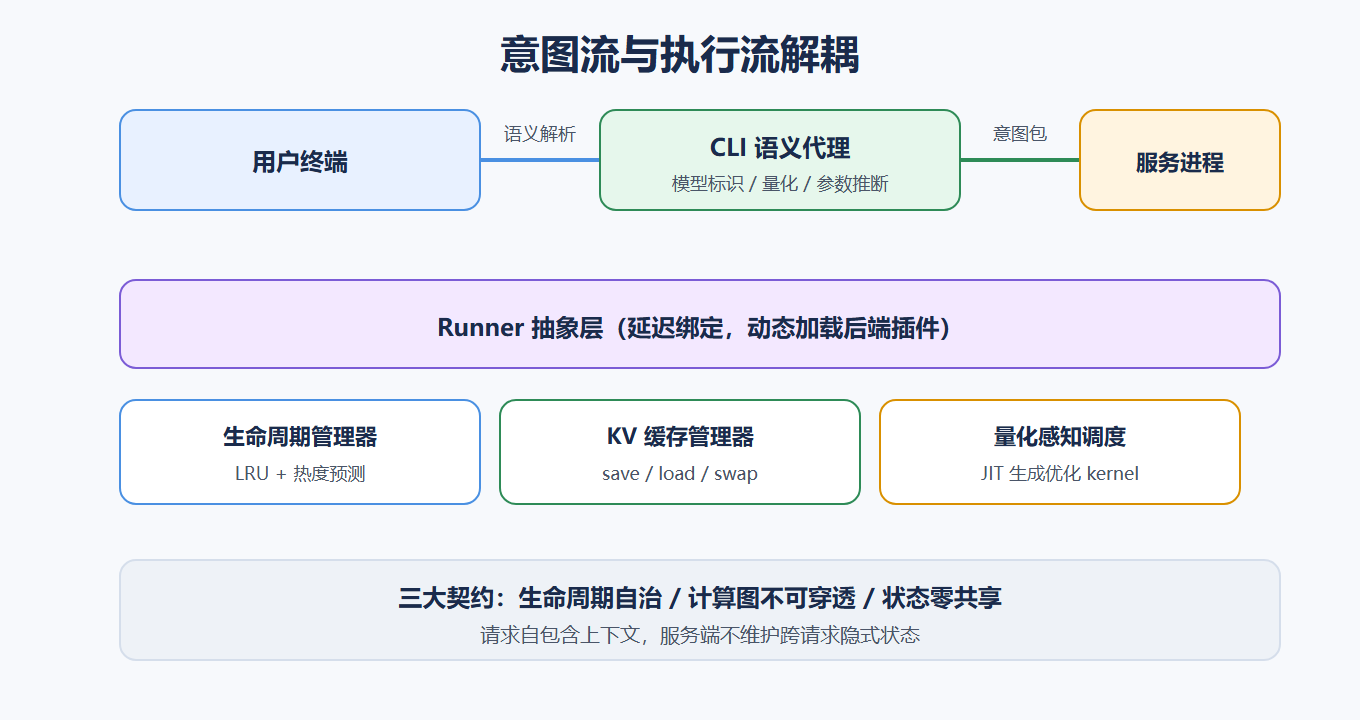
为什么装完 Ollama 会多出一个后台服务
安装脚本执行完毕后,任务栏或进程列表里会多出 ollama 或 ollama.exe,占着 11434 端口——这就是 Ollama server(守护进程)。CLI 工具 ollama 本身不做任何推理,它是一个 HTTP 客户端:ollama run、ollama pull、ollama list 最终都翻译成对本地 11434 端口的 REST 请求。把交互层和推理层拆成两个进程,是整个设计中影响最深的一个决定。
好处体现在三处。其一,模型权重只在 server 进程里加载一次,多个客户端(终端、Open WebUI、你自己写的程序)共享同一份驻留模型,不会各自复制几 GB 内存。其二,服务化让"本机跑、远程用"成为可能——把 11434 暴露给局域网,其他设备就能调用这台机器的显卡(第 7 章细讲)。其三,升级与崩溃隔离:CLI 换版本不影响正在跑的服务,服务出问题也可以独立重启。
进程关系可以直接验证:
# macOS / Linux:看服务进程与监听端口 ps aux | grep -i ollama lsof -i :11434 # Windows PowerShell Get-Process ollama* Get-NetTCPConnection -LocalPort 11434 # 服务是否在岗,最直接的办法 curl http://localhost:11434/ # 正常应答: "Ollama is running"
拆开看:三个部件各管什么
第一层是入口工具集。ollama run / serve / pull / push / create / ps / show 这组命令面向人,负责把意图变成请求。ollama run 还内置了一个简单的 readline 会话,支持 /bye 退出、/show info 查看模型参数、/set system 临时改系统提示词、/clear 清空上下文——这些斜杠命令只存在于 CLI,API 调用方看不到。
第二层是Ollama server。它承担四类职责:接收并校验 REST 请求(/api/generate、/api/chat 等);维护模型注册表与 blobs 存储;决定加载哪个模型、何时卸载、并发请求如何排队;把推理任务连同运行参数(温度、top_p、层数分配、上下文长度)下发给后端。它不碰矩阵运算。
第三层是推理后端。Ollama 把 llama.cpp 以库的形式编进服务,另为 AMD、Intel 等硬件准备了对口后端。每个已加载模型对应一个后端实例,实例持有 mmap 映射的权重、KV 缓存和 CUDA/Metal 上下文。server 与后端之间按请求粒度交互,层的分配、显存池都由后端实例自理。
跟踪一次请求的完整旅程
以 ollama run qwen2.5:7b "解释一下 mmap" 为例。CLI 先向 /api/generate 发 POST,携带模型名、prompt 和默认选项。server 查注册表:模型未加载,就从 blobs 取出 GGUF,创建后端实例,权重经 mmap 映射、按探测结果分层——这个过程就是首条请求慢十几秒的原因。加载完成后,后端先跑预填充,把 prompt 全部算进 KV 缓存,然后进入解码循环,每生成若干 token 就把增量文本推回给 CLI。
流式返回靠的是 HTTP chunked 分块。用 curl 裸调一次接口,能直观看到"每个 JSON 对象装一小段增量"的节奏:
curl http://localhost:11434/api/generate -d '{ "model": "qwen2.5:7b", "prompt": "一句话说明什么是内存映射文件", "stream": true }' # 逐行返回,形如: # {"model":"qwen2.5:7b","response":"内存","done":false} # {"model":"qwen2.5:7b","response":"映射是","done":false} # ... # {"model":"qwen2.5:7b","response":"","done":true, # "done_reason":"stop","eval_count":42,...}
末尾那条 done: true 的记录附带了完整的统计字段:total_duration(端到端耗时)、prompt_eval_count 与 prompt_eval_duration(预填充 token 数与耗时)、eval_count 与 eval_duration(生成 token 数与耗时)。拿 eval_count / eval_duration × 10^9 就得到每秒输出 token 数——第 5 章的性能诊断完全建立在这组数字上。
会话是这套流程里最容易被误解的部分。Ollama server 不保存对话历史。ollama run 的交互界面把历史记在本地会话里,每次提问都把整段上下文重新发给服务;API 调用方则要自己在 messages 数组里维护历史。也就是说,上下文长度限制约束的是"你每次发过来的总量",服务端没有任何跨请求记忆。ollama ps 里看到的 SIZE 随对话变长而增长,增长的是 KV 缓存,不是存储了聊天记录。
这套设计对开发者意味着什么
对二次开发而言,三段式的边界就是接入点。想给现有系统加大模型能力,不需要嵌入任何 SDK——任何能发 HTTP 的语言都是一等公民,甚至 shell 脚本就够。想让团队共用一台 GPU 机器,只需要一台跑着 server 的主机加一条 OLLAMA_HOST 配置。想做模型管理自动化,/api/tags、/api/pull、/api/delete 提供了完整闭环。
import requests # 列出服务端已有的模型 r = requests.get("http://localhost:11434/api/tags") for m in r.json()["models"]: print(m["name"], m["size"] // 1024**3, "GB") # 查看当前驻留(加载中)的模型与占用 for m in requests.get("http://localhost:11434/api/ps").json()["models"]: print(m["name"], m["size_vram"] // 1024**3, "GB in VRAM, expires", m["expires_at"])
限制同样来自这个结构。server 单进程串行化了对同一模型的解码请求——并发 10 个用户同时生成时,请求会在队列里排队逐个执行,吞吐并不随并发线性增长;真正的横向扩容要靠多实例(第 7.3 节的容器化方案)。另外,CLI 与 server 版本必须匹配,升级后若行为异常,先确认两端是否为同一版本,再查日志(journalctl -u ollama 或 ~/.ollama/logs/server.log)。
排障时记住口诀:先 curl 探活,再看 ollama ps 问加载,最后翻 server 日志找 GPU 探测与 OOM 记录。三个部件、两个排查界面(CLI 与 REST),这就是 Ollama 架构的全部骨架——下一节往骨头里看:量化、KV 缓存与调度这些"关键技术机制"具体如何运转。