第2章 核心架构与技术原理
第 2 章 · 核心架构与技术原理
章节摘要:这一章回答"它凭什么能做到"。我们会拆开那层漂亮的命令行表皮,看三个关键机制:整体上 CLI 与服务进程如何分工、谁在管模型生命周期;GGUF 格式如何把模型变成"可被硬件直接阅读的语义协议"、统一内存架构和动态调度如何让多模型共存;以及在 macOS、Linux、Windows 三套完全不同的硬件生态上,Ollama 靠什么保证同一个模型行为一致。读完本章,你会建立"意图代理 + 受控执行体"的架构心智,而不是把它当黑盒。
本节地图
阅读完本章,你应当能够:
- 描述 Ollama 的 C/S 分工:CLI 是语义代理,
ollama serve是受控执行体 - 解释 GGUF 的三重语义(结构、数值、硬件)与分块量化原理
- 说清统一内存架构(UMA)的热区/温区/冷区分层思路
- 理解动态调度器如何处理多模型并存的资源分配
- 说出跨平台一致性靠什么保证(UDAL 契约 + UMEP 确定性约束)
核心概念速览
金句:Ollama 的 C/S 不是网络通信范式,而是认知分工范式——CLI 负责把意图翻译成结构化请求,服务进程负责在硬件约束下把请求跑得稳、跑得省。
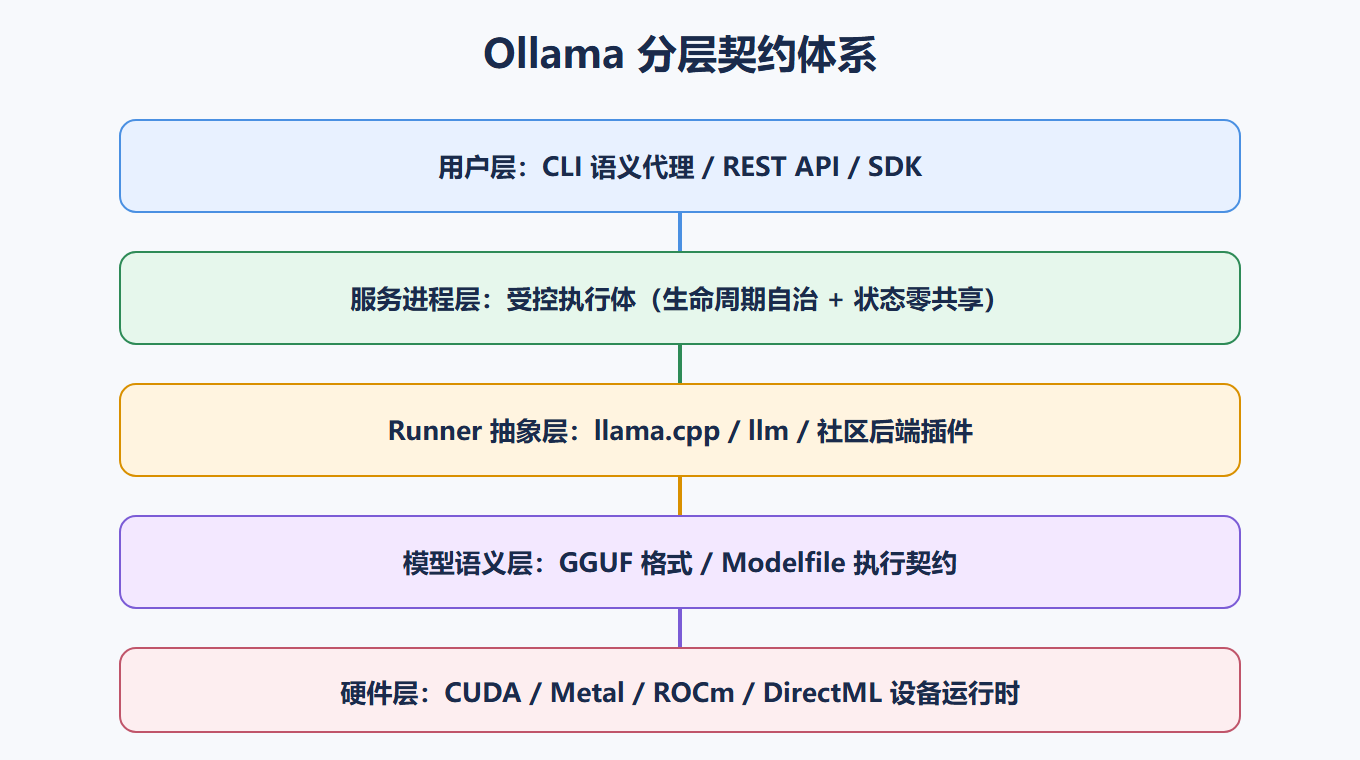
分层契约透视
子章节导航
2.1 整体架构设计
拆解"意图代理 + 受控执行体"的分工,讲解 Runner 抽象层、生命周期管理器、状态零共享三条核心契约,以及 CLI 与 REST API 如何共享同一套语义契约。
2.2 关键技术机制
深入到让模型"跑得动、跑得稳"的三个机制:GGUF 格式的语义封装、统一内存架构的三层分级、动态调度器的三层博弈。
2.3 跨平台支持原理
讲清 macOS(Metal)、Linux(CUDA/ROCm)、Windows(WSL2/DirectML)三套后端如何通过统一设备抽象层与统一模型执行协议实现行为一致。
子章节之间的逻辑关系
2.1 骨架:谁指挥谁 ──► 2.2 器官:怎么跑得快 │ ▼ 2.3 免疫:跨平台怎么一致
先有整体分工,再谈具体机制,最后看这套机制如何在不同硬件上保持同一张脸。三者是递进关系:架构决定了机制生长的边界,机制决定了跨平台承诺能否兑现。
一个容易误判的点
许多人学架构时会陷入"堆术语"的误区:听到 Runner 抽象层、KV Cache、UMA 这些词,就急着背定义。其实这一章的核心只有一个问题:一条 ollama run 命令,从按下回车到看到第一个 token,中间经历了什么? 把这个链条想清楚,所有术语都只是链条上的环节。建议你边读边在终端反复执行 ollama run,配合 ollama ps 观察服务进程的加载过程,让"命令-进程-后端"的对应关系变得具体。第 2.2 节的 UMA 和动态调度看起来很抽象,但你只要记住它们的价值主张——"让模型在有限硬件上跑得动、多个模型同时跑互不干扰"——具体机制读不懂也不影响使用。真正的工程取舍在第 5 章讲性能时才会用到,到时可以回来精读。
为什么这一章值得花时间
如果说第 1 章是"会用",这一章就是"懂得"。用过一阵子 Ollama 的人都会遇到这类问题:为什么换台机器同样的模型表现不一样?为什么同时跑两个模型会互相拖慢?为什么 Windows 上比 Linux 慢?答案都藏在本章。理解架构后,你排查问题的思路会从"瞎试参数"变成"定位环节"——知道问题出在加载、调度还是平台层,解决方向就清楚了。这也是第 5 章性能调优和第 7 章生产部署的地基,跳过它,后面两章读起来会很吃力。
这一章和别的工具的关系
Ollama 的架构设计并非孤例。vLLM 的 PagedAttention、llama.cpp 的量化内核、MLX 的统一内存,都在解决类似问题,只是侧重点不同。读本章时如果能顺手了解一下这些邻居,你对"本地推理为什么难"的理解会更立体——Ollama 的优势不是发明了这些机制,而是把它们整合进一个对开发者友好的统一入口。这也是第 1 章"定位取舍"的延续:架构层面的每一个选择,都在服务"开发者原生体验"这个总目标。
架构要点速查
| 机制 | 回答的问题 | 一句话概括 |
|---|---|---|
| 意图代理 + 受控执行体 | 谁指挥谁 | CLI 翻译意图,服务进程受控执行 |
| GGUF 格式 | 模型怎么被读懂 | 结构/数值/硬件三重语义封装 |
| 统一内存架构 | 知识怎么存放 | 热区 GPU、温区 RDMA、冷区 SSD |
| 动态调度 | 行为怎么规划 | 宏观管生命周期,微观管执行路径 |
| 跨平台契约 | 各平台怎么一致 | UDAL 定能力,UMEP 定确定性 |
⚠️ 常见误区:把架构知识当"背概念"。这一章的所有机制,最终都服务于一个可验证的事实——同样的命令在不同机器上给出同样的结果。遇到"换机器结果不一样"的问题,回来对照本章找原因,比瞎试参数高效。
💡 关键直觉:GGUF 之于 Ollama,相当于镜像层之于 Docker——它是"模型即文件"这一承诺的物理载体。理解了 GGUF 为什么是自描述的,你就理解了 Ollama 为什么能一键跑模型。
前置知识与后续延伸
- 前置知识:第 1 章的"模型即文件、推理即服务"心智;对 HTTP 请求有基本概念即可
- 后续延伸:第 3 章讲模型生命周期会用到本章的存储与加载机制;第 5 章讲性能调优时,UMA 分层和动态调度是调参的理论依据
读完本章你应该能回答的问题
本章结束时,试着用自己的话回答下面几个问题:为什么同一个 GGUF 文件在不同硬件上加载方式完全不同?为什么 16GB 内存的机器能同时跑好几个模型而传统方式早 OOM 了?为什么 WSL2 里跑 Ollama 性能和原生 Linux 差别不大?如果都能说个大概,说明你真正理解了本章的骨架——CLI 负责翻译意图,服务进程负责受控执行,GGUF 负责表达语义,UMA 负责存放知识,调度器负责规划行为,跨平台契约负责让这一切在不同硅片上保持一致。答不上来也没关系,先把问题记下来,读完第 3-5 章再回来看,很多疑问会自然解开。
阅读节奏建议
第 2.1 节是本章最值得精读的部分,它决定了你对整个工具工作方式的理解;第 2.2 节的 UMA 和调度如果觉得吃力,可以先只记结论(分层存放、多模型协调)跳过推导;第 2.3 节对你当前使用的平台(macOS 或 Windows 或 Linux)重点读对应小节即可,其他平台扫一遍了解差异。这样既不影响主线理解,也避免在细枝末节上消耗过多精力。