2.3 跨平台支持原理
2.3 跨平台支持原理
本节摘要:同一份 Ollama 在 macOS、Linux、Windows 上体验几乎一致,靠的不是写三套代码,而是"Go 静态编译 + llama.cpp 后端抽象 + 各平台加速 API"的三明治结构。本节拆解各平台的 GPU 路径与差异点、日志与排查入口,最后总结跨平台一致性的设计要义。
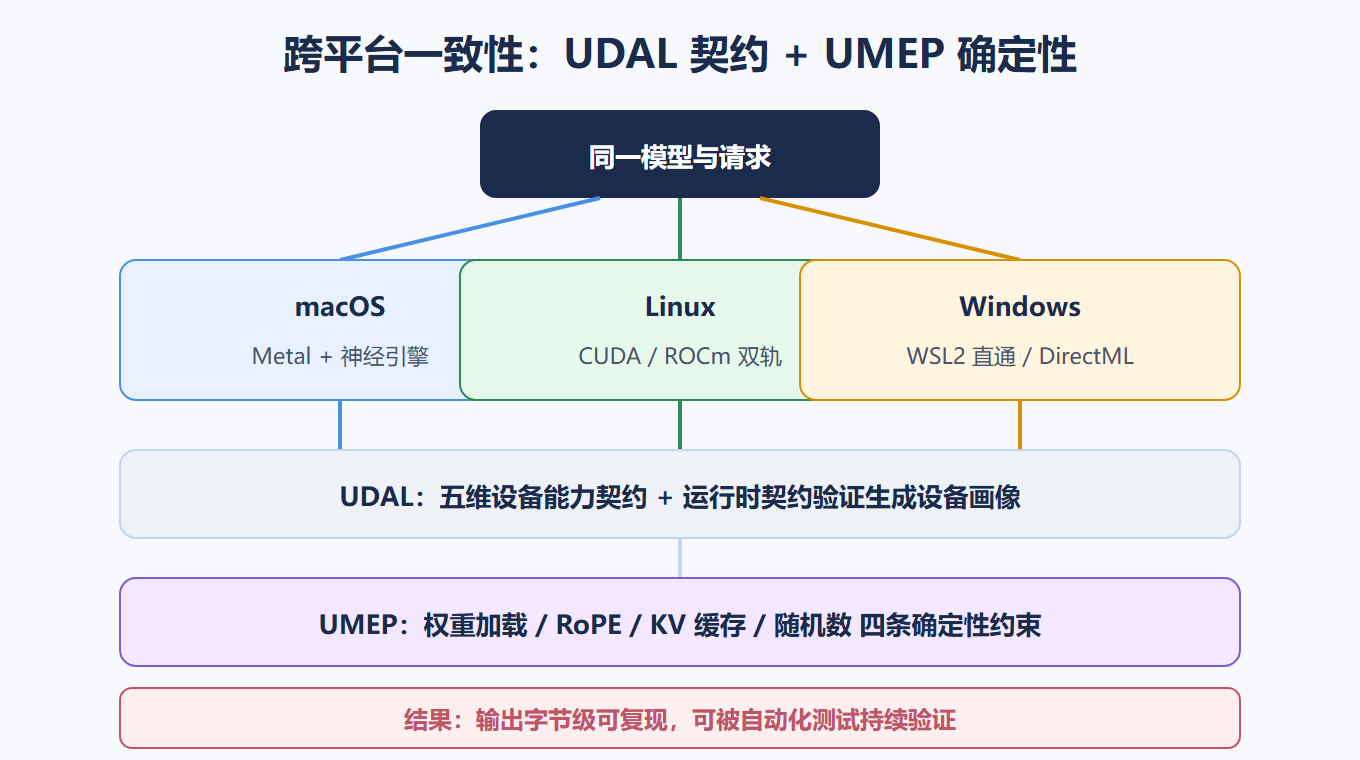
三明治结构:一层抽象吃下三个平台
最上层是 Ollama 本体,用 Go 编写,编译为不依赖动态库的单个可执行文件——这一层从源头消灭了"装环境"问题。中间层是内嵌的 llama.cpp 及其派生后端,按平台编译成动态库,暴露统一的推理接口。最下层是各平台的加速 API:Apple 的 Metal、NVIDIA 的 CUDA、AMD 的 ROCm、Intel 的 oneAPI/SYCL,以及任何平台都有的 CPU SIMD 路径。运行时按优先级探测:有 GPU 就走加速路径,探测失败自动回落 CPU,服务不会因缺驱动而拒绝启动。
# 三平台统一的验证方式:看日志里的设备探测结果 # macOS cat ~/.ollama/logs/server.log | grep -i metal # Linux (systemd) journalctl -u ollama | grep -iE "cuda|rocm|offload" # Windows(默认标准输出,需手动运行 ollama serve 或看 %LOCALAPPDATA%) ollama serve # 控制台直接观察启动日志
macOS:Metal 与统一内存的顺路
Apple 平台是 Ollama 体验最"无感"的系统:Metal 驱动系统预装、统一内存让显存容量问题消失,服务起来就能用,无需装任何驱动。日志中 offloaded 28/28 layers to GPU 表示全层进了 GPU。Apple Silicon 上默认还允许多达 3 个模型同时驻留(其他平台默认 1),正是统一内存带来的底气。Intel Mac 也能跑,但走 CPU 路径,7B 模型约几个 token/s,属可用不舒适。
Linux:路径最多,坑也最多
Linux 是后端最丰富的平台,也是唯一需要自己装驱动的平台。NVIDIA 卡装官方驱动与 CUDA runtime(Ollama 发行包自带所需库);AMD 卡走 ROCm,官方支持列表覆盖 RX 6700 以上与大部分 7000 系列,环境变量可以显式指定卡号(HSA_OVERRIDE_GFX_VERSION 与 OLLAMA_VISIBLE_DEVICES);Intel 显卡与 Arc 系通过 IPEX/SYCL 后端实验性支持。多卡场景默认全用,OLLAMA_VISIBLE_DEVICES 能限定只用某几张。
# 指定用 0 号与 2 号卡 OLLAMA_VISIBLE_DEVICES=0,2 ollama serve # 无头服务器上以服务方式常驻 sudo systemctl enable --now ollama
Windows:从"能跑"到"好用"
Windows 的演进最能体现跨平台工作:早期依赖旧版 MSVC 运行库与手动安装,现在安装器一键到位;GPU 支持覆盖 NVIDIA(CUDA)与 AMD(ROCm),Copilot+ PC 上的 NPU 支持也在路线图上。两个高频问题值得记录:服务由托盘应用拉起,改环境变量后必须退出托盘图标再重开(仅重启终端无效);模型默认在 C:\Users\<你>\.ollama,挪到大盘用 OLLAMA_MODELS。
# 验证 GPU 是否被用上 Get-Content "$env:LOCALAPPDATA\Ollama\server.log" | Select-String "cuda|offload" ollama ps # SIZE 与 SIZE_VRAM 相等说明全层在显存
一致性的代价与回报
把三平台体验对齐,靠的是"差异全部下推到后端层":CLI、REST API、Modelfile、模型文件在三个系统上完全一致,~/.ollama 目录结构与参数语义也一致——迁移机器只需拷目录。回报是生态工具(8.1 节的那些前端)只需对接一套接口就能覆盖所有平台用户。代价同样存在:新加速特性要等各后端分别成熟才能暴露(例如 Flash Attention 的落地就分了先后);平台特有能力(如 Metal 的某些专用优化)被抽象层抹平,追求极限性能的用户最终仍会转向原生 llama.cpp。
跨平台排障的通用套路
三个平台的差异最终都会体现在同一处——server 启动日志的前几十行。培养"先读日志再搜索"的习惯,能省掉大量盲试:日志会明确写出探测到的后端类型、GPU 型号、分配方案,探测失败时也会给出原因(驱动版本、显存不足、权限问题)。把"日志前三十行 + 版本号 + 硬件型号"这三样凑齐,再去 issue 区检索,命中率远高于只描述症状。
另一个跨平台通用的事实是:CPU 回落永远存在。任何平台 GPU 探测失败,服务都不会罢工,而是悄悄退回 CPU——症状是"能跑但很慢"。因此判断"GPU 到底用上没有"不能凭感觉,要用 ollama ps 的两列大小对比(5.2 节的方法)或日志里的 offload 行数来确认。把这条写进团队的部署验收单,能拦住大半"上线才发现跑在 CPU 上"的事故。顺带一提,三平台的模型目录、环境变量语义、Modelfile 语法完全一致,这让"开发在 Mac、部署在 Linux、老板用 Windows"的混合团队不必维护三套文档,一套手册走天下。跨平台一致性的最后一个受益者是自动化脚本:CI 里写的冒烟测试在三种开发机上无需修改即可执行,运维心智负担被压到最低。
架构篇到此收束。接下来一章聚焦"模型本身":从哪里获取、如何存储、怎样用 Modelfile 定制成自己的私有模型。