第3章 模型生命周期管理
第 3 章 · 模型生命周期管理
章节摘要:这一章讲模型从"下载下来"到"变成自己的"的完整过程。先讲模型怎么获取与存储——
ollama pull不是简单下载,而是一次带哈希校验的分层拉取;本地存储也不是一个 GGUF 文件,而是一个内容寻址的对象存储。再讲 Modelfile——用几行声明式语法,你就能给模型注入系统提示、调参、挂 LoRA 适配器,做出一个带专属人格的定制模型。读完本章,你会明白为什么说"模型在 Ollama 里是一等公民"。
本节导航
阅读完本章,你应当能够:
- 用
ollama pull、list、remove管理本地模型,并解释各自背后的机制 - 描述本地存储的目录结构与 manifest 的双重真相
- 理解分层镜像与引用计数如何实现"秒级模型衍生"
- 用 Modelfile 的 FROM/PARAMETER/SYSTEM/ADAPTER 等指令构建自定义模型
- 读懂量化类型表,按场景选择 Q4_K_M、Q5_K_M 或 Q8_0
- 理解 Modelfile 作为"可执行的治理契约"在合规场景的价值
核心概念速览
金句:模型不是被部署一次就静默运行的黑盒,而是一个需要被孕育、被演进、被安顿的数字生命体——Ollama 用一套生命周期管理给了它身份、谱系与契约。
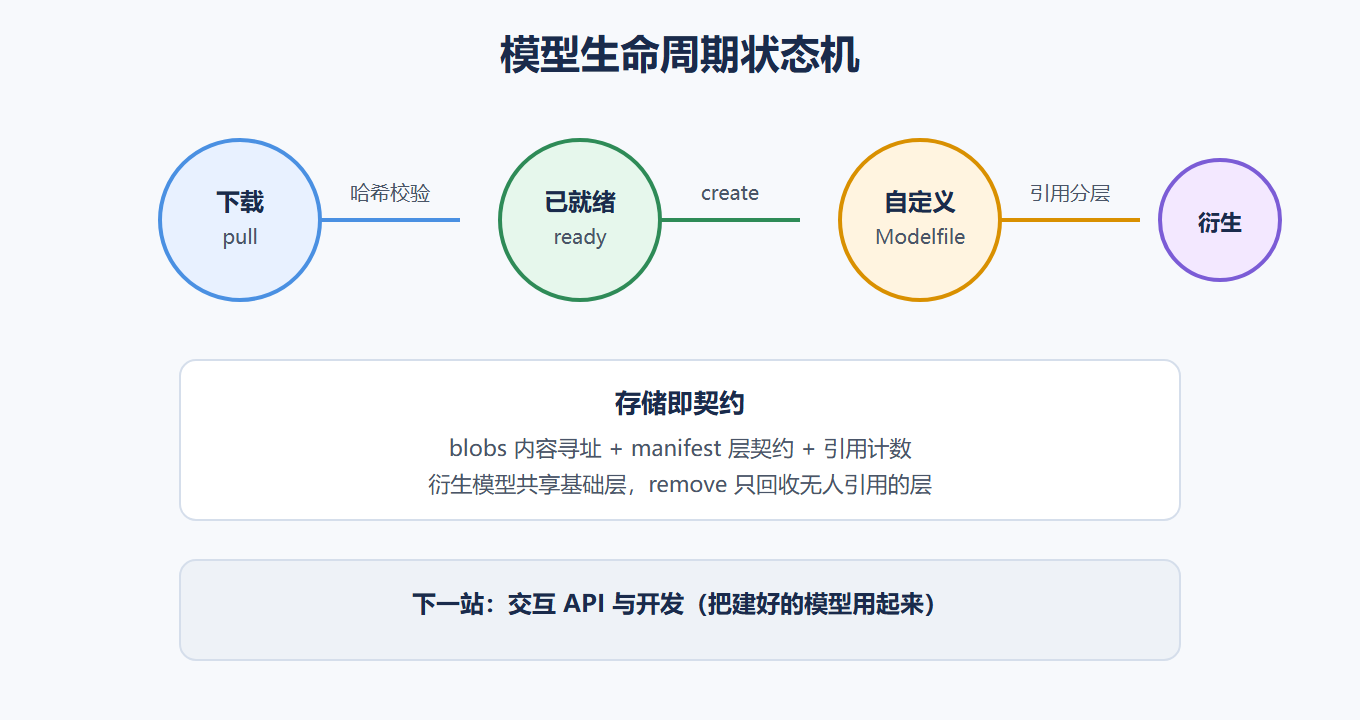
模型生命周期状态机
三个让你眼前一亮的细节
这一章有几个反直觉的设计,提前预告:第一,ollama remove 删一个模型,可能只删了几百 KB——因为大部分权重层被其他衍生模型共享着,引用计数不归零就物理保留;第二,从 llama3:8b "衍生"一个微调版只需要毫秒级时间——因为没复制任何权重,只是织了一条新的引用关系;第三,同一个基础模型可以挂多个 LoRA 适配器,运行时候用 --adapter 参数实时切换,而基础权重保持不动。这些设计都来自"内容寻址 + 分层引用"这套存储哲学,读完 3.1 你会理解它们不是魔法而是工程。
子章节导航
3.1 模型获取与存储
pull 的三阶段原子操作、manifest 的层结构、内容寻址存储与引用计数回收,以及增量更新如何让"秒级模型衍生"成为可能。
3.2 Modelfile 自定义模型
Modelfile 的本质与指令集、外部模型导入的三阶段流程、量化选择矩阵,以及它如何成为企业模型治理的第一道闸门。
子章节之间的逻辑关系
3.1 模型怎么来、存在哪 ──► 3.2 怎么变成自己的 │ │ ▼ ▼ 存储即契约 声明即治理
先有可靠的获取与存储底座,才有在其上做自定义的前提。3.1 建立的"内容寻址 + 分层引用"心智,在 3.2 理解 LoRA 增量构建和量化选择时会反复用到。
这一章解决的真实问题
模型生命周期管理解决的是"模型的混乱":团队里十个人各自下载了不同版本的模型,磁盘被占满,谁都不清楚某个模型是从哪个基础模型衍生来的,更说不清它的许可证是什么。第 3.1 节的存储设计——内容寻址、分层引用、引用计数——正是对抗这种混乱的结构性方案:每个文件有哈希身份,多个衍生版本共享底层权重,删除一个版本不会误删被共享的层。第 3.2 节的 Modelfile 则把"版本从哪来"变成可声明的:一个文件描述清楚来源、参数、系统提示、许可证,ollama create 一键构建。这两节合起来回答的是同一个问题:怎么让模型像代码一样被管理。
一个容易误判的点
有人觉得"反正我只需要 ollama run llama3,为什么还要学 Modelfile 和存储结构?"这种想法短期没错,但一旦你要做三件事,本章就绕不过去:一是给模型加定制人格或约束(不改权重,只改行为);二是管理多个微调版本并随时切换;三是把模型打包带到离线环境或交付给同事。这三件事在真实工作中几乎必然遇到。退一步说,即使不做这些,理解"模型存储在哪里、为什么不能手动删文件"也能避免许多低级故障——比如误删共享层导致模型无法加载。
一个贯穿的动手实验
学完本章建议做一个完整实验:用 ollama pull 拉一个基础模型,写一个带 SYSTEM 角色设定的 Modelfile,ollama create 出定制模型,ollama list 看两者关系,ollama show 看量化与上下文信息,最后 ollama remove 删除定制版本并确认基础模型不受影响。这个实验把 3.1 与 3.2 的知识全部串起来,做完你会对"模型生命周期"有实实在在的体感,而不是停留在概念上。
生命周期要点速查
| 环节 | 命令 | 核心机制 |
|---|---|---|
| 获取 | pull | manifest 解析 + 哈希校验 |
| 查看 | list / show | 读本地 SQLite + 元数据 |
| 自定义 | create | Modelfile 声明式构建 |
| 复用 | create 衍生 | 分层引用 + 增量差量 |
| 清理 | remove | 引用计数归零才删除 |
⚠️ 常见误区:把
ollama create理解成"重新训练"。它不碰任何权重,只是按 Modelfile 编织一份新的"模型说明书"(引用基础层 + 注入参数与提示)。训练是别的工具的事,这里只做组装。
💡 关键直觉:
ollama list里每个模型都是一个"身份"——带哈希、带谱系、带许可证。你管理的不是文件,是模型的出生证与成长册。
前置知识与后续延伸
- 前置知识:第 2 章 GGUF 格式与 mmap 加载原理
- 后续延伸:第 4 章 CLI 和 API 是对本章建好的模型做交互;第 5 章硬件调优会用到量化选择与显存占用估算
读完本章的验收标准
三件事。第一,你能不看文档说清楚 ollama pull 和直接下载一个 GGUF 文件有什么本质区别(答案:前者是带哈希校验的分层镜像构建,后者只是拷了个文件)。第二,你能徒手写一个最简单的 Modelfile——至少包含 FROM 和 SYSTEM 两行,知道它们各自的作用。第三,你知道 ollama remove 为什么比手动删文件安全(答案:引用计数保证共享层不被误删)。三个都过,本章就算掌握了。
一些提个醒的事
模型许可证很容易被忽略,但对商用场景是硬约束。拉模型前看一眼它的许可条款(Modelfile 的 LICENSE 字段或模型库页面),确认允许商用、允许修改、是否有衍生品条款。第 3.2 节提到的治理机制就是为这类合规需求准备的。另外,磁盘占用问题也很现实:几个 8B 模型动辄十几 GB,ollama list 会显示每个模型的大小,定期清理不用的版本是个好习惯——用 ollama remove 而不是手动删目录。