第5章 硬件与性能调优
第 5 章 · 硬件与性能调优
章节摘要:同一个模型,为什么别人的笔记本跑得飞快、你的却卡成幻灯片?这一章解决"硬件到底够不够、性能瓶颈在哪、怎么调"。先讲硬件需求分析——显存公式、内存带宽的角色、CPU 在推理里的隐藏职责,帮你从"显存够不够"的思维里跳出来;再讲性能监控与诊断——TPS 这个复合指标怎么读、ollama ps 的字段藏着什么信息、swap 和 IO 是怎么悄悄拖垮性能的;最后讲进阶调优——预加载、并发调度、显存卸载三个策略怎么协同。读完本章,你能为自己的机器定制合理的配置。
本节地图
阅读完本章,你应当能够:
- 用显存公式估算任意模型在指定上下文下的显存需求
- 说清 CPU、内存带宽、GPU 显存三者各自的瓶颈特征
- 解读
ollama ps的核心字段与诊断线索 - 识别 swap 干扰与 IO 瓶颈的典型信号
- 理解预加载、并发调度、显存卸载三大调优策略的协同关系
- 为自己的硬件选择合适的量化档位与上下文长度
核心概念速览
金句:硬件需求不是一张静态参数表,而是推理引擎在初始化阶段必须求解的一组约束方程——Ollama 的工作是在不完美的硬件里找最优可行解,而不是假设硬件完美。
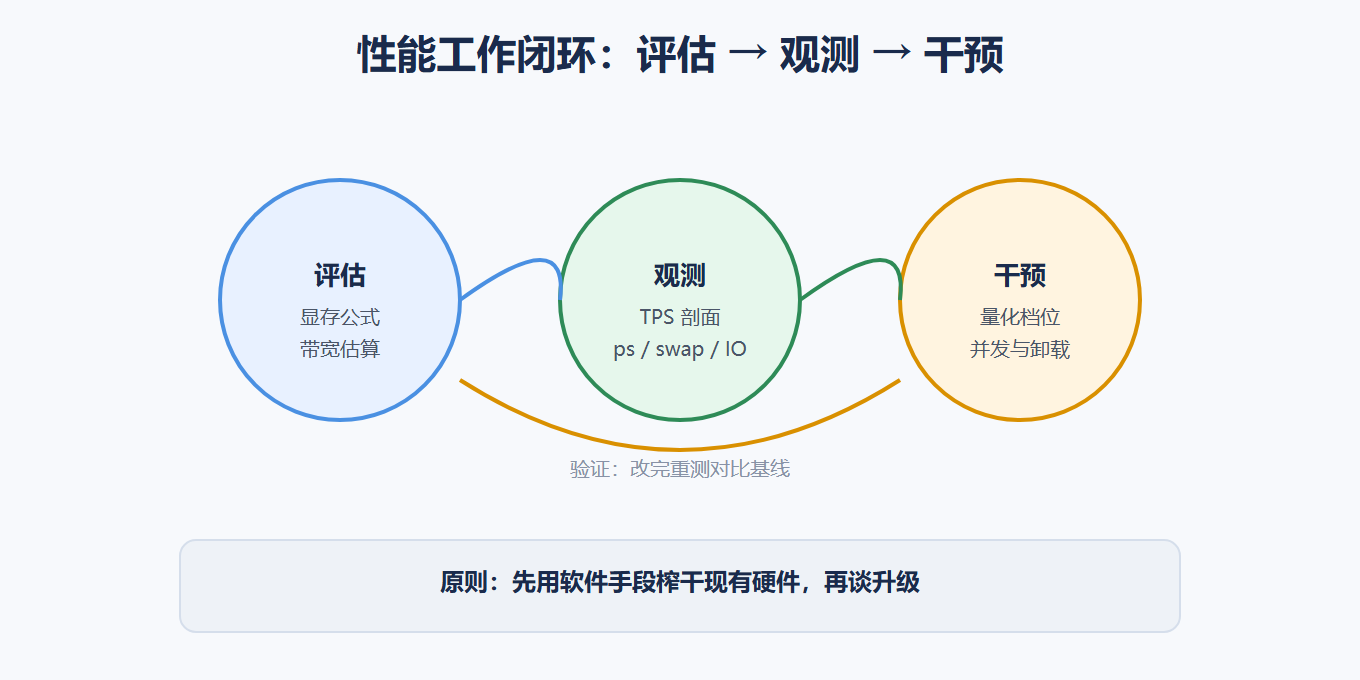
评估-观测-调优闭环
子章节导航
5.1 硬件需求分析
从资源清单到计算契约:CPU 的隐藏职责、内存带宽的三重压力、显存的容量-带宽-代际三角博弈,以及多卡场景的 MoE 切分思路。
5.2 性能监控与诊断
TPS 的复合语义、ollama ps 的深层字段、swap 的灾难成本、IO 限制的隐蔽表现,以及"监控-建模-干预-验证"的飞轮方法。
5.3 进阶调优策略
预加载的语义分层驻留、并发的拓扑感知调度、显存卸载的差异化策略,三者如何构成闭环的资源控制律。
子章节之间的逻辑关系
5.1 需要什么 ──► 5.2 实际什么情况 ──► 5.3 怎么调整
先有需求基线,才能谈监控诊断;诊断出瓶颈,调优才有靶点。三节构成完整的闭环:评估 → 观测 → 干预。
这一章解决的真实问题
"模型能跑"和"模型跑得舒服"是两回事。你拉下一个 8B 模型,回车后半天不出字;或者对话稍长就报显存不足;或者同时开几个对话互相卡死。这些问题的根源往往是同一个:没搞清楚你的硬件边界在哪,以及怎么在边界内做取舍。第 5.1 节帮你算清楚——这个模型在我的显存里到底能不能装下、上下文能开多长、瓶颈在带宽还是算力;第 5.2 节帮你看清楚——跑起来之后慢在哪、是 swap 在作祟还是 IO 在拖后腿;第 5.3 节帮你调清楚——预加载哪些层、并发怎么分片、显存不够时卸载什么。三节合起来,就是"让模型适配你的机器"而不是"让你的机器被模型拖垮"。
一个容易误判的点
很多人以为性能问题只能靠"换硬件"解决,于是一上来就研究买什么显卡。但多数场景的瓶颈不在硬件绝对性能,而在配置不当:上下文开得太大导致 KV 缓存爆掉、并发开太多导致显存碎片化、swap 没关导致权重页被换出。这几类问题,靠调整量化档位、上下文长度、并发策略就能解决大半,一分钱不用花。所以本章的立场是:先用软件手段榨干现有硬件,再谈升级。这也是为什么"评估 → 诊断 → 调优"的顺序如此重要——跳过诊断直接调参,等于蒙着眼睛拧螺丝。
阅读策略
第 5.1 节适合在下载大模型前读——先用公式算算你的显存能不能撑起目标上下文,避免下载后才发现跑不动。第 5.2 节更像排查手册,遇到卡顿时再回来看对应小节,不必一次读完。第 5.3 节是进阶内容,普通使用可以先只记三个结论:模型可以分层预加载、并发要分片、显存不够时优先卸载权重而不是激活。三个结论足够覆盖日常 90% 的场景,深层的推导等你真遇到性能瓶颈再精读。
调优目标速查
| 场景 | 首选动作 | 兜底动作 |
|---|---|---|
| 模型加载慢 | 关 swap、留显存余量 | 换更快的存储 |
| 首 token 慢 | 检查前处理与 IO | 调整预加载策略 |
| 长对话变慢 | 检查 KV 缓存与上下文 | 缩小上下文或量化 |
| 并发卡顿 | 控制并发上限 | 分片调度 |
⚠️ 常见误区:性能差就换显卡。多数问题的根因是配置不当(swap、上下文过大、并发失控),先诊断再花钱。
💡 关键直觉:推理大多是"带宽受限"而非"算力受限"——模型权重必须逐 token 读取。所以量化省的不只是空间,更是带宽,这才是它提速的根本原因。
前置知识与后续延伸
- 前置知识:第 2 章 UMA 三层分级与动态调度;第 3 章量化类型表
- 后续延伸:第 6 章 RAG 和 Agent 的并发场景会用到本章的并发与资源策略;第 7 章生产部署的服务容量规划依赖本章的显存估算
读完本章的验收标准
三件事。第一,给你一个模型名和硬件配置,你能估算出它能不能跑、能开多长上下文——用 5.1 的公式。第二,模型跑得慢时,你能说出至少三种排查方向(swap、IO、并发)并知道各自用什么命令看——用 5.2 的诊断方法。第三,你至少动手做一次调优实验:调一个量化档位或上下文长度,对比前后速度,把结果记下来——用 5.3 的思路。做满三件,性能这块就不只是"看过"而是"用过"了。
一些提个醒的事
硬件相关的环境变量(比如显存上限、加载模型数上限)在官方文档里有明确说明,改之前先确认它对你当前版本生效,别照着旧教程乱设。另外,性能调优的目标不是"把参数调到极致",而是"让使用体验可接受"——花一小时把首 token 延迟从 900ms 压到 600ms,可能不如直接换个更合适的量化档位来得实在。把时间花在刀刃上。