1.2 三十年演进的三次范式跳跃
1.2 三十年演进的三次范式跳跃
本节摘要:MIMO 的三十年不是一条平滑的性能曲线,而是三次不连续的认知跳跃:第一次把多径从敌人改判为资源,第二次把开环发射改成依赖信道信息的闭环发射,第三次把天线数量推到让统计规律接管的量级。每一次跳跃都是被上一代的瓶颈逼出来的,看清这条因果链,后面的标准演进就不需要死记。
本节目标
阅读完本节,你应当能够:
- 说出三次范式跳跃各自解决的核心矛盾,以及被牺牲掉的代价
- 解释空时分组码为什么在没有信道反馈的条件下也能拿到分集增益
- 说明分层空时结构为什么必须依赖接收端的多天线数量
- 复述从 LTE 早期版本到 5G NR 的关键能力节点,并把每个节点对应到某次跳跃
- 判断一项新的多天线技术属于哪一代思路的延伸
一、起点:一个被当作噪声的信号
上世纪九十年代初,无线工程师面对多径的标准反应是"抑制"。均衡器、扩频、交织编码,所有手段的目标都是把多径的影响压平,让信道尽量像一根理想管道。这套思路自成体系,也确实撑起了第二代移动通信。
转折出现在贝尔实验室。一批研究者做了一件当时看起来离经叛道的事:他们不去消除多径,而是问"如果多径本来就带着可用的信息呢"。数学上这件事说得通——如果多条路径的衰落彼此独立,那么多根接收天线上的观测值就构成了一组线性无关的方程,方程数量足够时就能解出多个未知的发射符号。信道从"传输介质"变成了"编码器"。
这个认知转向的分量,怎么强调都不过分。它意味着:信道本身并非需要被驯服的敌人,而是可编程、可编排、可赋形的资源。之后三十年的技术演进,本质上都是在把这句话兑现得更彻底。
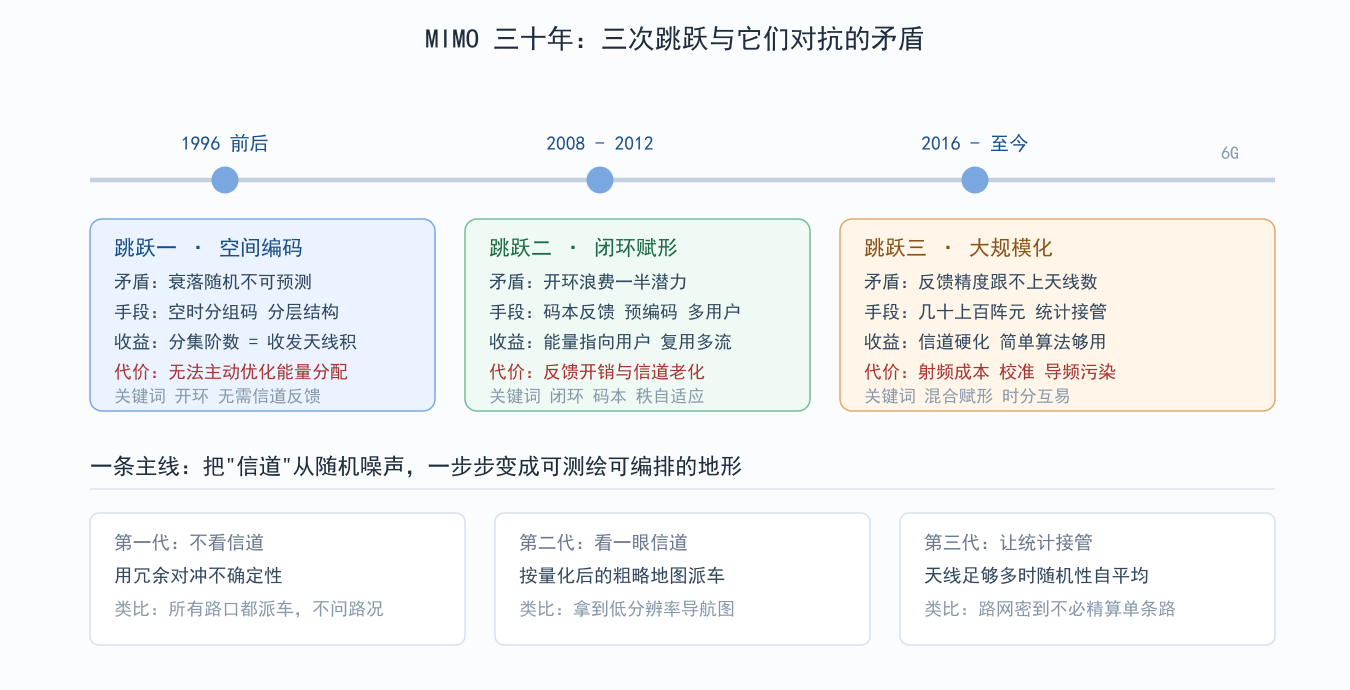
图 1-2:三次范式跳跃的时间线与驱动矛盾
二、跳跃一:用空间编码对抗随机性
第一代 MIMO 技术的处境很特殊:理论上知道空间里有多流可用,但发射端根本不知道信道长什么样。没有反馈通道,或者反馈太慢,怎么办?
空时分组码给出了漂亮的答案。以最经典的两发一收方案为例,两个符号在两个时隙里以特定的共轭与取负组合分别从两根天线发出,接收端做一次简单的线性合并就能同时恢复两个符号,且获得二阶分集。妙处在于它完全不需要发射端知道信道——编码结构本身保证了正交性。这种"不问路况也能跑"的性质,让它成为早期标准里最先落地的多天线技术。
代价也很清楚:它只买到了可靠性,没买到速率。两个时隙发两个符号,等效速率和单天线一样。
于是有了分层空时结构。思路直接得多:把数据分成几层,每层独立编码后从不同天线同时发出,接收端靠多天线联合检测把它们拆开。这一次速率真的翻倍了,代价是接收天线数必须不少于发射天线数——因为解方程需要方程数不少于未知数个数。这条约束至今没有变,它就是"自由度上限等于收发天线数较小者"的工程体现。
| 第一代方案 | 是否需要信道反馈 | 主要收益 | 硬约束 | 典型落地 |
|---|---|---|---|---|
| 空时分组码 | 不需要 | 分集,降低误码率 | 需要正交码结构 | 早期蜂窝下行两发 |
| 分层空时结构 | 不需要 | 复用,提升速率 | 接收天线数 ≥ 发射天线数 | 早期高速数据实验系统 |
| 接收端最大比合并 | 不需要 | 分集与信噪比 | 需要接收端信道估计 | 几乎所有系统的上行 |
三、跳跃二:闭环让能量有了方向
开环方案有个根本浪费:发射端把功率均匀撒向所有空间方向,而用户只在其中一个方向。这就像不知道客人坐哪桌,只好每桌都上一份菜。
第二次跳跃的核心动作是建立反馈通道。终端测量下行信道,从一本预先约定的码本里挑出最接近的那个预编码向量,把索引号报给基站;基站按这个索引加权发射。反馈的信息量很小——几个比特的索引而已,但效果显著:能量开始有方向,多流之间的干扰开始可控。
这条路线在标准里逐步长出完整的形态。早期版本先支持基础的开环与闭环发射模式,随后引入更完整的空间复用与多用户配对能力,天线端口数从 2 扩到 4 再到 8,反馈也从单一的宽带指示细化到子带级别。到了 5G 的第一个正式版本,码本被系统化为两类:一类走结构化的波束网格路线,粒度可配置、开销低;另一类允许对少数主导角度簇做精细刻画,开销高但精度显著提升。这两类码本的取舍,第 7 章会专门算账。
闭环的代价是信息新鲜度。反馈需要时间,而信道在变。终端以 60 km/h 移动、载波 3.5 GHz 时,信道相关时间只有几毫秒;如果反馈往返加处理耗时接近这个量级,基站拿到的就是过期地图。这个矛盾催生了两条应对路线:一是缩短反馈周期、增加参考信号密度,二是干脆放弃精确反馈、换一条完全不同的路——这就是第三次跳跃。
四、跳跃三:数量本身成为一种质变
当天线数从 8 推到 64、128 甚至更多,一件有趣的事发生了:信道的随机性开始自我平均。
数学上这是大数定律的直接后果。天线数足够多时,不同用户信道向量之间的内积趋近于零,也就是说它们自动变得近似正交;同时单个用户信道向量的模值方差急剧收缩,衰落变得"平稳"起来。前者叫伪正交性,后者叫信道硬化。它们合在一起带来一个工程上极其友好的结论:当阵列足够大,最简单的线性算法就接近最优。不需要复杂的非线性预编码,共轭转置加个归一化就够了。
这一步同时解决了闭环时代的反馈困境。因为在时分双工系统里上下行使用同一段频率,信道具有互易性——基站可以从终端发来的探测信号直接估计出信道,根本不需要终端反馈码本索引。天线数越多,这种"自己测"的方式相对"让终端报"的优势就越大。
新的账单也随之出现,而且很硬:
- 射频链路成本与功耗。如果每个阵元都配一条完整射频通路,128 阵元的基站在成本、体积、散热上都难以接受。工程上的解法是混合架构——少量数字通路驱动大量模拟相位器。
- 模数转换器的精度。高精度转换器功耗随采样率和位数急剧上升,单条链路数瓦级的功耗乘以上百条就不可承受。于是有了低精度量化的研究方向:能不能用 3 到 4 位分辨率换来数量级的功耗下降,代价是可接受的性能损失。
- 导频污染。相邻小区如果复用同一组导频序列,基站估出的信道会混入邻区用户的成分,导致波束指向被"拉偏"。这是大规模天线阵列最难缠的问题,第 6 章专门处理。
⚠️ 常见坑:把三次跳跃理解成后者替代前者。实际上现网是三代并存的——开环分集用于控制信道与高速移动场景,闭环码本用于中低速的数据信道,大规模阵列用于宏站覆盖与容量热点。判断一个方案好坏之前,先确认它服务的是哪一类信道和哪一类用户状态。
💡 关键直觉:每一次跳跃都在交换"需要多少信道知识"与"需要多少硬件"。第一代不要知识、要冗余;第二代要知识、省硬件;第三代要硬件、把知识需求压回去。三者构成一个可以往任意方向平移的三角,新技术往往只是在这个三角里换了个落点。
五、这条脉络怎么用
历史知识如果只能背,价值有限。真正有用的是把它当成分类器。
拿到任何一项新的多天线技术,先问三个问题:它需要多少信道知识(不需要 / 量化反馈 / 完整估计)?它假设的天线量级是多少(个位数 / 几十 / 上百)?它的收益写在哪一栏(可靠性 / 速率 / 覆盖)?三个答案一填,这项技术在三十年脉络里的位置就清楚了,它的隐含代价也基本可以预判。
举个例子:可重构智能表面这类近年的热门方向,需要对表面-用户信道有一定知识、阵元数量极大、收益主要写在覆盖与信道秩改善上——它本质上是第三次跳跃的延伸,因此可以预判它的主要难点会落在信道估计开销与校准上。这个预判后来基本被研究进展证实。
再看一个反例。有些方案宣称"不需要任何信道信息就能获得复用增益",这在信息论上就站不住:要把混在一起的多路数据分开,总得有一方知道混合方式。真实情况通常是知识被藏在别处——比如靠盲估计从数据本身反推,代价是需要更长的观测窗和更高的算力;或者靠预设的固定波束栅格,代价是与实际信道不匹配时性能骤降。用这三个问题去审视,宣传语里的水分很快就见底。
值得补一句历史的注脚:这三次跳跃在时间上并不整齐。第二代闭环技术在标准里成熟的同时,第三代的理论工作已经完成并等待硬件成本下降;而毫米波频段的商用又把第一代的开环思路重新捡回来用于初始波束搜索——因为在还没建立连接时,谁都不知道信道,只能靠遍历扫描。技术演进不是替换零件,更像地层堆叠,新层压住旧层,旧层依然承重。
一节小结
- 认知转向是起点:多径从需要抑制的干扰,被改判为可利用的自由度来源
- 第一代靠编码结构:空时分组码不需反馈即得分集,分层结构以"接收天线数不少于发射天线数"为硬约束换来速率
- 第二代靠反馈闭环:码本量化让能量有方向,代价是反馈开销与信道老化
- 第三代靠数量质变:信道硬化与伪正交让简单线性算法接近最优
- 时分双工的互易性在大规模阵列时代成为关键优势,绕开了反馈精度瓶颈
- 新账单是硬件与校准:射频链路成本、低精度量化、导频污染构成第三代的三大工程挑战
- 三代并存而非替代:控制信道用开环、数据信道用闭环、宏站容量用大规模阵列
- 把脉络当分类器:问信道知识需求、天线量级、收益归属三个问题,就能定位任何新技术
下一节把这三代技术沉淀下来的成果做一次横向切割:不看时间,只看它们各自兑现了哪一种增益,以及为什么这些增益不能同时拿满。