02-主从问答的工作模型
1.2 主从问答的工作模型
本节摘要:Modbus 的一切都建立在"一主多从、问一句答一句"上。本节讲清主站与从站的角色、单播与广播、轮询节奏、以及这个模型带来的天然限制(从站不能主动上报)。位置:1.1 讲清了进化史,本节讲清"它现在怎么工作"。
小周的第二个困惑:谁在说话
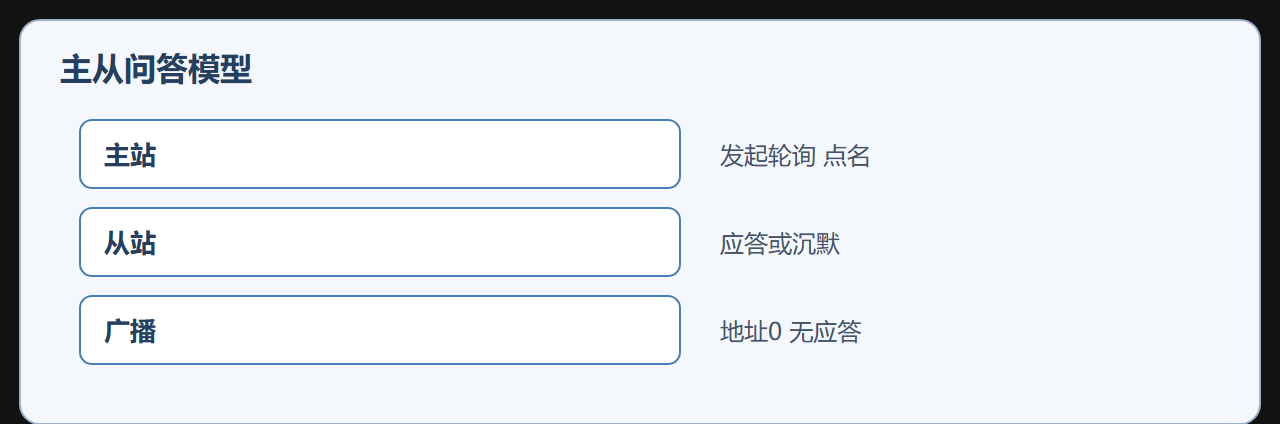
配电间里三十多台仪表,如果同时开口,信号会撞成一团。Modbus 的解法是立规矩:整条总线上只有一个主站(Master),其余都是从站(Slave)。主站通常是 PLC、工控机或网关;从站是变送器、电能表、驱动器。
通信永远由主站发起,从站只能应答。一次完整的问答长这样:
主站发送:地址(1B) + 功能码(1B) + 数据(NB) + 校验(2B) ↓ 等从站应答 从站应答:地址(1B) + 功能码(1B) + 数据(NB) + 校验(2B)
地址决定"这一句问谁":从站地址范围 1-247,地址 0 是广播(所有从站执行但不回话),248-255 保留。从站收到不是自己的地址就保持沉默——沉默也是一种协议行为,主站据此判断"这台设备没接上或已掉线"。
轮询:主站的节奏感
因为从站不会主动开口,主站只能挨个点名——这就是轮询(Polling)。主站维护一张轮询表:每台从站的地址、要读的寄存器、读取间隔。对实时性要求高的回路(如 PID 的测量值)轮得勤,对冷数据(如累计电量)轮得稀。
轮询周期的账要会算:假设总线上 30 台设备、每台读 2 个寄存器、波特率 9600,单次问答约 50-80ms,那么一圈轮询下来 1.5-2.4 秒——这就是为什么"仪表数据刷新不快"是物理约束而非软件 bug。想让刷新快,要么升波特率,要么批量读(第 6 章展开),要么拆总线。
单播与广播的边界
广播地址 0 最常见的用途是"同时写多台设备的同一种参数",比如产线切换时把所有变频器的使能位一起置位。广播的代价是没有应答——主站无法确认哪台执行成功。所以广播只适合"执行失败也能事后发现"的场合(如统一启动),不适合"必须确认"的关键写操作。
主从模型的三条天然限制
第一,从站不能主动上报。设备故障、报警、数据突变,都要等主站下一次轮询才被发现——报警实时性受轮询周期制约,这驱动了很多项目在 Modbus 之上另搭报警通道。第二,一主多从,双主互斥。两台设备都想当主站会抢总线,现场"两台触摸屏接同一条线"经常就是这么乱的。第三,从站地址必须唯一。两块表设成同一个地址,主站点名会收到"两个声音",即总线冲突。
问答模型的时间线:一次完整事务
把一次问答放到时间轴上,能看清三个关键时间参数:
主站发送请求帧(约 8-10 字节,9600 波特下约 9-11ms) ↓ 从站处理(内部固件解析,通常 <10ms) 从站返回响应帧(长度取决于数据量) ↓ 主站校验响应,登记数据,等待下一次轮询
Modbus 规范没有规定主站必须等多久——超时由主站软件决定。超时设短了,从站处理慢一点就误判超时重发;设长了,设备真掉线时发现得慢。工程经验值:串口 9600 波特下超时取 500ms-1s,TCP 下取 100-300ms(网络环境差异大,实际按抓包统计调整)。重试次数与退避:第一次重试后间隔翻倍,重试 3 次仍无响应则标记该从站离线,进入"慢轮询"(如 30 秒一次)而不是高频轰炸。
轮询表设计的三条原则
轮询表是主站软件的"日程表",设计得好坏直接决定系统实时性。三条原则:按刷新需求分组——高速回路(模拟量闭环)进快组(100-500ms 轮一次),慢变量(累计量、状态)进慢组(1-10s);批量优先——同一从站的多个连续寄存器合并成一次读(03 一次最多 125 个),比拆成十次快一个数量级;异常降频——从站离线后降为低频试探,避免死循环轰炸拖慢整条总线。
轮询表示例(简化): 组1(200ms):01# 读 40001-40004(实时值) 组2(1s) :01# 读 40006-40010(状态) 02# 读 40001-40004 组3(10s) :全部从站 读 累计量与诊断寄存器
主从模型的实时性边界
主从模型有个绕不开的物理限制:数据延迟 ≥ 轮询周期。从站报警要等主站点名才被发现;两台从站的数据不可能"同一瞬间"被读到(轮询有先后)。对需要毫秒级同步的多轴运动、安全联锁场景,Modbus 主从不是合适载体——那是 EtherCAT 之类同步总线的领域(第 9 章对比)。选型先问实时性需求:100ms 级够用,主从没问题;1ms 级,别碰主从。
易错点补充
- 多主站抢总线:两个 HMI 都配成主站会互相打断轮询,正确做法是只有一个主站,或加"主站仲裁"机制(多数现场直接禁止双主);
- 从站响应慢但主站超时短:老式仪表固件处理慢,超时 200ms 会频繁误判,先实测从站真实响应时间再定超时;
- 轮询与写操作混在一个线程:写操作(如设置参数)会阻塞轮询,建议读写分离线程或把写也纳入轮询表统一调度。
易错点清单
- 从站当主站用:有些仪表想"主动上报",Modbus 从站模型不支持,需要换主站角色或加网关;
- 广播写关键参数:广播无应答,写完后要再用单播读回校验;
- 轮询表不按优先级排:实时回路混在冷数据后面,报警才发现已经滞后,轮询表要按刷新需求分级。
要点回顾:一主多从、主问从答;轮询决定刷新率;广播无应答只宜作批量启动;从站不能主动上报是模型的硬边界。理解这套问答纪律后,下一节追它的身世:一个私有协议怎么变成开放标准。
实战复盘:凌晨两点的"偶发归零"
回到开篇场景。小周发现 3 号灌装线温度偶发归零,按主从模型的思路排查:归零 = 读到 0,而"读到 0"有两种可能——从站真的报了 0,或主站把"无响应"当 0 处理。抓包一看:从站对该轮询没有应答,主站软件在超时后把缓存清成 0 显示——问题出在主站把超时当成 0 值,而不是温度真的归零。
正确做法是区分三种状态:正常值(从站应答)、超时无应答(缓存保持旧值并标记"通信中断")、异常响应(记录异常码)。把"超时"与"数值 0"混为一谈,是工业 HMI 上"假报警、假归零"的经典来源。小周把主站软件改成"超时保持旧值 + 状态标记"后,偶发归零消失——真正的故障其实是总线上一台新接入的电表地址冲突导致偶发超时,两者叠加才让问题看起来像"温度传感器坏了"。
地址冲突的排查剧本
地址冲突(两台从站同一地址)的表现很典型:间歇性成功——两台设备交替应答,主站时而读到 A 的值时而读到 B 的值;读单点时"时对时错"。排查步骤:先把总线上其他设备全断开,只留一台,用调试器读它的设备标识寄存器(功能码 43/14 或厂商诊断寄存器)确认地址;再逐台接入,每接入一台读一次标识,直到出现冲突的那一台。给每台设备贴地址标签是防冲突的最朴素也最有效的办法。