01-字序与数据类型陷阱
6.1 字序与数据类型陷阱
本节摘要:Modbus 寄存器是 16 位字,而业务数据常是 32 位浮点、32 位整数、甚至字符串——跨寄存器拼装时的字序与字节序陷阱,是"报文正常但数据全错"的头号原因。本节给出完整的诊断方法与一个可复用的解析框架。位置:会读会写之后,本节解决"读回来怎么解释"。
从 16 位字到真实数据的三层拼装
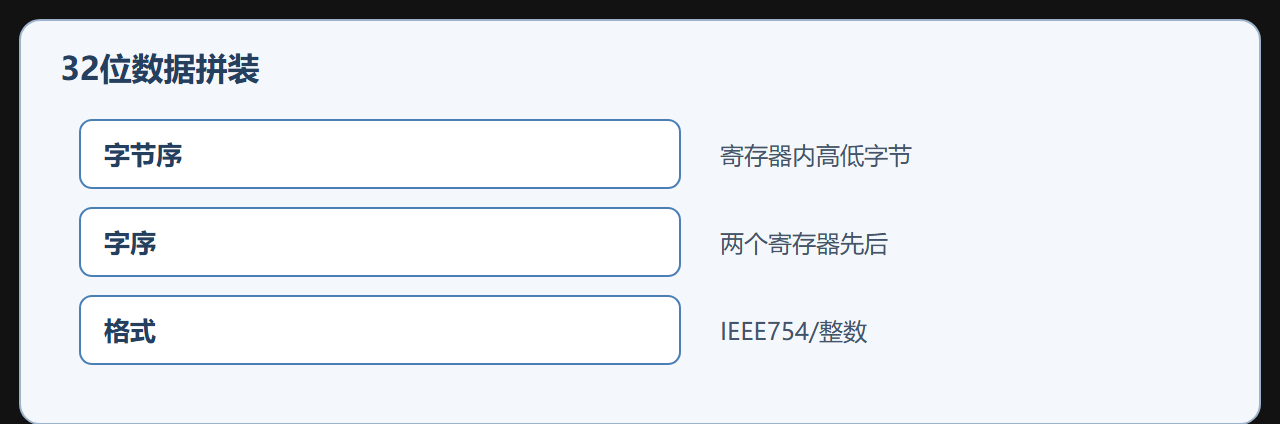
一个 32 位浮点占两个寄存器(4 字节),解析要过三层:字节序(每个寄存器内 2 字节谁先谁后)、字序(两个寄存器谁是高字)、格式(IEEE754 浮点、补码整数、无符号、还是 BCD)。三层各有两种可能,组合出 8 种排列——错一层,数值就错得"看似合理实则离谱"。
读回 4 字节(寄存器1 高字 + 寄存器2 低字):00 00 A0 41 按 A(大端字节+高字在前):0x0000A041 → 20.0625 按 D(小端字节+低字在前):0x41A00000 → 20.0 电表面板显示 20.0 → 该表是"小端 + 低字在前"
数据类型的速查表
| 类型 | 寄存器占用 | 解析要点 | 常见设备 |
|---|---|---|---|
| uint16/int16 | 1 | 补码有符号/无符号 | 状态、小数值 |
| uint32/int32 | 2 | 高字在前(Modbus 默认) | 累计量、计数器 |
| float32 | 2 | IEEE754,字序需实测 | 功率、温度、压力 |
| float64 | 4 | 罕见,需 4 寄存器 | 高精度计量 |
| 字符串 | N | ASCII,每寄存器 2 字符 | 设备标识、版本 |
工程默认值:多数欧洲设备遵循"大端字节 + 高字在前";不少亚洲设备"大端字节 + 低字在前";具体以手册"数据格式"为准。手册没写时用"已知值试解法"(读一个面板可见的值,8 种排列各解一次,合理的就是对的)。
一个可复用的解析函数
import struct def parse_regs(regs, fmt='>f'): # regs: [int, int] 两个寄存器值;fmt 见 struct 文档 raw = b''.join(struct.pack('>H', r) for r in regs) # 先按大端字打包 if fmt in ('>f', '<f'): # 浮点 return struct.unpack(fmt, raw)[0] return struct.unpack(fmt, raw)[0]
关键点:先把两个寄存器按各自字节序拼成原始字节流,再按格式解释。把"取字节"与"解释格式"分两步写,比直接拼数值直观得多,也更容易调试——打印 raw 的 hex 就能看到字节序问题。
一个现场坑案例
某光伏项目读逆变器日发电量(float32),程序按默认"大端+高字在前"解析,读数总是偏小且毫无规律。用面板值对照后确定该逆变器是"低字在前"。改一个参数后全站读数正确。复盘:厂商手册里"数据格式"一节明确写了"高字节在前、低字在前",是程序没读手册直接用了默认值。结论:先读手册的数据格式,再写解析代码;手册不明确的设备,用已知值试解确定。
易错点清单
- 把寄存器值直接相加拼浮点:正确做法是先还原字节流再解释,直接算数值会丢字节序信息;
- 默认值套所有设备:字序因厂商而异,每类设备单独确认;
- 解析代码无日志:解析结果异常时没有 raw hex 记录,无法回溯是采集错还是解析错,调试期必须打原始字节日志。
要点回顾:32 位数据 = 字节序 × 字序 × 格式三层拼装;默认大端高字在前,实测为准;先还原字节流再解释格式;手册没写就用已知值试解。数据类型搞定了,下一节把整条总线的性能账算清楚——轮询周期与批量读写。
各种设备的字序实测案例汇总
不同厂商设备的字序差异,用真实案例说话:某欧洲变送器(大端字节、高字在前)——按 Modbus 默认解析即可;某国产电能表(大端字节、低字在前)——32 位浮点要交换高低寄存器再解;某 PLC 转接模块(小端字节、低字在前)——整个字节流要反转;部分老式流量计甚至把 float32 拆成四个 16 位整数寄存器(非标准)。结论:没有任何"通用默认"能覆盖所有设备,每接入一类设备就做一次"已知值试解",并把结果写进设备配置档案。
字符串与 BCD 的特殊处理
除了数值,两类数据也常出问题:字符串(设备标识、版本号)——每个寄存器存 2 个 ASCII 字符,注意字符顺序(多数先存第一个字符在高字节);BCD 码(老式电表的电量、频率常以 BCD 表示)——每个半字节是一个十进制数字,0x1234 表示 1234 而非十六进制的 4660。把 BCD 当普通整数读是老表计对接最常见的错误,读出来数值莫名其妙地"每位数都对不上"。
解析层的单元测试怎么写
解析代码值得写单元测试,用例从真实抓包提炼:单寄存器(int16 正负、uint16 边界)、双寄存器(float32 已知值、int32 大数)、字符串(含空格与中文)、异常长度(设备返回长度不符的响应)。每个用例带原始字节与期望值,回归时跑一遍,设备换固件或解析库升级时能立刻发现字序变化——这比现场翻数据高效得多。
易错点补充
- 忽略负数表示:int16 的负数用补码,0xFFFF = -1 不是 65535,解析要按有符号处理;
- float32 精度陷阱:IEEE754 单精度约 7 位有效数字,超大累计量要用 int64 或双精度方案;
- 解析与采集日志脱节:日志里只记解析后的值,出问题时无法回溯原始字节,必须同时记录 raw hex。
现场问答
问:手册没写字序怎么办? 用"已知值试解":读一个面板可见的已知值,把原始字节按八种排列各解一次,落在合理范围的就是正确字序,然后把结论写进设备档案。
问:浮点能只读一个寄存器吗? 不能。float32 占两个寄存器,必须一次读整段(功能码 03 读 2 个寄存器),分两次读会拿到不同瞬间的高低字,拼出垃圾值。
问:解析代码要打原始字节日志吗? 要。只记解析值出问题无法回溯;原始 hex + 解析值成对记录,才能区分"采集错"与"解析错"。