5.1 强化学习训练环境构建实战
5.1 强化学习训练环境构建实战
本节摘要:把模型变成训练环境,本质是给引擎套一层「接口规范」:动作空间声明策略能控制什么、观测空间声明策略能看见什么、奖励函数声明什么算好、终止条件声明什么时候收场。四件套的每一件都有高频翻车点——语义错配、未来信息、奖励歧义、终止泄漏。本节按标准规范逐件拆解,配一个完整可跑的机械臂抵达任务环境,以及一份从实战里攒出来的踩坑清单。
前面四章的零件到齐,本节开始总装。环境封装是 RL 工程与物理引擎的交界处,也是「论文里三行伪代码、工程里三百行代码」落差最大的地方。
学习目标
阅读完本节,你应当能够:
- 按标准接口把任意 MuJoCo 模型封装成训练环境,四件套语义齐全;
- 执行环境自检三步:随机动作压测、重置一致性检查、时序对齐验证;
- 识别本节列出的六类环境 bug,并知道每类的典型症状与修复。
一、四件套:环境的法律框架
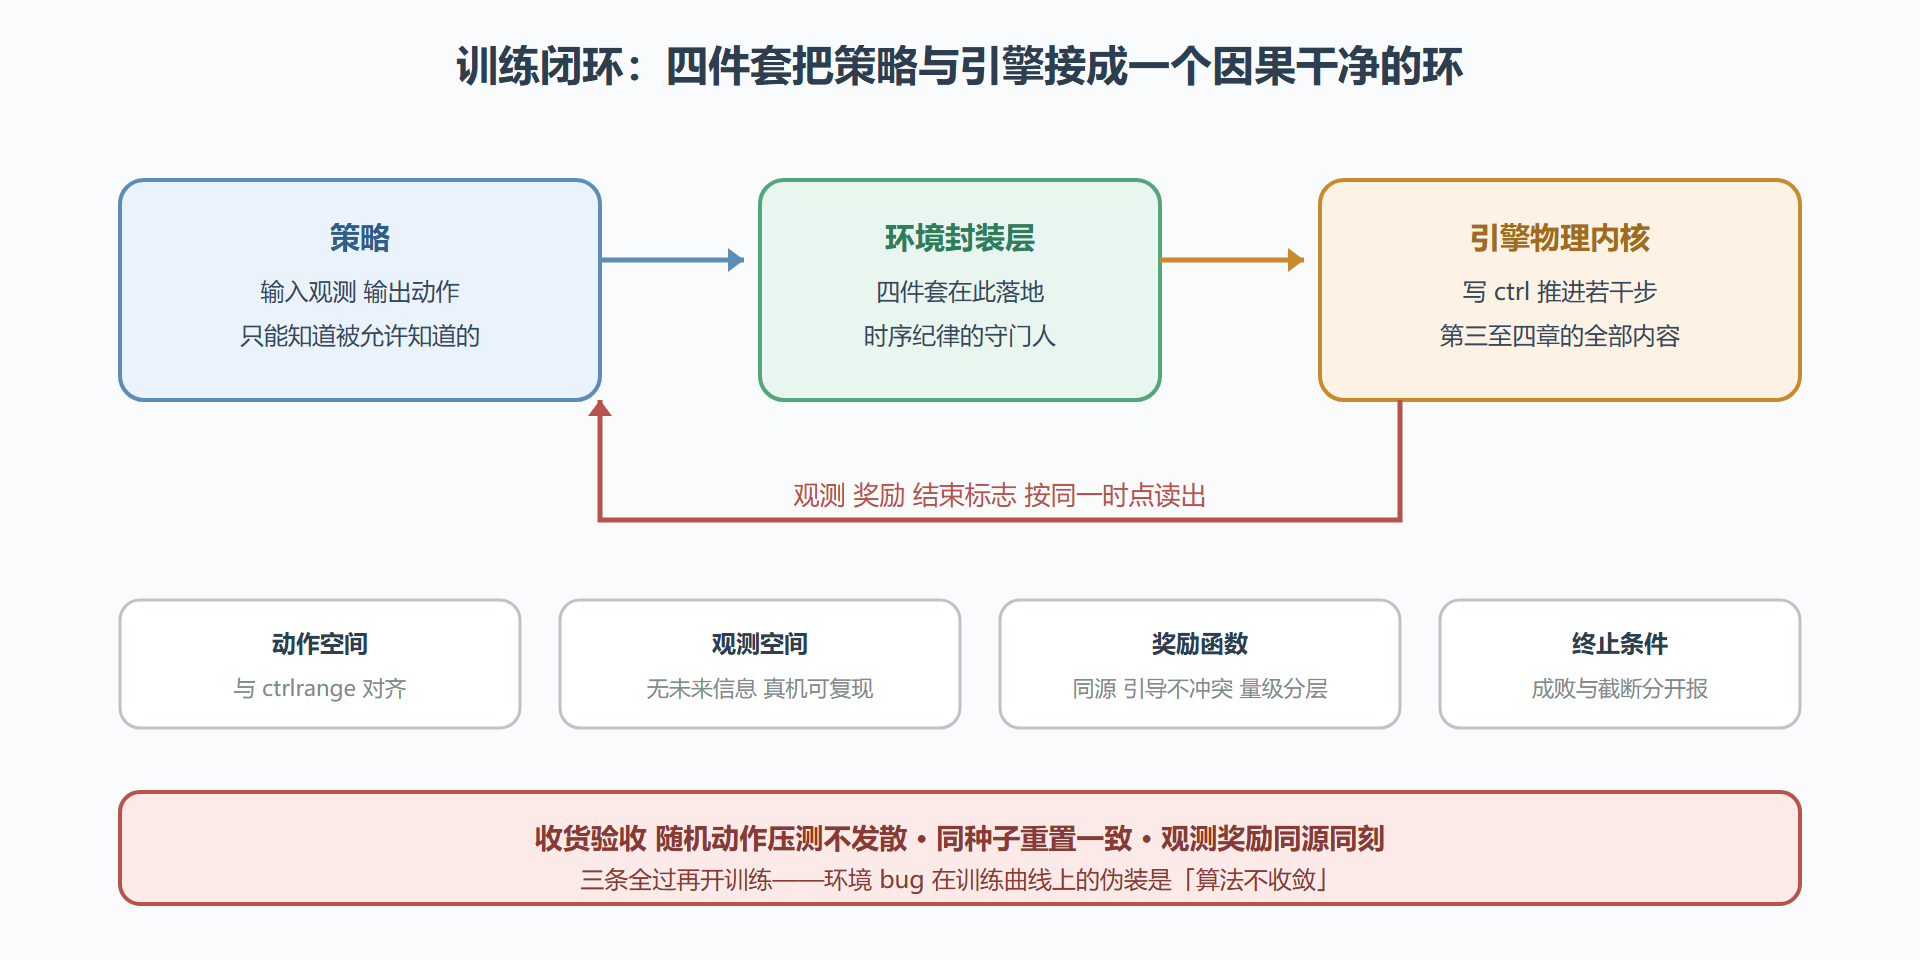
动作空间:策略能动的手柄。 技术上是向量范围声明,语义上是执行器契约(2.3 的老话题在这里收账):motor 执行器配连续力矩区间、position 执行器配目标角度区间,区间值直接抄 ctrlrange。两个高频错配——区间与 ctrlrange 不一致(策略输出的合法值被引擎静默截断,训练信号失真)、该离散的任务用了连续空间(按键、档位类控制)。一个忠告:动作维度能省则省,每个无谓维度都是给探索浪费的预算。
观测空间:策略的眼睛。 物理层原料是 qpos、qvel、sensordata 与接触信息(3.4 与 3.5 的字段),封装层要做的决策是「给策略看什么、怎么归一化」。两条红线:观测里不许有未来信息——用「本步动作执行后」的状态奖励「本步」的动作,策略学到的是上帝视角,部署即穿帮;观测须可复现于真机——仿真里给策略看了真机没有的传感器(比如完美速度读数),迁移时观测分布直接错位。5.3 会把这条红线升级成方法论。
奖励函数:策略的价值观。 工程上最考验设计 taste 的一件。机械臂抵达任务的经典配方是「稀疏成功奖加密集引导项」:到达目标给大奖励,距离与姿态误差给小的负引导,控制量给能量惩罚。设计原则有三——奖励必须只依赖「当步观测与动作」(同源红线,3.5 讲过);引导项的梯度方向不能与真目标冲突(引导策略「贴着桌面滑过去」,奖励多漂亮都白搭);量级要拉开档次(成功与失败的差距必须盖过噪声项的抖动)。
终止条件:回合的收场规则。 三类常规收场——成功(触达目标)、失败(超时、掉落、关节失控)、截断(步数上限)。坑在「终止泄漏」:把截断当失败处理,策略会学出「避免任何长任务」的保守倾向,因为活得久反而挨罚。标准规范里成功与失败回「终止」信号、纯计时截断回「截断」信号,两者在算法侧待遇不同,封装时别偷懒合并。
二、一个完整环境:从代码到自检
把四件套放进一个五十行的完整实现,目标是「机械臂末端抵达空间中一个随机目标点」:
import mujoco import numpy as np class ReachEnv: def __init__(self): self.model = mujoco.MjModel.from_xml_path("arm6_reach.xml") self.data = mujoco.MjData(self.model) self.step_dt = 0.02 # 物理五步合一个决策步 self.max_steps = 100 def reset(self, rng): mujoco.mj_resetData(self.model, self.data) # 关节角从关键帧附近随机扰动,防策略只会单一初始 self.data.qpos[:] += rng.uniform(-0.1, 0.1, size=self.model.nq) # 目标点在可达球壳内均匀采样 self.target = np.array([0.4, 0.0, 0.35]) + rng.uniform(-0.1, 0.1, 3) mujoco.mj_forward(self.model, self.data) return self._obs() def _obs(self): ee = self.data.site("tool").xpos return np.concatenate([self.data.qpos, self.data.qvel, ee - self.target]) # 误差项放观测,显式给方向 def step(self, action): self.data.ctrl[:] = action for _ in range(5): mujoco.mj_step(self.model, self.data) ee = self.data.site("tool").xpos dist = np.linalg.norm(ee - self.target) reward = -dist - 0.001 * np.sum(action ** 2) # 引导加能量罚 success = dist < 0.02 self._t += 1 terminated = success truncated = self._t >= self.max_steps return self._obs(), reward, terminated, truncated
这段骨架的每个细节都对应前文的某条纪律:决策步与物理步解耦(3.3)、奖励只读当步状态(3.5)、重置带随机化(本节)、误差向量进观测(信息给足)。写完不等于能用,跑三步自检:
rng = np.random.default_rng(0) env = ReachEnv() # 自检一:随机动作压测,奖励不应爆炸、状态不应发散 obs = env.reset(rng) for i in range(500): obs, r, term, trunc = env.step(rng.uniform(-0.3, 0.3, size=7)) assert np.all(np.isfinite(obs)) and np.isfinite(r) if term or trunc: obs = env.reset(rng) print("随机压测通过") # 自检二:重置一致性,同种子同序列 a = env.reset(np.random.default_rng(42)) b = env.reset(np.random.default_rng(42)) assert np.allclose(a, b) print("重置一致性通过")
随机压测防「控制量稍大就数值发散」(发散的环境会毒化探索),重置一致性防「隐藏状态泄漏」(两次重置结果不同说明有成员变量没清干净——训练可复现性的地基)。
图 5-1 训练闭环:环境四件套挂在引擎流水线上的位置
三、实战踩坑清单:六类环境 bug
从无数失败训练里蒸馏出的六类高频 bug,症状直接可对照:
- 观测含未来:训练 curve 华丽、部署稀烂。查法:冻结策略逐帧比对「观测时刻」与「动作效果时刻」。
- 奖励观测不同源:策略学出「抽搐式试探」,奖励忽高忽低无规律。查法:打印奖励与观测的时间戳差。
- 重置不随机:策略只在特定起点能干活的「刻舟求剑」现象。查法:换二十个种子评估,方差异常即中招。
- 截断当失败:策略越练越「保守拖延」。查法:对比成功回合与截断回合的平均回报结构。
- 动作区间错配:策略输出常年顶格、执行器饱和。查法:统计动作分布,看是否大面积贴边。
- 隐藏状态泄漏:跨回合行为莫名相关。查法:重置一致性自检,或对全部成员变量做清点。
这六条的共性是「bug 在环境层,症状在算法侧」,所以排查顺序永远是先环境后算法——这也是本章安排在算法讨论之前的原因。
本节要点回顾
- 四件套即契约:动作对齐执行器语义、观测无未来且真机可复现、奖励同源且引导不冲突、截断与失败分开报;
- 代码骨架可迁移:决策步解耦物理步、误差向量进观测、重置带扰动,三个惯例直接抄;
- 自检三步:随机压测、重置一致性、同源性验证,训练前必做;
- 六类 bug 先查环境:症状在训练曲线,病根在封装层,排查顺序不可颠倒。
环境就绪后,另一条路线的人该上场了:不训策略,而是把引擎当内部模型做控制。下一节看模型预测控制与轨迹优化怎么接进来。