5.2 机器人控制与规划:从MPC到轨迹优化
5.2 机器人控制与规划:从 MPC 到轨迹优化
本节摘要:不走学习路线的控制任务,引擎同样是核心资产:模型预测控制把 mj_forward 当「未来推演器」,在滚动时域里反复求解小规模优化;轨迹优化离线算出整条参考轨迹,控制器在线跟踪。本节讲两条路线的接入方法、参数设置的工程依据,以及它们与 RL 路线的选择逻辑——任务结构清晰时,经典控制的样本效率与可解释性仍是难以替代的。
5.1 的环境四件套是为「策略来决策」准备的;本节换一位决策者——基于模型的优化求解器。它不采样、不试错,而是直接利用引擎的动力学模型推演未来、择优而行。这条路线上 MuJoCo 的价值恰好落在第三章反复强调的两个性质上:求解快(推演便宜)且可微(梯度可得)。
一、模型预测控制在引擎里的位置
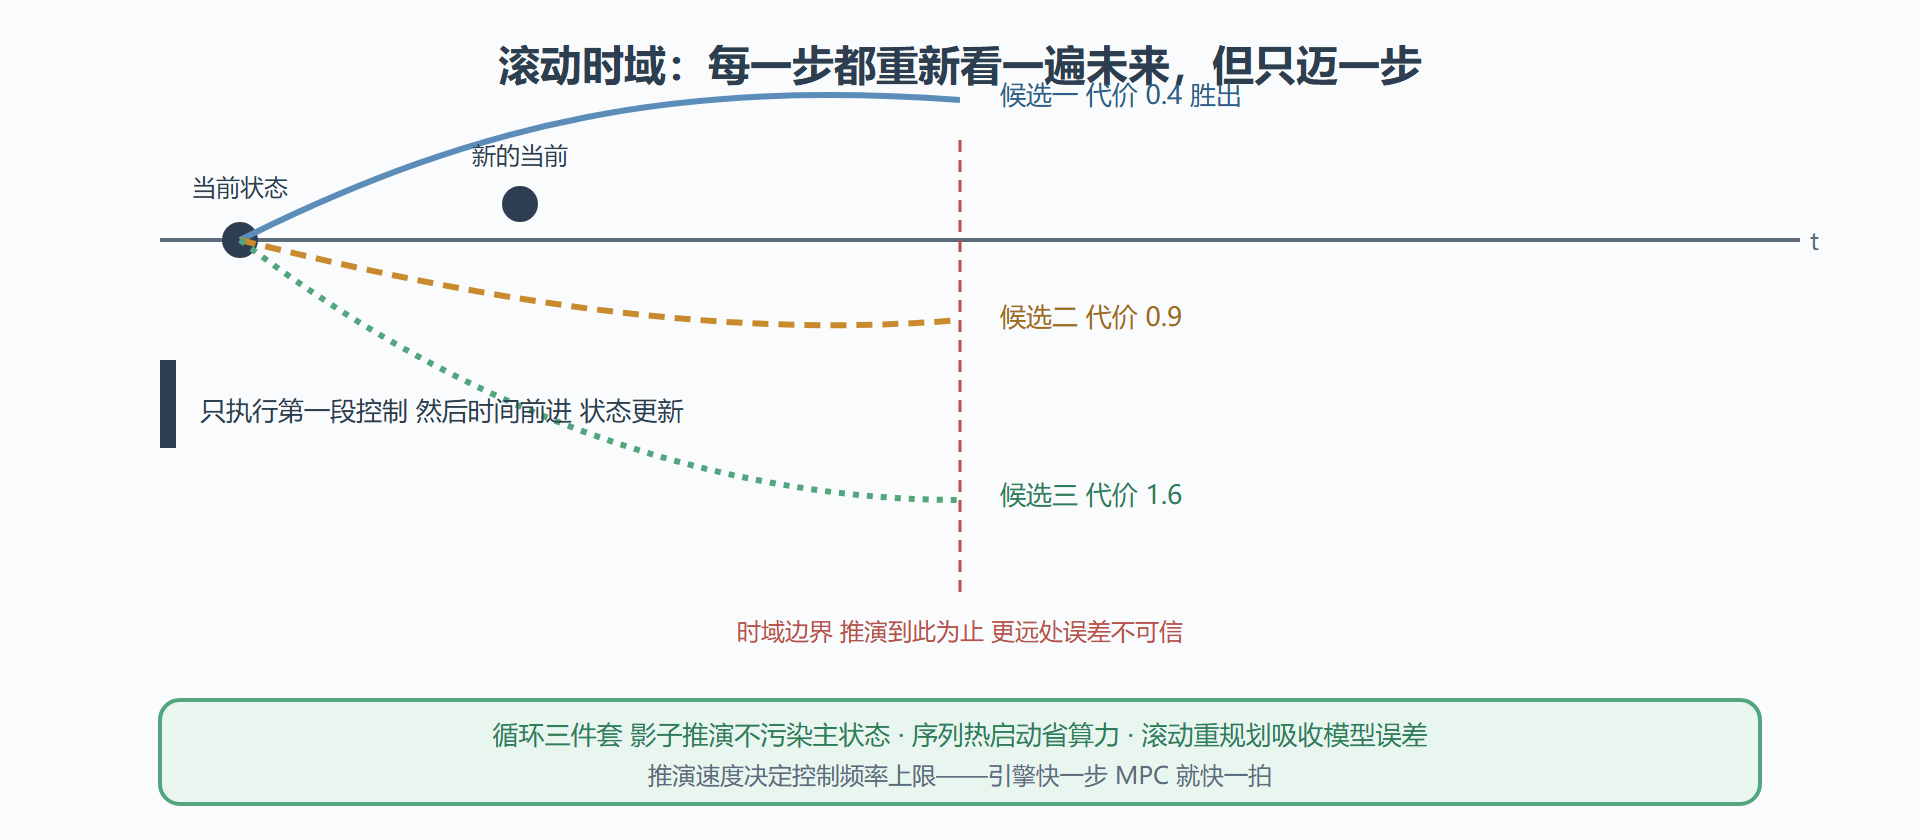
MPC 的直觉一句话:每一步都用模型往前推演 N 步,在推演出的若干条未来里挑代价最小的一条,只执行它的第一个控制量,然后挪到新状态重来。它是「走一步看三步」的滚动优化,引擎在其中扮演的角色是被反复调用的未来推演器——每次决策要做 N 次或更多次 forward 推演,推演速度直接决定控制频率上限(3.1 卖过的「单环境快」在这里兑现)。
接入一个最小 MPC 需要 three pieces:引擎模型(推演器)、代价函数(好未来与坏未来的定义)、搜索或优化器(怎么找好未来)。最容易上手的形态是采样式 MPC——在控制量空间随机撒一把候选序列,逐条推演评分,选最优执行:
import mujoco import numpy as np model = mujoco.MjModel.from_xml_path("arm6.xml") data = mujoco.MjData(model) target = np.array([0.35, 0.1, 0.30]) # 末端目标 def rollout_cost(action_seq): """推演一条候选控制序列,返回代价""" trial = mujoco.MjData(model) # 影子账本,不污染主状态 trial.qpos[:] = data.qpos # 从当前真实状态出发 trial.qvel[:] = data.qvel cost = 0.0 for k in range(len(action_seq)): trial.ctrl[:] = action_seq[k] mujoco.mj_step(model, trial) ee = trial.site("tool").xpos cost += np.sum((ee - target) ** 2) # 任务代价 cost += 0.01 * np.sum(action_seq[k] ** 2) # 控制能量代价 return cost rng = np.random.default_rng(1) H, K = 8, 128 # 时域八步、候选一百二十八条 best_seq = rng.uniform(-0.2, 0.2, size=(H, model.nu)) while data.time < 3.0: # 带漂移的采样式 MPC:围绕当前最优扰动采样,逐代收窄 for gen in range(3): cand = best_seq + rng.normal(0, 0.1, size=best_seq.shape) cand = np.clip(cand, -0.5, 0.5) costs = np.array([rollout_cost(c) for c in cand]) best_seq = cand[np.argsort(costs)[:8]].mean(axis=0) data.ctrl[:] = best_seq[0] # 只执行第一个控制量 mujoco.mj_step(model, data) best_seq = np.roll(best_seq, -1, axis=0) # 序列前滚,热启动下一轮
代码里三处工程要点:影子推演用独立的 MjData(3.4 的影子仿真模式),主状态不被候选污染;热启动把上一轮最优序列滚动复用,MPC 每步都从近似解出发微调,这是实时性的关键;只执行第一步后立即重规划,模型误差随推演深度累积,滚动重规划天然吸收了误差。
二、参数设置的工程依据
MPC 调参三件事,各有一条可依循的逻辑:
时域 N:覆盖「一个完整动作单元」再加裕度。抵达任务取二百到五百毫秒;周期性摆动任务至少盖过一个整周期。时域翻倍,推演开销线性翻倍——预算与时域永远在拔河。
控制频率:由推演延迟反推。每次决策花五毫秒,控制频率顶天二百赫兹,留一半余量取一百赫兹更稳。频率低不是灾难——真实控制器本来就慢于物理步,3.3 的解耦原则同样适用于此。
代价权重:与 RL 奖励同源的哲学,但 MPC 的代价还会通过梯度影响搜索方向,权重失谐的症状是「代价降了、动作狂野」。能量惩罚项不是装饰,它压住的是搜索器钻「高速甩动捷径」的空子。
图 5-2 MPC 滚动时域:推演、评分、执行一步、重规划
三、轨迹优化:离线算全程,在线轻跟踪
MPC 是「边走边想」,轨迹优化是「出发前把整条路想清楚」:给定起末状态,优化出满足动力学、避开障碍、代价最小的完整轨迹,然后交给在线控制器跟踪。两者的分工像即兴演奏与排练过的曲目——前者应对变化,后者追求全局最优。
引擎在这条路线里的身份是「轨迹合法性的裁判」:优化器给出的候选轨迹要过引擎验证——逐点做逆动力学(3.1 的接口在此兑现)检查力矩是否在执行器能力内、逐段 forward 确认不穿模。某装配项目的流程值得参考:轨迹优化器输出初步轨迹,引擎逆动力学筛掉力矩超限段,局部重优化两轮,得到一条「全程可行」的参考线,最终真机上以位置伺服跟踪通过。这条路线上引擎不当决策者,当验收员——但它把「优化器给的轨迹到底能不能执行」这个最容易翻车的问题,在仿真里提前拦下。
与 RL 的选择逻辑可以压成一张决策表:
| 维度 | MPC / 轨迹优化 | 强化学习 |
|---|---|---|
| 需要的模型精度 | 高(直接当内部模型) | 中(域随机化兜底) |
| 任务结构 | 目标与约束清晰 | 目标好定义、结构可模糊 |
| 部署前的准备 | 建模加调参,天级 | 训练加调参,周级 |
| 出问题时的解释 | 代价项与约束逐条可查 | 归因常要靠消融实验 |
| 强项场景 | 结构化操作、装配、跟踪 | 接触 rich、难建模、高维 |
我的取舍建议按任务对号:目标明确、动力学清楚的 structured 任务先试 MPC,一两天内通常可用;接触密集、建模困难、或需要「涌现技巧」的任务上 RL;两者不互斥——RL 策略负责抓取接触阶段、MPC 负责无接触转移阶段的混合架构,在装配类任务里越来越多见。
四、一条混合路线的实战记录
把混合架构展开成案例。背景:桌面上随机位置的小零件抓取加精准插入插槽,纯 MPC 卡在抓取段(接触预测太贵且不准),纯 RL 卡在插入段(毫秒级对准精度要求策略有超细粒度控制)。操作:切阶段——接近与抓取段用 RL 策略(观测:零件相对位姿;动作:位置伺服目标),抓稳后交棒 MPC(代价:末端路径代价加姿态约束,推演时零件按已抓固连处理)。结果:阶段切换的设计点是「抓取力确认信号」——力传感器读数连续若干步超过阈值即交棒,仿真成功率百分之九十一。解读:混合的关键不是两个模块各干各的,而是交棒协议——状态定义对齐、力确认防误交棒、 MPC 初始状态从策略末状态无缝衔接。变式:没有力传感器的场景,用观测置信度做交棒判据;插入精度要求更高的场景,交棒后再加一层高频率小步骤的 MPC 精调段。
本节要点回顾
- 引擎当推演器:MPC 的控制频率上限由 forward 速度决定,采样式 MPC 是最容易落地的形态;
- 三件工程要点:影子推演、序列热启动、滚动重规划,代码骨架直接抄;
- 轨迹优化要裁判:逆动力学筛力矩、forward 验可行,引擎把关候选轨迹的「可执行性」;
- 路线选择:结构清晰先 MPC(天级可用),接触 rich 上 RL(周级训练),混合架构抓大放小;
- 交棒协议是混合的灵魂:状态对齐、确认信号、无缝衔接,比两个模块本身更重要。
无论哪条路线,产物最终都要面对同一道坎:仿真里练出来的本事,到现实里还算不算数。下一节正面回答 Sim-to-Real。